들어가며: 왜 트랜스포머는 작은데도 똑똑할까
GPT 같은 거대 언어모델의 핵심 구조인 트랜스포머(Transformer)는 왜 RNN이나 기존의 논리식보다 훨씬 효율적으로 느껴질까요? 보통은 "데이터가 많아서", "병렬 학습이 잘 돼서" 같은 공학적 이유를 떠올리지만, ICLR 2026에서 Outstanding Paper로 선정된 논문 "Transformers are Inherently Succinct"(arXiv:2510.19315)는 전혀 다른 각도에서 답합니다. 트랜스포머는 수학적으로, 즉 순수한 논리·오토마타 이론의 관점에서도 "같은 것을 말하는 데 훨씬 적은 글자 수만 있으면 되는" 구조라는 것입니다(출처: arXiv:2510.19315).
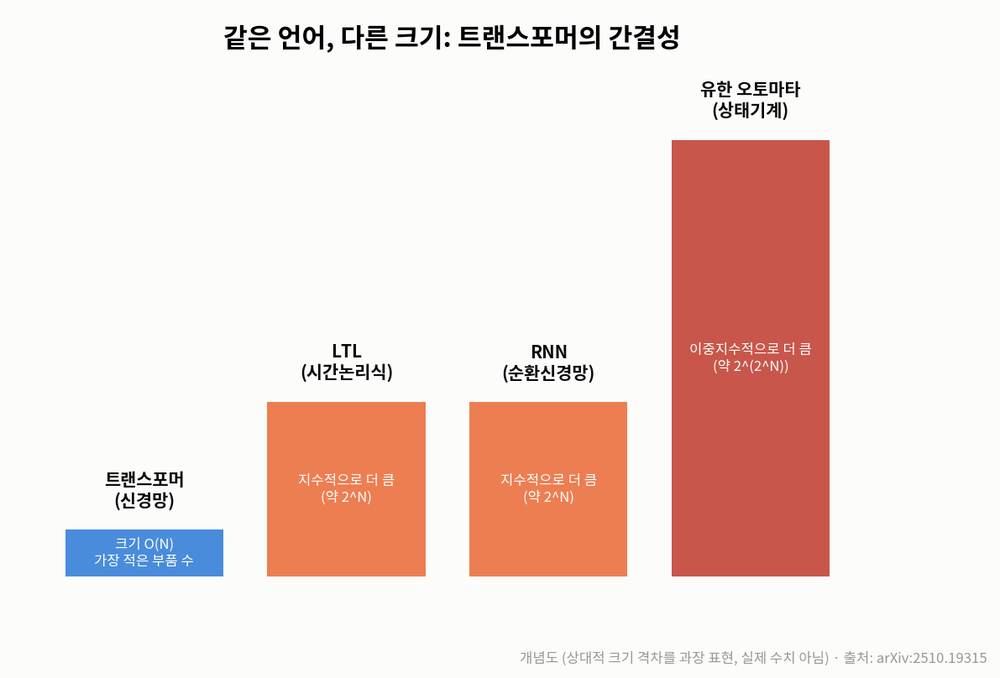
이 논문은 실험 논문이 아니라 이론(형식언어/오토마타 이론) 논문입니다. 저자들은 트랜스포머, LTL(선형시간논리), RNN(순환신경망), 유한 오토마타라는 네 가지 서로 다른 "언어를 표현하는 방법"을 놓고, 같은 언어를 표현하는 데 각각 얼마나 많은 "부품 수"가 필요한지를 비교합니다. 결과는 트랜스포머가 LTL이나 RNN보다 지수적으로(exponentially), 유한 오토마타보다는 이중지수적으로(doubly exponentially) 더 간결할 수 있다는 것입니다(출처: arXiv:2510.19315).
"간결성(succinctness)"이란 정확히 무엇인가
먼저 용어를 짚어야 합니다. 이 논문이 다루는 "표현력(expressive power)"과 "간결성(succinctness)"은 다른 개념입니다. 표현력은 "이 방법으로 어떤 언어들을 표현할 수 있는가"를, 간결성은 "같은 언어를 표현하는 데 얼마나 적은 크기(부품 수)가 필요한가"를 묻습니다(출처: arXiv:2510.19315).
비유하면, 같은 규칙을 한 사람은 책 한 페이지로, 다른 사람은 백과사전 한 권으로 설명한다면 둘 다 정확히 설명할 수 있어도(표현력은 같아도) 간결성은 전혀 다릅니다. 이 논문의 핵심 주장은, 트랜스포머가 인식할 수 있는 언어의 범위는 꽤 제한적인 편(이른바 "서브정규언어")임에도, 그 제한된 범위 안에서는 다른 형식들보다 압도적으로 짧게 규칙을 적을 수 있다는 것입니다(출처: arXiv:2510.19315). 이것이 트랜스포머가 현실에서 강력하게 작동하는 이유 중 하나일 수 있다고 저자들은 제안합니다.
핵심 트릭: "이중지수 크기의 카운터"를 몰래 숨겨놓기
그렇다면 트랜스포머는 어떻게 이런 압축 마법을 부릴 수 있을까요? 논문이 밝히는 핵심 기술적 장치는, 트랜스포머의 어텐션(attention) 메커니즘을 이용하면 다항식(polynomial) 크기의 네트워크만으로도 2의 2의 N제곱(2^(2^N))까지 셀 수 있는 "이중지수 카운터"를 구현할 수 있다는 사실입니다(출처: arXiv:2510.19315).
직관적으로 풀어보면 이렇습니다. "0부터 100만까지 세는 기계"를 만들 때, 가장 단순한 방법은 100만 개의 서로 다른 상태(스위치 위치)를 두는 것입니다 — 유한 오토마타가 이런 방식입니다. 반면 이진수로 세면 20개 비트만으로도 100만 이상을 셀 수 있습니다. 어텐션은 한 걸음 더 나아가, 포지션들 사이 점수를 비교해 "가장 점수가 높은 위치"를 골라내는 연산을 반복적으로 쌓아 이진수 비트가 몇 번째 자리에서 뒤집혔는지를 검증하는 방식으로 카운터의 "올바른 증가"를 확인합니다. 이런 검증 레이어를 여러 겹 쌓으면 각 레이어가 한 단계씩 더 큰 지수 범위를 떠받치게 되어, 레이어 수(네트워크 크기)는 다항식으로만 늘어나는데 표현 가능한 수의 범위는 이중지수적으로 폭발합니다(출처: arXiv:2510.19315).
이 아이디어를 증명에 실제로 쓰기 위해, 저자들은 타일링 문제(tiling problem)에 기반한 "증인 언어(witness language)"를 구성합니다. 쉽게 말해 바둑판 같은 격자를 정해진 규칙에 맞게 타일로 채우는 문제를 떠올려보면, 크기가 N인 문제 설명만으로도 실제 격자 크기는 2^(2^N)까지 커질 수 있습니다. 논문은 이런 "조건을 만족하는 타일 배치"를 정확히 인식하는 언어를 설계한 뒤, 이를 인식하는 트랜스포머는 크기 O(N)으로 충분하지만, 이 언어를 받아들이는 가장 짧은 문자열의 길이 자체가 이미 2^(2^N)에 달한다는 점을 보입니다(출처: arXiv:2510.19315). 반면 이렇게 "거대한 문자열 구조"를 LTL 논리식이나 유한 오토마타로 똑같이 표현하려면 지수적·이중지수적으로 큰 크기가 필요합니다. 정리하면, 트랜스포머로는 크기 O(N)이면 충분한 언어가 LTL로는 약 2^N, 유한 오토마타로는 약 2^(2^N) 규모가 필요해진다는 것입니다(출처: arXiv:2510.19315). 다만 위 N 및 구체적 함수 형태는 핵심 구조를 단순화해 전달한 것으로 "실제 수치 아님, 개념도"에 해당합니다.
흥미로운 것은 이 비교가 일방통행이 아니라는 점입니다. 트랜스포머가 표현할 수 있는 언어의 "종류" 자체는 RNN이나 유한 오토마타보다 오히려 좁을 수 있습니다(서브정규언어에 속함). 하지만 "그 좁은 범위 안에서 얼마나 짧게 쓸 수 있는가"를 따지면 트랜스포머가 압도적으로 유리하다는 것이, 이 논문이 강조하는 "표현력과 간결성은 다른 축"이라는 메시지의 핵심입니다(출처: arXiv:2510.19315).
트랜스포머 → LTL 변환: 이중지수에서 지수로 줄인 성과
이 논문은 "격차가 크다"는 부정적 결과만 보여주는 것이 아니라 긍정적인(constructive) 결과도 제시합니다. 기존 연구에서는 임의의 트랜스포머를 동치인 LTL 논리식으로 변환하려면 이중지수적인 크기 폭발이 불가피하다고 알려져 있었습니다. 이 논문은 더 정교한 변환 절차를 통해, 고정 정밀도 트랜스포머를 LTL 논리식으로 바꾸는 데 지수적인 크기 증가만으로 충분하다는 것을 증명합니다(출처: arXiv:2510.19315). 한 단계의 지수를 걷어낸 셈인데, 이는 트랜스포머의 동작을 사람이 읽을 수 있는 논리식으로 번역해 해석·검증하려는 해석가능성(interpretability) 연구에도 실질적 의미를 가집니다.
그 대가는? 검증 문제는 "사실상 풀 수 없다" — EXPSPACE-완전
간결함에는 대가가 따릅니다. 이 논문의 또 다른 축은 트랜스포머에 대한 기본적인 검증(verification) 문제의 계산 복잡도를 분석하는 것입니다. 구체적으로 공허성 검사(emptiness checking: "이 트랜스포머가 받아들이는 입력이 하나라도 있는가?")와 동치성 검사(equivalence checking: "두 트랜스포머가 정확히 같은 언어를 인식하는가?") 문제를 다룹니다.
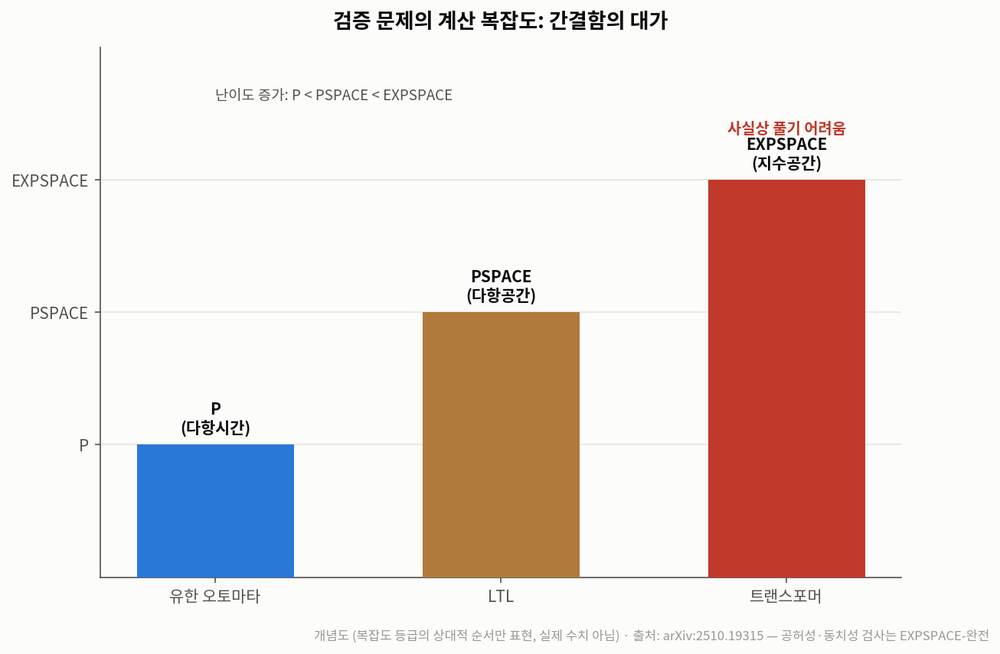
논문은 이 두 문제가 EXPSPACE-완전(EXPSPACE-complete)임을 증명합니다(출처: arXiv:2510.19315). EXPSPACE는 계산 복잡도 이론에서 "지수적인 크기의 메모리 공간이 필요한 문제들의 집합"을 가리키는 매우 높은 복잡도 등급입니다. 비교하자면, 같은 검증 문제가 유한 오토마타에서는 다항 시간(polynomial time)에 풀리는 "쉬운" 문제이고, LTL에서는 PSPACE(다항 공간) 수준으로 다소 어렵지만 여전히 다룰 만한 문제입니다. 그런데 트랜스포머에서는 EXPSPACE, 즉 한 단계 더 높은 난이도로 뛰어오릅니다(출처: arXiv:2510.19315).
쉽게 말하면, "이 트랜스포머가 특정 입력을 절대 받아들이지 않는다는 것을 완벽히 증명해줘" 같은 질문에서, 입력 크기가 조금만 커져도 필요한 계산 자원이 두 단계나 겹친 기하급수적으로 폭증한다는 뜻입니다. 현실적인 크기의 모델을 일반적인 알고리즘으로 완전히 검증하는 것은 사실상 불가능에 가깝다는 의미이며, 이는 앞서 설명한 "놀라운 간결성"이 치르는 대가라고 저자들은 해석합니다 — 정보를 극도로 압축해 표현할수록, 그 압축을 풀어 "모든 경우"를 확인하는 절차는 역설적으로 훨씬 더 커질 수밖에 없습니다(출처: arXiv:2510.19315).
한계와 의의: 이론이 말해주는 것, 말해주지 않는 것
이 결과들은 모두 "고정 정밀도(fixed-precision) 트랜스포머"라는 이상화된 수학적 모델에 대한 증명입니다. 실제 GPT 계열 모델이 이 극단적인 간결성 격차를 실제로 활용하는지, 학습 과정에서 비슷한 구조를 자연스럽게 습득하는지는 이 논문의 범위를 벗어나는 별도의 질문입니다. 또한 트랜스포머가 인식 가능한 언어 자체가 서브정규언어로 제한된다는 점도 함께 고려해야 균형 잡힌 해석이 가능합니다(출처: arXiv:2510.19315).
그럼에도 시사점은 분명합니다. 첫째, 트랜스포머의 효율성을 "표현력"이 아니라 "간결성"이라는 다른 수학적 잣대로 설명할 수 있다는 새로운 관점을 열었습니다. 둘째, 트랜스포머를 LTL로 변환하는 절차를 한 단계 더 효율적으로(이중지수 → 지수) 개선해 해석가능성 연구에 실질적 도구를 제공했습니다. 셋째, 공허성·동치성 같은 기본 검증 문제가 EXPSPACE-완전이라는 사실로, 트랜스포머 기반 시스템의 완전한 형식 검증(formal verification)이 이론적으로 얼마나 어려운지 명확히 못 박았습니다(출처: arXiv:2510.19315).
정리하며
트랜스포머가 강력한 이유를 둘러싼 논의는 보통 데이터, 연산량, 병렬성 같은 공학적 요인에 머무르곤 합니다. 이 논문은 그 바깥에서, 순수하게 논리학과 오토마타 이론의 언어로 "트랜스포머는 원래 압축에 유리한 구조"라는 사실을 엄밀하게 증명합니다. 어텐션 메커니즘이 숨겨둔 이중지수 카운터라는 트릭 하나가 LTL·RNN 대비 지수적, 유한 오토마타 대비 이중지수적인 간결성 우위로 이어지고, 그 대가로 공허성·동치성 검사는 EXPSPACE-완전이라는 벽에 부딪힙니다. ICLR 2026 Outstanding Paper로 선정된 이유가 납득되는, 트랜스포머의 본질을 다시 생각하게 만드는 이론 논문입니다.
댓글