200번째 논문 리뷰, 벡터 그래픽으로 마무리하다
이번 글로 딥러닝 논문 리뷰 시리즈가 정확히 200편째를 맞이합니다. 처음 시작할 때만 해도 200편까지 이어갈 수 있을지 스스로도 반신반의했는데, 매주 조금씩 쌓아온 리뷰가 어느새 이 정도 규모가 되었네요. 마지막 논문으로는 조금 특별한 주제를 골랐습니다. 바로 이미지를 벡터 그래픽(SVG)으로 변환하는 CVPR 2025 논문, "Layered Image Vectorization via Semantic Simplification"입니다. 저자는 Zhenyu Wang, Jianxi Huang, Zhida Sun, Yuanhao Gong, Daniel Cohen-Or, Min Lu로, 선전대학교(Shenzhen University)와 텔아비브대학교(Tel-Aviv University) 연구진이 함께 참여했습니다. 특히 Daniel Cohen-Or는 이미지 생성 및 그래픽스 분야에서 오랫동안 굵직한 연구를 발표해 온 인물이라 더 눈길이 갔습니다.
래스터 이미지를 벡터로 바꾸는 일이 왜 어려운가
우리가 흔히 보는 사진이나 스크린샷은 픽셀의 격자로 이루어진 래스터 이미지입니다. 반면 SVG 같은 벡터 이미지는 점과 곡선(패스), 색상 채움으로 도형을 표현하기 때문에 확대해도 깨지지 않고, 편집이나 애니메이션에도 유리합니다. 그래서 로고, 아이콘, 일러스트 제작 현장에서는 래스터 이미지를 벡터로 자동 변환하는 기술이 오래전부터 필요했습니다.
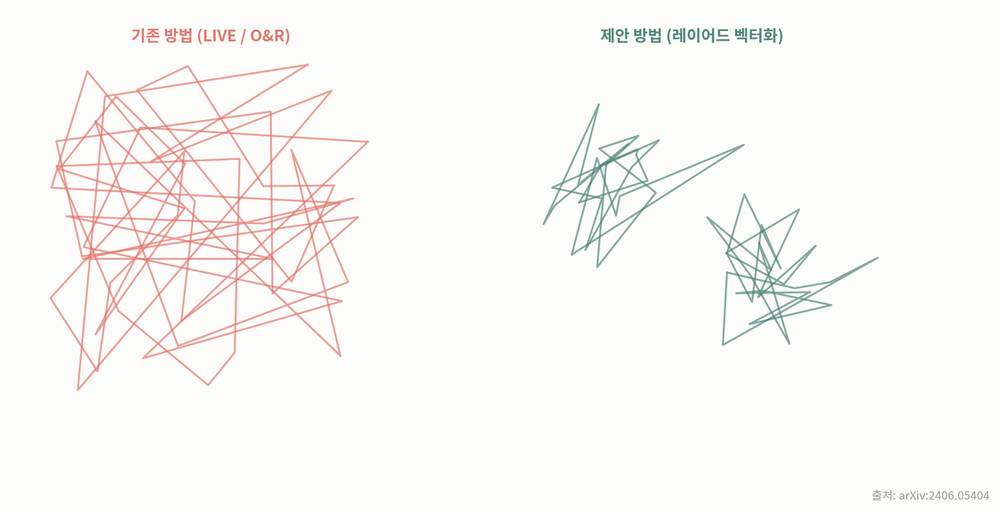
문제는 기존의 자동 벡터화 방법들이 대체로 "픽셀 값을 얼마나 잘 재현하는가"에만 초점을 맞춰 최적화된다는 점입니다. 대표적으로 DiffVG 기반의 LIVE 같은 방법은 미분 가능한 렌더러를 이용해 패스를 점진적으로 추가하며 원본과의 오차를 줄여가는데, 이 과정에서 패스들이 사람이 인지하는 사물의 경계(의미 구조)를 무시하고 여기저기 흩어지거나 서로 다른 영역을 침범하며 뒤엉키는 경우가 많습니다. 결과물이 픽셀 단위로는 원본과 비슷해 보여도, 막상 SVG 파일을 열어 개별 패스를 편집하려고 하면 "이 패스가 대체 어떤 물체에 속한 건지" 알기 어려운 난잡한 구조가 되는 것이죠. 디자이너 입장에서는 이런 결과물을 실무에 쓰기가 매우 불편합니다.
핵심 아이디어: 의미적 단순화 후 레이어별 벡터화
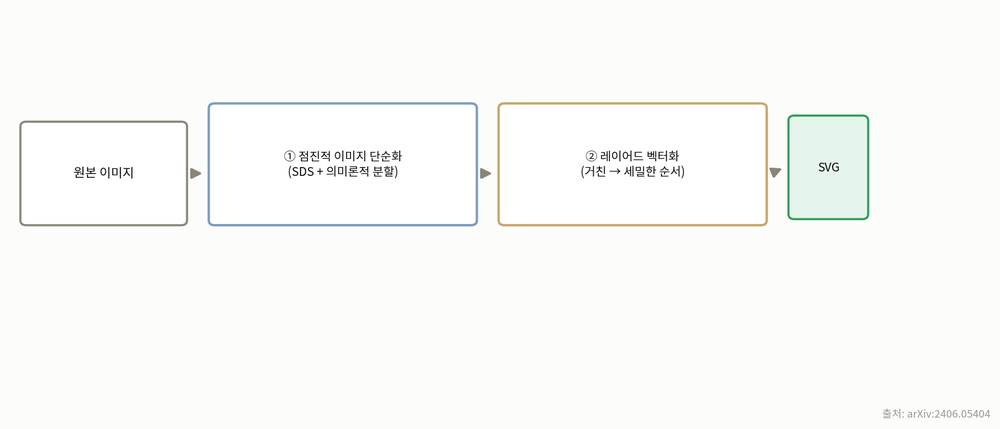
이 논문의 핵심은 "벡터화 이전에 이미지를 의미 단위로 미리 단순화해두자"는 발상입니다. 전체 파이프라인은 크게 두 단계로 구성됩니다.
첫 번째 단계는 점진적 이미지 단순화(Progressive Image Simplification)입니다. 여기서는 Score Distillation Sampling(SDS, 확산 모델에서 흔히 쓰이는 그라디언트 추출 기법)과 의미론적 분할(semantic segmentation)을 결합해, 원본 이미지를 거친 형태에서 세부 형태로 점점 구체화되는 여러 단계의 "단순화된 이미지 시퀀스"로 만들어냅니다. 쉽게 말하면 사람이 스케치를 할 때 처음에는 큰 덩어리(하늘, 인물의 실루엣, 배경 건물 등)만 대강 잡고, 이후 점차 세부 묘사를 더해가는 과정을 이미지 레벨에서 재현하는 것입니다. 이 단계에서 의미론적 분할 정보가 함께 활용되기 때문에, 단순화된 이미지들은 항상 "의미적으로 말이 되는" 경계를 유지합니다.
두 번째 단계는 레이어드 벡터화(Layered Vectorization)입니다. 앞서 만든 단순화 이미지 시퀀스를 가이드로 삼아, 거친 레이어부터 세밀한 레이어까지 순차적으로 벡터 패스를 생성합니다. 각 레이어의 벡터 패스는 해당 레이어가 담당하는 의미 영역의 경계 안쪽에 최대한 머무르도록 제약되며, 그 결과 최종 SVG는 마치 포토샵의 레이어 패널처럼 "하늘 레이어", "인물 레이어", "세부 텍스처 레이어"가 켜켜이 쌓인 구조를 갖게 됩니다.
결과물이 실제로 무엇을 얻어내는가
논문에서 강조하는 정성적 비교에 따르면, 제안 방법으로 만든 벡터는 기존 LIVE, O&R(Optimize and Rasterize) 계열 방법에 비해 개별 패스가 각자 담당하는 의미 영역 경계 안쪽에 훨씬 잘 정렬되어 있고, 논문 저자들은 이를 "패스의 상당 부분이 지정된 의미 구조 안에 온전히 머무른다"는 식으로 서술하고 있습니다. 반대로 기존 방법들에서는 패스가 여러 영역에 걸쳐 흩어지거나 서로 겹치는 현상이 두드러진다고 보고합니다. 다만 공개된 초록과 프로젝트 페이지에는 CLIP 스코어나 LPIPS 같은 구체적인 수치 표까지는 제시되어 있지 않고, 픽셀 단위 오차(MSE) 기반의 시각적 충실도 비교와 정성적 이미지 비교가 중심입니다. 즉 이 논문의 기여는 "숫자 한두 개를 개선했다"는 차원이 아니라, 벡터화 결과물이 사람이 이해하고 편집하기 쉬운 구조를 갖도록 문제 정의 자체를 바꿨다는 데 있습니다.
이런 접근은 실제 그래픽 편집 워크플로우를 생각하면 의미가 큽니다. 벡터화된 SVG를 단순히 화면에 표시하는 데서 그치지 않고, 디자이너가 특정 레이어만 골라 색을 바꾸거나, 인물만 따로 떼어내 다른 배경에 합성하거나, 세부 디테일 레이어를 켜고 끄면서 스타일라이즈드 일러스트를 만드는 식의 후속 편집이 훨씬 자연스러워지기 때문입니다.
마치며 — 200편의 리뷰를 마무리하며
이 논문을 마지막 리뷰로 고른 이유는, 딥러닝이 단순히 "정확도를 몇 퍼센트 더 올렸는가"의 게임이 아니라 "결과물을 사람이 실제로 어떻게 쓸 것인가"까지 고민하는 방향으로 계속 확장되고 있다는 점을 잘 보여주기 때문입니다. 확산 모델의 SDS 기법을 이미지 생성이 아니라 이미지 단순화라는 전혀 다른 문제에 응용하고, 여기에 전통적인 그래픽스 개념인 벡터 레이어 구조를 접목한 것도 흥미로운 지점입니다. 지난 200편의 여정 동안 자연어처리, 컴퓨터 비전, 강화학습, 생성 모델 등 다양한 분야의 논문을 함께 살펴봤는데, 마지막을 그래픽스와 딥러닝이 만나는 지점에서 마무리하게 되어 개인적으로도 뜻깊습니다. 그동안 읽어주신 모든 분들께 감사드리며, 앞으로도 새로운 형태의 리뷰로 다시 찾아뵙겠습니다.
논문 원문과 프로젝트 페이지는 각각 arXiv:2406.05404, 그리고 저자들이 공개한 프로젝트 홈페이지(szuviz.github.io/layered_vectorization)에서 데모 이미지와 함께 확인하실 수 있습니다.
댓글