18 손으로 푸는 선형대수 · 제5부 머신러닝에서 다시 만나기
저랭크 근사 — 무엇을 버리는가
16장에서 A를 랭크1 조각 세 개로 쪼갰다. 이제 뒤에서부터 잘라낸다. 잘라내면 얼마를 잃는지, 그리고 놀랍게도 그 잘라내기가 가능한 최선이라는 것 — Eckart–Young–Mirsky 정리 한 줄에 PCA·LSA·추천시스템·LoRA가 전부 매달려 있다.
- 직관 — 뒤를 자르면 무엇이 사라지나
- 수식 읽는 법 — Eckart–Young–Mirsky
- 손으로 풀기 — A1을 분수로 끝까지, 오차 √10
- 코드 — 이론값 대조 · 이미지 압축 · 스펙트럼
- 시각화 — 에너지가 어디에 쌓여 있는가
약어 및 기호 정의
- σ1 ≥ σ2 ≥ σ3 특이값 singular value
- 16장에서 구한 A의 특이값. 우리 예제에서는 4, 3, 1로 정수다. 항상 내림차순으로 번호를 매긴다.
- ui, vi
- 좌·우 특이벡터. 각각 길이 1이고, Avi = σiui를 만족한다.
- Ak 절단 SVD truncated SVD
- 랭크1 항을 앞에서 k개만 더한 것. Ak = Σi≤k σiuiviT. 이 장의 주인공이다.
- 랭크 rank
- 선형독립인 열(=행)의 개수. 5장에서 정의했다. Ak의 랭크는 정확히 k다(σk > 0인 한).
- 프로베니우스 노름 Frobenius norm
- ‖M‖F = √(Σij mij2). 행렬을 그냥 긴 벡터로 펴서 잰 길이다. 우리 A는 ‖A‖F2 = 26.
- 스펙트럼 노름 spectral norm
- ‖M‖2 = max‖x‖=1 ‖Mx‖ = σ1(M). 16장에서 본 "가장 크게 늘리는 배율". 최악의 한 방향만 본다.
- 에너지 energy
- 이 장에서는 σi2을 뜻한다. ‖A‖F2 = Σσi2이므로 제곱합을 나눠 가진다는 뜻에서 그렇게 부른다.
- 직교불변 orthogonally invariant
- ‖QMZ‖ = ‖M‖이 직교행렬 Q, Z에 대해 성립하는 성질. ‖·‖F와 ‖·‖2 둘 다 이 성질을 가지며, 이 장 증명의 유일한 재료다.
- 스펙트럼 감쇠 spectral decay
- 특이값이 얼마나 빨리 작아지는가. 이것이 빠르면 저랭크 근사가 통하고, 평평하면 통하지 않는다.
- LoRA Low-Rank Adaptation
- 큰 모델의 가중치 갱신량 ΔW를 랭크 r짜리로 제한해 미세조정하는 기법. 이 장 정리의 가장 최근 응용이다.
- 압축률 compression ratio
- 원본이 차지하는 숫자 개수를 근사가 차지하는 숫자 개수로 나눈 값.
직관 — 뒤에서부터 잘라내면 무엇을 잃는가
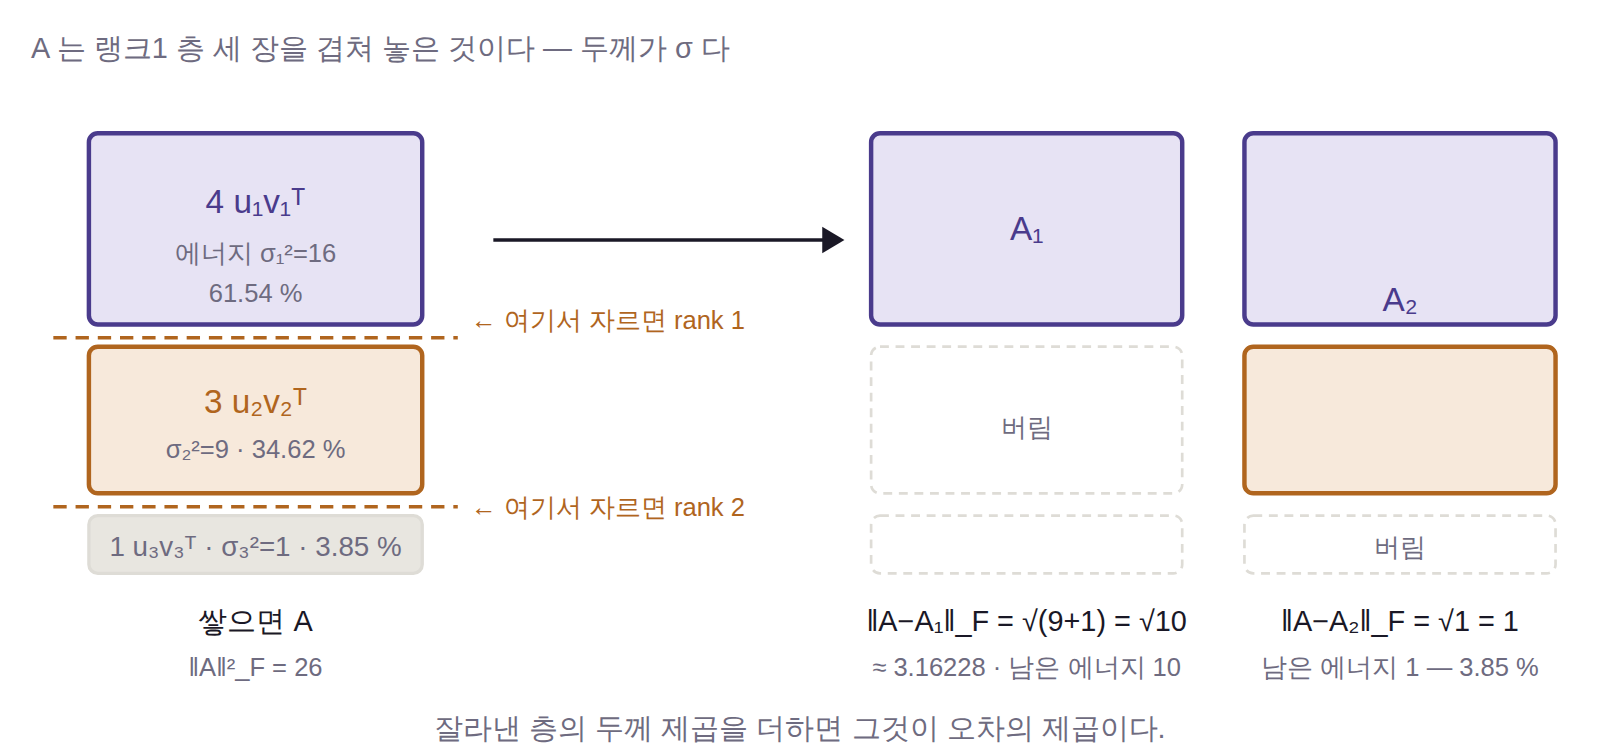
16장에서 우리는 A를 이렇게 쪼갰다. 항이 셋이고, 각 항은 랭크가 정확히 1인 4×3 행렬이다.
2장에서 행렬 곱을 랭크1 항의 합으로 읽는 법을 배웠다. 그때는 항이 k개면 그냥 k개였다. SVD가 특별한 것은 항에 순서가 붙어 있다는 점이다. 앞의 항이 크고 뒤의 항이 작다 — 그것도 그냥 작은 게 아니라, 세기가 곱해진 계수 σi로 정확히 수치화되어 작다.
순서가 붙어 있으면 자연스럽게 떠오르는 일이 있다. 뒤를 버리자.
전부 (rank 3) :  A₃ = 4u₁v₁ᵀ + 3u₂v₂ᵀ + 1u₃v₃ᵀ  = A          숫자 12개 필요
둘만 (rank 2) :  A₂ = 4u₁v₁ᵀ + 3u₂v₂ᵀ            ≈ A          버린 것 = 1u₃v₃ᵀ
하나만(rank 1) :  A₁ = 4u₁v₁ᵀ                     ≈ A          버린 것 = 3u₂v₂ᵀ + 1u₃v₃ᵀ
버린 만큼이 오차다. 그리고 버린 것이 무엇인지 우리는 정확히 알고 있으므로, 오차도 정확히 계산할 수 있다. 이것이 다른 어떤 근사법에도 없는 저랭크 근사의 특권이다. 보통 근사는 "얼마나 틀렸는지"를 나중에 재 봐야 알지만, 여기서는 자르기 전에 이미 알고 있다.
그런데 — 그 잘라내기가 최선인가
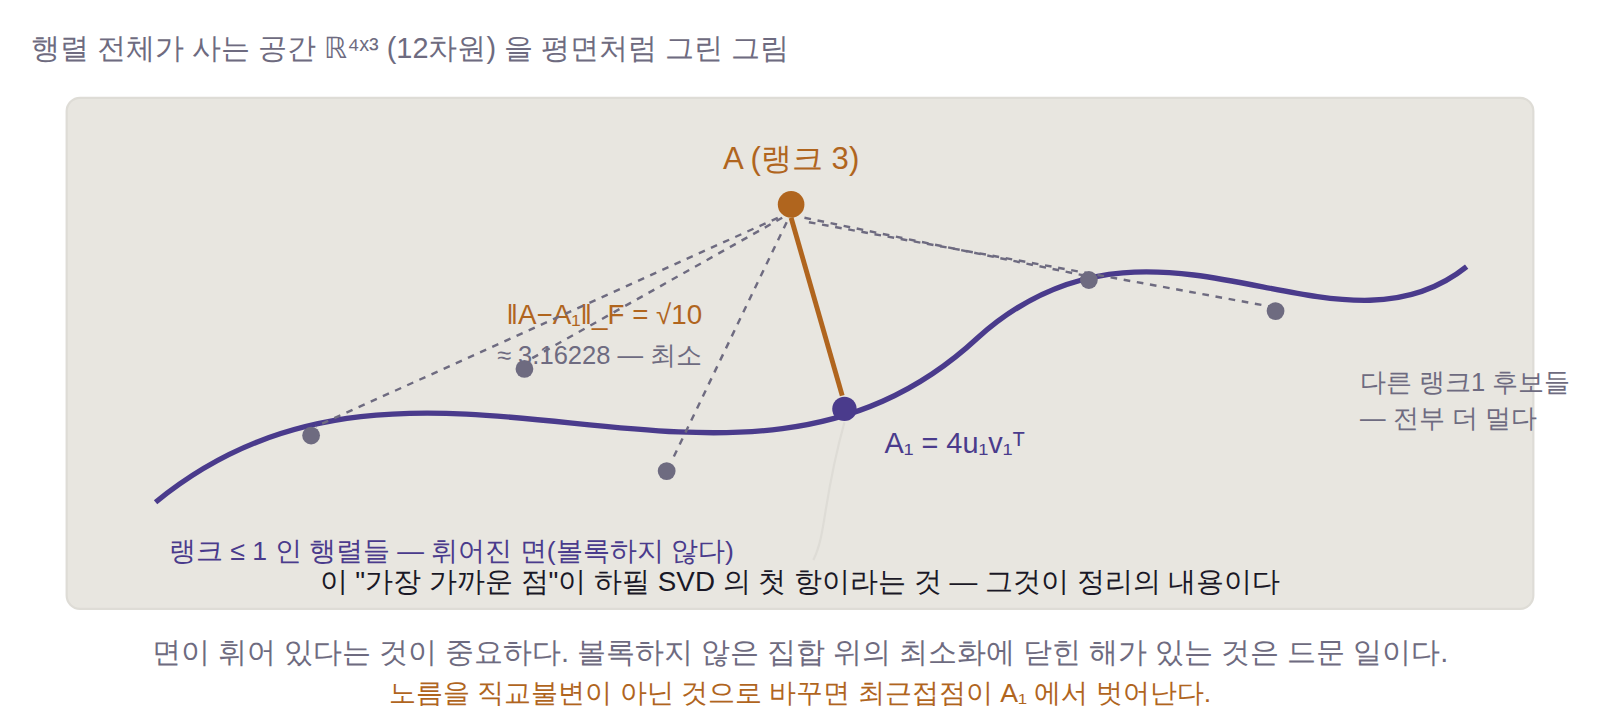
여기서 멈추지 말자. 우리가 한 일은 "주어진 분해에서 뒤를 버렸다"는 것뿐이다. 그것이 "모든 랭크1 행렬 중에서 A에 가장 가깝다"는 뜻은 전혀 아니다.
두 주장 사이의 간격을 분명히 보자. 4×3 실수행렬 중 랭크가 1인 것은 xyT 꼴이고, x ∈ ℝ4와 y ∈ ℝ3를 자유롭게 고를 수 있으니 연속적으로 무한히 많다. 그 무한한 후보 중 하나가 우연히 A에 더 가까울 수도 있지 않은가? u1, v1은 ATA의 고유벡터로 정해진 방향인데, 그 방향이 "근사"라는 완전히 다른 질문의 답이기까지 할 이유는 없어 보인다.
비유하자면 이렇다. 어떤 물건을 세 조각으로 분해하는 공식적인 방법이 있고, 그중 가장 큰 조각 하나만 남겼다고 하자. 그 한 조각이 원래 물건을 흉내 내는 한 조각짜리 물건 중 가장 잘 흉내 내는 것이라는 보장은 어디에도 없다. 분해의 논리와 근사의 논리는 다르다.
그런데 이 경우에는 보장이 있다. 그것이 Eckart–Young–Mirsky 정리Eckart–Young–Mirsky theorem다. 1936년 Eckart와 Young이 프로베니우스 노름에 대해 증명했고, 1960년 Mirsky가 직교불변인 모든 노름으로 확장했다. 저랭크 근사라는 분야 전체가 이 한 문장 위에 서 있다.
수식 읽는 법 — Eckart–Young–Mirsky
기호 하나하나가 무엇을 세는지 읽어 보자.
| 기호 | 무엇을 세는가 | 우리 A에서 |
|---|---|---|
| rank(B) ≤ k | 후보의 집합. 랭크가 k 이하인 모든 4×3 행렬 — 무한히 많다 | k=1이면 xyT 꼴 전부 |
| ‖A − B‖ | 후보와 A의 거리. 어떤 노름이냐에 따라 "거리"의 뜻이 달라진다 | ‖·‖F는 12개 성분 전체, ‖·‖2는 최악의 한 방향 |
| σk+1 | 자르는 자리 바로 다음 특이값. 스펙트럼 노름 오차는 딱 이것이다 | k=1 → σ2=3, k=2 → σ3=1 |
| √(Σi>kσi2) | 버린 특이값의 제곱합의 제곱근. 버린 에너지의 길이 | k=1 → √(9+1)=√10, k=2 → √1=1 |
두 노름의 답이 다르다는 점을 놓치지 말자. k=1에서 스펙트럼 노름 오차는 3이고 프로베니우스 오차는 √10 ≈ 3.16이다. 같은 근사, 다른 자. 그런데 두 자 모두 같은 A1을 최적이라고 말한다. 이것이 Mirsky가 확장한 부분이며, 이 정리를 특별하게 만드는 핵심이다 — 보통은 자를 바꾸면 답도 바뀐다.
프로베니우스 경우의 증명 스케치
증명의 재료는 하나뿐이다. 프로베니우스 노름은 직교변환에 대해 불변이다. 왜 그런지는 한 줄이면 된다 — ‖M‖F2 = tr(MTM)이고, Q가 직교면 tr((QM)TQM) = tr(MTQTQM) = tr(MTM)이다. 9장에서 본 "직교변환은 길이를 보존한다"의 행렬판일 뿐이다.
‖A − B‖F = ‖UT(A−B)V‖F = ‖Σ − C‖F, 여기서 C = UTBV.
U, V가 직교이므로 rank(C) = rank(B) ≤ k다. 즉 문제가 "대각행렬 Σ를 랭크 k로 근사하라"로 완전히 바뀌었다.
엄밀하게는 2단계에서 "비대각을 0으로 두는 것이 정말 가능한가"를 더 조심스럽게 다뤄야 하고(표준 증명은 B의 열공간에 A를 투영하는 방식이나 폰 노이만 흔적 부등식을 쓴다), 스펙트럼 노름 버전은 논리가 다르다 — 그쪽은 차원 세기로 증명한다. rank(B) ≤ k면 B의 영공간은 최소 n−k차원이고, 이것이 v1,…,vk+1이 치는 k+1차원과 ℝn 안에서 반드시 만난다(4장의 차원 정리). 그 교집합 위의 단위벡터 z를 잡으면 Bz = 0이고 ‖Az‖ ≥ σk+1이므로 ‖A−B‖2 ≥ σk+1. 우아한 논증이다.
왜 이 결론이 당연하지 않은가
"제일 큰 조각부터 남긴다"는 것이 너무 상식적으로 들려서 정리의 무게가 잘 느껴지지 않는다. 당연하지 않은 이유를 세 가지로 짚자.
| 당연해 보이는 이유 | 실제로는 |
|---|---|
| "큰 것부터 남기면 되지" | 후보 집합이 연속체다. A1은 그 무한집합 안의 점 하나일 뿐이고, 주변 무한히 많은 점 중 더 가까운 게 없다는 것은 증명이 필요한 사실이다. 4단의 코드에서 랜덤 랭크1 행렬 20만 개를 던져 확인한다. |
| "분해했으니 자르면 그만" | 랭크 k 행렬들의 집합은 볼록하지 않다. 랭크1 둘을 더하면 랭크2가 될 수 있다. 볼록하지 않은 집합 위의 최소화는 보통 지역해가 여럿 생기고 닫힌 형태의 답이 없다. 여기에 깔끔한 답이 있는 것 자체가 예외적이다. |
| "어떤 자로 재도 같겠지" | 아니다. 직교불변이 아닌 노름에서는 무너진다. 예를 들어 원소별 최대값 노름 maxij|aij−bij|이나 L1 성분합 노름에서 최적 랭크1 근사는 일반적으로 A1이 아니며, NP-hard인 경우도 있다. 가중 프로베니우스 노름(성분마다 다른 가중치)도 마찬가지로 닫힌 해가 없다 — 결측이 있는 추천시스템 행렬분해가 SVD 한 방으로 끝나지 않고 반복 최적화를 도는 이유가 정확히 이것이다. |
정리하면 Ak가 최적인 것은 노름이 직교불변일 때다. 그 조건은 공짜가 아니고, 실무에서 그 조건이 깨지는 순간(결측·가중치·비음수 제약) 저랭크 근사는 즉시 어려운 최적화 문제가 된다.
손으로 풀기 — A1을 분수로 끝까지
(가) 에너지 분해표
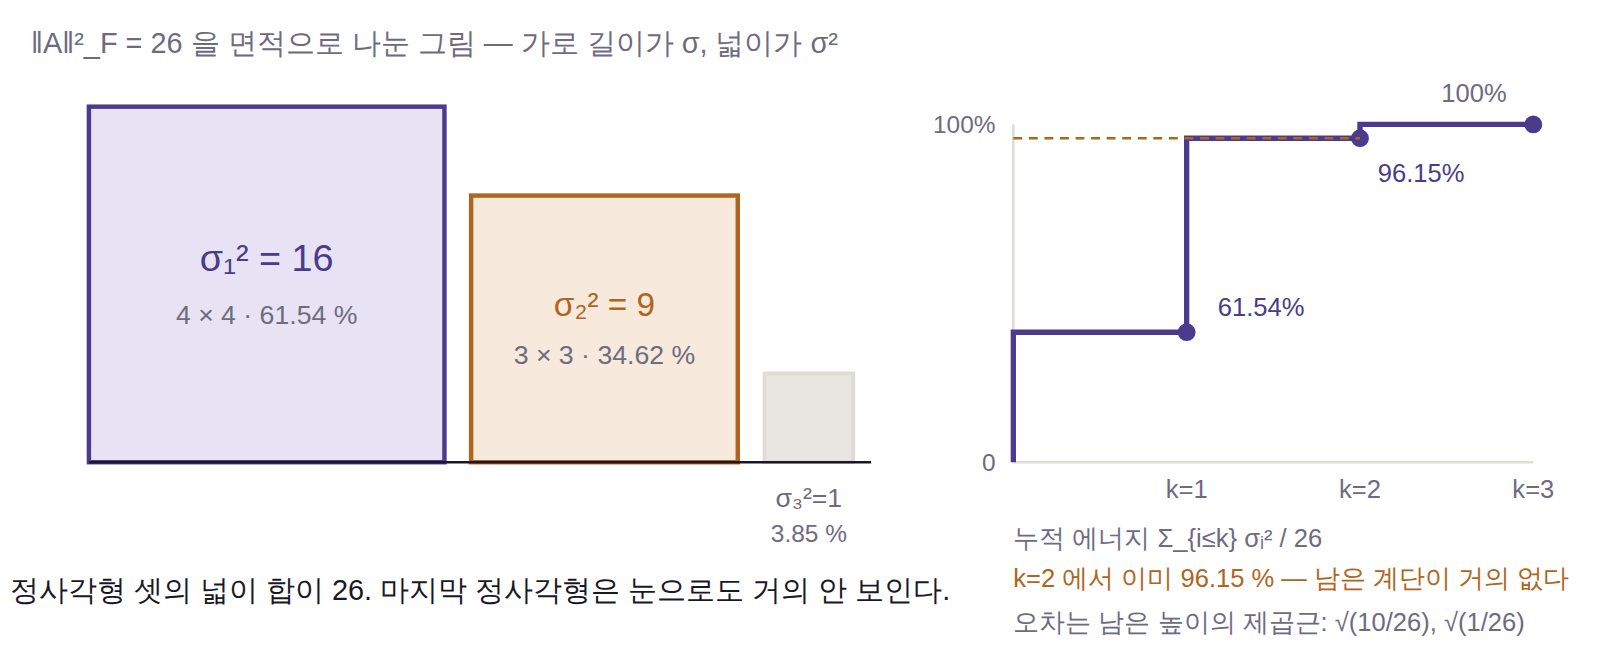
1장에서 ‖A‖F2 = 26을 직접 세었다. A의 열두 성분을 제곱해 더하면 1+1+0+0+4+0+1+0+9+0+9+1 = 26이다. 16장에서는 같은 26이 tr(ATA) = 2+14+10 = 26으로도, 고유값 합 16+9+1 = 26으로도 나온다는 것을 보았다. 이제 이 세 번째 읽기가 표가 된다.
‖A‖²_F = σ₁² + σ₂² + σ₃² = 4² + 3² + 1² = 16 + 9 + 1 = 26손으로 만드는 에너지 분해표
각 항이 전체의 몇 퍼센트인가. 분모는 26으로 고정이다.
σ₁² / 26 = 1626 = 813 = 0.615384… = 61.54 %
σ₂² / 26 = 926 = 0.346153… = 34.62 %
σ₃² / 26 = 126 = 0.038461… = 3.85 %
더하면 16+9+126 = 1. 검산 끝. 이제 누적으로 다시 읽는다.
k=1 : 1626 = 61.54 % → k=2 : 2526 = 96.15 % → k=3 : 2626 = 100 %
핵심은 25/26이다. 항 하나를 버려서 얻는 것이 12개 숫자 중 5개를 안 써도 되는 것인데, 잃는 것은 3.85 %다.
| k | 남긴 항 | 에너지 Σi≤kσi2 | 비율 | 누적 | 버린 에너지 | ‖A−Ak‖F | ‖A−Ak‖2 |
|---|---|---|---|---|---|---|---|
| 0 | 없음 | 0 | 0 % | 0 % | 26 | √26 ≈ 5.09902 | σ1 = 4 |
| 1 | 4u1v1T | 16 | 61.54 % | 61.54 % | 10 | √10 ≈ 3.16228 | σ2 = 3 |
| 2 | + 3u2v2T | 25 | 34.62 % | 96.15 % | 1 | √1 = 1 | σ3 = 1 |
| 3 | + 1u3v3T | 26 | 3.85 % | 100 % | 0 | 0 | 0 |
k=0 줄도 넣었다. 아무것도 안 남기고 B=0으로 근사하면 오차가 ‖A‖F = √26인 것 — 정리의 특수한 경우이며, "쓸모없는 근사"의 기준선 역할을 한다. 랭크1 근사가 √26 → √10으로 줄인 것이 얼마나 되는 일인지 이 줄이 있어야 보인다.
(나) 오차를 규격표와 대조
식 (18.2)를 우리 숫자에 그대로 대입한다.
rank 2 :  ‖A − A₂‖_F = √(σ₃²)        = √1        = 1
          ‖A − A₂‖₂ = σ₃           = 1
rank 1 :  ‖A − A₁‖_F = √(σ₂² + σ₃²) = √(9+1) = √10 ≈ 3.16228
‖A − A₁‖₂ = σ₂ = 3랭크2에서 두 노름이 둘 다 1인 것은 우연이 아니다. 버린 것이 항 하나뿐이면 오차행렬 자체가 랭크1이고, 랭크1 행렬은 특이값이 하나뿐이라 ‖·‖F와 ‖·‖2가 일치한다. 반면 랭크1 근사에서는 오차행렬이 랭크2라 √(9+1) > 3으로 갈라진다.
(다) A1을 실제로 구한다
16장의 결과를 가져온다. v1 = (1,5,3)/√35, Av1 = (6,10,10,18)/√35이므로 u1 = Av1/σ1 = (6,10,10,18)/(4√35)다. 이제 A1 = σ1u1v1T를 조립한다.
√35가 어떻게 사라지는가
계수를 먼저 정리한다. 외적을 쓰기 전에 스칼라만 모으자.
A₁ = σ₁ u₁ v₁T = 4 · (6,10,10,18)T4√35 · (1,5,3)√35
분자의 4와 분모의 4가 먼저 지워진다. 남은 분모는 √35 · √35 = 35.
A₁ = 135 · (6,10,10,18)T(1,5,3)
즉 정수 벡터 두 개의 외적을 35로 나눈 것이다. 무리수가 완전히 사라졌다. 이것은 우연이 아니라 σ1‖v1‖2 = ‖Av1‖·‖v1‖ 구조가 정수로 맞도록 A를 고른 결과다.
이제 외적을 성분으로 적는다. (i,j) 성분 = (6,10,10,18)i × (1,5,3)j.
1행: 6·1=6, 6·5=30, 6·3=18 / 2행: 10·1=10, 10·5=50, 10·3=30
3행: 2행과 같다 (10으로 같으므로) / 4행: 18·1=18, 18·5=90, 18·3=54
        1  ⎡  6   30   18 ⎤        ⎡ 6/35   6/7   18/35 ⎤
 A₁ =  ───  ⎢ 10   50   30 ⎥   =    ⎢ 2/7    10/7  6/7   ⎥
        35  ⎢ 10   50   30 ⎥        ⎢ 2/7    10/7  6/7   ⎥
⎣ 18 90 54 ⎦ ⎣ 18/35 18/7 54/35 ⎦A1의 2행과 3행이 완전히 같다는 것을 보자. 랭크1 행렬이니 당연하다 — 모든 행이 (1,5,3)의 배수이고, 배수가 각각 6/35, 10/35, 10/35, 18/35다. 원래 A의 2행 (0,2,0)과 3행 (1,0,3)은 전혀 닮지 않았는데, 랭크1로 누르면 둘이 같아진다. 이것이 "버린다"는 말의 구체적인 내용이다.
(라) 잔차 A − A1
A도 분모 35로 맞춰서 빼면 정수로 떨어진다. A = (1/35)·35A이므로 35A의 성분은 35, 35, 0 / 0, 70, 0 / 35, 0, 105 / 0, 105, 35다.
35(A − A1)를 성분으로
1행: 35−6=29, 35−30=5, 0−18=−18
2행: 0−10=−10, 70−50=20, 0−30=−30
3행: 35−10=25, 0−50=−50, 105−30=75
4행: 0−18=−18, 105−90=15, 35−54=−19
제곱해서 더한다. 행별로 끊어서.
1행: 29²+5²+18² = 841+25+324 = 1190
2행: 100+400+900 = 1400
3행: 625+2500+5625 = 8750
4행: 324+225+361 = 910
합 1190+1400+8750+910 = 12250. 이것은 352‖A−A₁‖F2이므로
‖A−A₁‖F2 = 122501225 = 10 → ‖A−A₁‖F = √10 ✔
규격표와 일치한다. 반올림 한 번 없이 정수 나눗셈으로 끝났다.
                  1  ⎡  29    5  −18 ⎤
   A − A₁  =    ───  ⎢ −10   20  −30 ⎥       ‖·‖²_F = 12250/1225 = 10
                  35  ⎢  25  −50   75 ⎥
⎣ −18 15 −19 ⎦같은 방식으로 랭크2의 잔차도 확인할 수 있다. 버린 것이 1·u3v3T뿐이고 v3 = (3,0,−1)/√10, Av3 = (3,0,0,−1), σ3=1이므로 u3 = (3,0,0,−1)/√10이고
                1  ⎡  9   0  −3 ⎤
 A − A₂  =    ───  ⎢  0   0   0 ⎥        ‖·‖²_F = (81+9+9+1)/100 = 100/100 = 1
                10 ⎢  0   0   0 ⎥
⎣ −3 0 1 ⎦(마) 압축률 — 무엇을 아끼는가
이제 실용적인 질문. A1을 저장하려면 숫자가 몇 개 필요한가?
| 저장 대상 | 필요한 숫자 | 개수 |
|---|---|---|
| A 원본 | 4×3 성분 전부 | 12 |
| A1 | u1 4개 + v1 3개 + σ1 1개 | 8 (정규화를 포기하면 7) |
| A2 | 2·(4+3+1) | 16 — 원본보다 많다 |
4×3처럼 작은 행렬에서는 이득이 거의 없거나 오히려 손해다. 랭크2는 16 > 12로 저장이 더 늘어난다. 저랭크 근사는 원래 작은 행렬을 위한 기법이 아니다. 일반식을 보면 왜 그런지 바로 나온다.
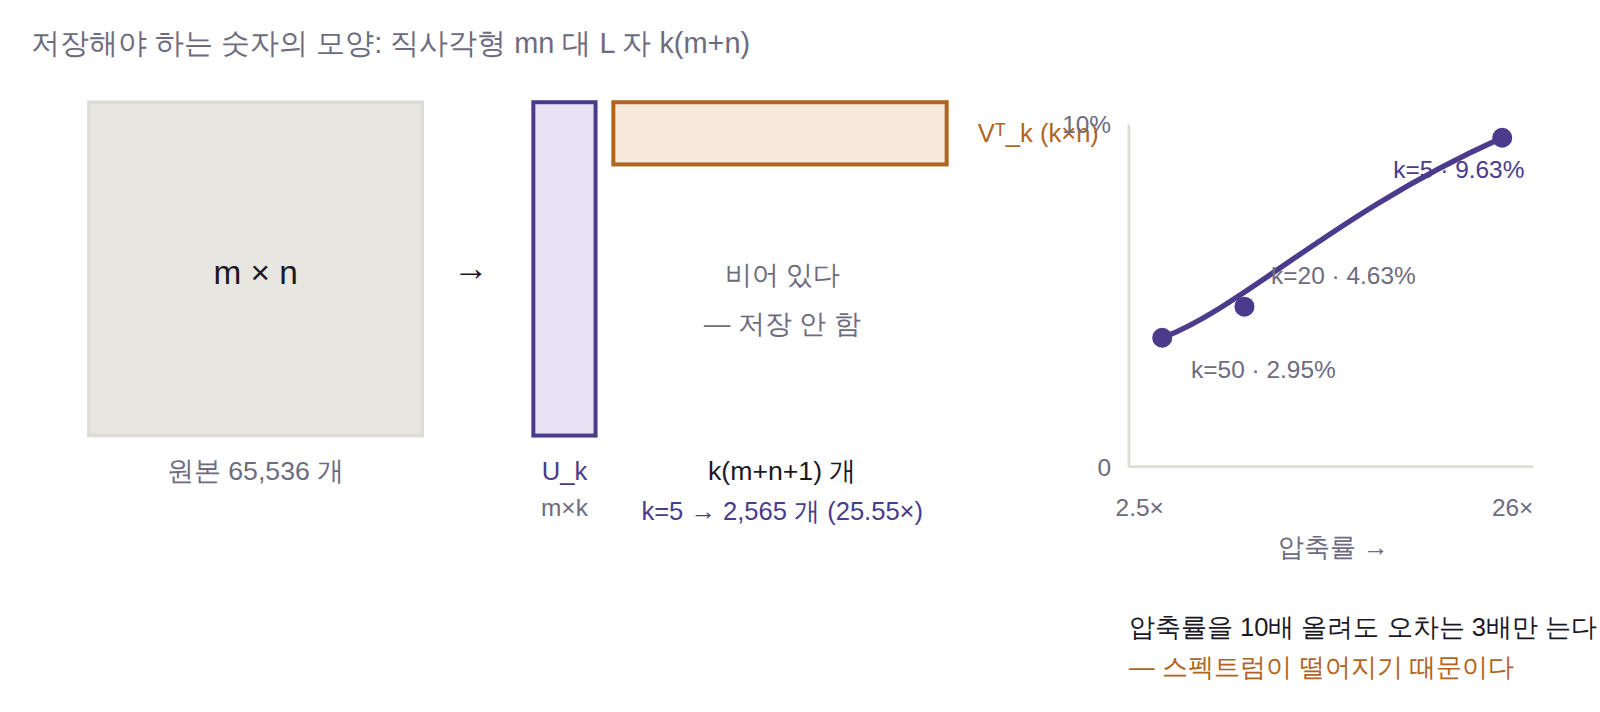
m = n = N인 정사각 행렬로 두면 N2 / (k(2N+1)) ≈ N/(2k)다. N에 비례해 이득이 커진다. N=256에 k=5면 약 25배, N=4096에 k=32면 약 64배. 행렬이 클수록, 그리고 스펙트럼이 빨리 떨어질수록 저랭크 근사가 위력을 낸다. 4단에서 실제로 잰다.
코드 — 이론값 대조 · 이미지 압축 · 스펙트럼
네 가지를 확인한다. ① 랭크1·2 근사를 직접 만들어 오차가 식 (18.2)와 일치하는지, ② 두 노름 모두에서, ③ 실제 이미지 크기의 행렬에서 압축률과 오차, ④ 스펙트럼이 떨어지지 않으면 저랭크가 통하지 않는다는 것. 난수는 시드 20260924로 고정한다.
import numpy as np
np.set_printoptions(precision=4, suppress=True)
A = np.array([[1,1,0],[0,2,0],[1,0,3],[0,3,1]], dtype=float)
U, s, Vt = np.linalg.svd(A)                      # s = 4, 3, 1
print("특이값 :", np.round(s, 12))
def trunc(U, s, Vt, k):                          # 랭크1 항을 k 개만 더한다
    return sum(s[i] * np.outer(U[:, i], Vt[i]) for i in range(k))
print("\n  k | ‖A−A_k‖_F   이론 √(Σσ²)  | ‖A−A_k‖₂   이론 σ_{k+1} | 누적에너지")
tot = (s**2).sum()                               # = 26
for k in [1, 2, 3]:
    Ak = trunc(U, s, Vt, k)
    eF, e2 = np.linalg.norm(A-Ak), np.linalg.norm(A-Ak, 2)
    tF, t2 = np.sqrt((s[k:]**2).sum()), (s[k] if k < len(s) else 0.0)
    print(f"  {k} | {eF:9.5f}   {tF:9.5f}   | {e2:9.5f}  {t2:9.5f}   |"
          f" {(s[:k]**2).sum()/tot*100:6.2f}%   일치={np.allclose([eF,e2],[tF,t2])}")
print("\nA₁ (손계산: (1/35)·(6,10,10,18)ᵀ(1,5,3)) 와 대조")
A1_hand = np.outer([6,10,10,18], [1,5,3]) / 35
print(A1_hand)
print("SVD 절단과 일치 :", np.allclose(A1_hand, trunc(U, s, Vt, 1)))
print("35·(A−A₁) 정수 :\n", np.round(35*(A-A1_hand)).astype(int))
# --- Eckart–Young 을 무작위 랭크1 행렬 20만 개로 때려서 확인 -----------------
rng = np.random.default_rng(20260924)
best = np.inf
for _ in range(200000):
    x, y = rng.standard_normal(4), rng.standard_normal(3)
    B = np.outer(x, y)
    a = (A*B).sum()/(B*B).sum()                  # 스케일은 최적으로 맞춰 준다
    best = min(best, np.linalg.norm(A - a*B))
print(f"\n랜덤 랭크1 20만 개 최소오차 {best:.5f}  vs  A₁ 의 오차 {np.sqrt(10):.5f}"
      f"   (아무도 못 이김: {best >= np.sqrt(10)-1e-9})")
# --- 이미지 압축 데모 : 외부 파일 없이 합성한 구조적 패턴 -------------------
try:
    from scipy.datasets import ascent
    img = ascent().astype(float); src = "scipy ascent"
except Exception:
    N = 256
    yy, xx = np.mgrid[0:N, 0:N] / N
    img = (60*np.sin(6*np.pi*xx) + 60*np.cos(4*np.pi*yy)          # 저랭크 성분
           + 90*((xx-0.35)**2 + (yy-0.6)**2 < 0.045)              # 원판
           + 70*(np.abs(xx-yy) < 0.06) + 128)                     # 대각 띠
    img += 3*np.random.default_rng(20260924).standard_normal((N, N))
    src = "합성 패턴 256×256"
m, n = img.shape
si = np.linalg.svd(img, compute_uv=False)
print(f"\n이미지 압축 ({src}, {m}×{n}, 원본 {m*n:,} 개 수)")
print("  k |    ‖E‖_F   상대오차 | 저장 수 k(m+n+1)  압축률 | 누적에너지")
Ui, ssi, Vti = np.linalg.svd(img)
for k in [5, 20, 50]:
    Ik = (Ui[:, :k]*ssi[:k]) @ Vti[:k]
    e = np.linalg.norm(img-Ik); store = k*(m+n+1)
    print(f" {k:2d} | {e:9.2f}   {e/np.linalg.norm(img)*100:6.2f}% |"
          f" {store:10,}  {m*n/store:8.2f}× | {(ssi[:k]**2).sum()/(ssi**2).sum()*100:6.2f}%")
# --- 스펙트럼이 떨어져야 저랭크가 통한다 -----------------------------------
noise = rng.standard_normal((m, n))
sn = np.linalg.svd(noise, compute_uv=False)
print("\n스펙트럼 비교 (상위 k 가 담는 에너지 비율)")
print("   k |  구조적 이미지 |  백색잡음")
for k in [1, 5, 20, 50]:
    print(f" {k:3d} |  {(ssi[:k]**2).sum()/(ssi**2).sum()*100:11.2f}% |"
          f" {(sn[:k]**2).sum()/(sn**2).sum()*100:8.2f}%")
print(f"σ₅₀/σ₁ : 이미지 {ssi[49]/ssi[0]:.5f} 잡음 {sn[49]/sn[0]:.5f}")k | ‖A−A_k‖_F 이론 √(Σσ²) | ‖A−A_k‖₂ 이론 σ_{k+1} | 누적에너지
1 | 3.16228 3.16228 | 3.00000 3.00000 | 61.54% 일치=True
2 | 1.00000 1.00000 | 1.00000 1.00000 | 96.15% 일치=True
3 | 0.00000 0.00000 | 0.00000 0.00000 | 100.00% 일치=True
A₁ (손계산: (1/35)·(6,10,10,18)ᵀ(1,5,3)) 와 대조
[[0.1714 0.8571 0.5143]
[0.2857 1.4286 0.8571]
[0.2857 1.4286 0.8571]
[0.5143 2.5714 1.5429]]
SVD 절단과 일치 : True
35·(A−A₁) 정수 :
[[ 29 5 -18]
[-10 20 -30]
[ 25 -50 75]
[-18 15 -19]]
랜덤 랭크1 20만 개 최소오차 3.21488 vs A₁ 의 오차 3.16228 (아무도 못 이김: True)
이미지 압축 (합성 패턴 256×256, 256×256, 원본 65,536 개 수)
k | ‖E‖_F 상대오차 | 저장 수 k(m+n+1) 압축률 | 누적에너지
5 | 4081.18 9.63% | 2,565 25.55× | 99.07%
20 | 1962.14 4.63% | 10,260 6.39× | 99.79%
50 | 1249.28 2.95% | 25,650 2.56× | 99.91%
스펙트럼 비교 (상위 k 가 담는 에너지 비율)
k | 구조적 이미지 | 백색잡음
1 | 95.99% | 1.51%
5 | 99.07% | 7.19%
20 | 99.79% | 25.31%
50 | 99.91% | 52.61%
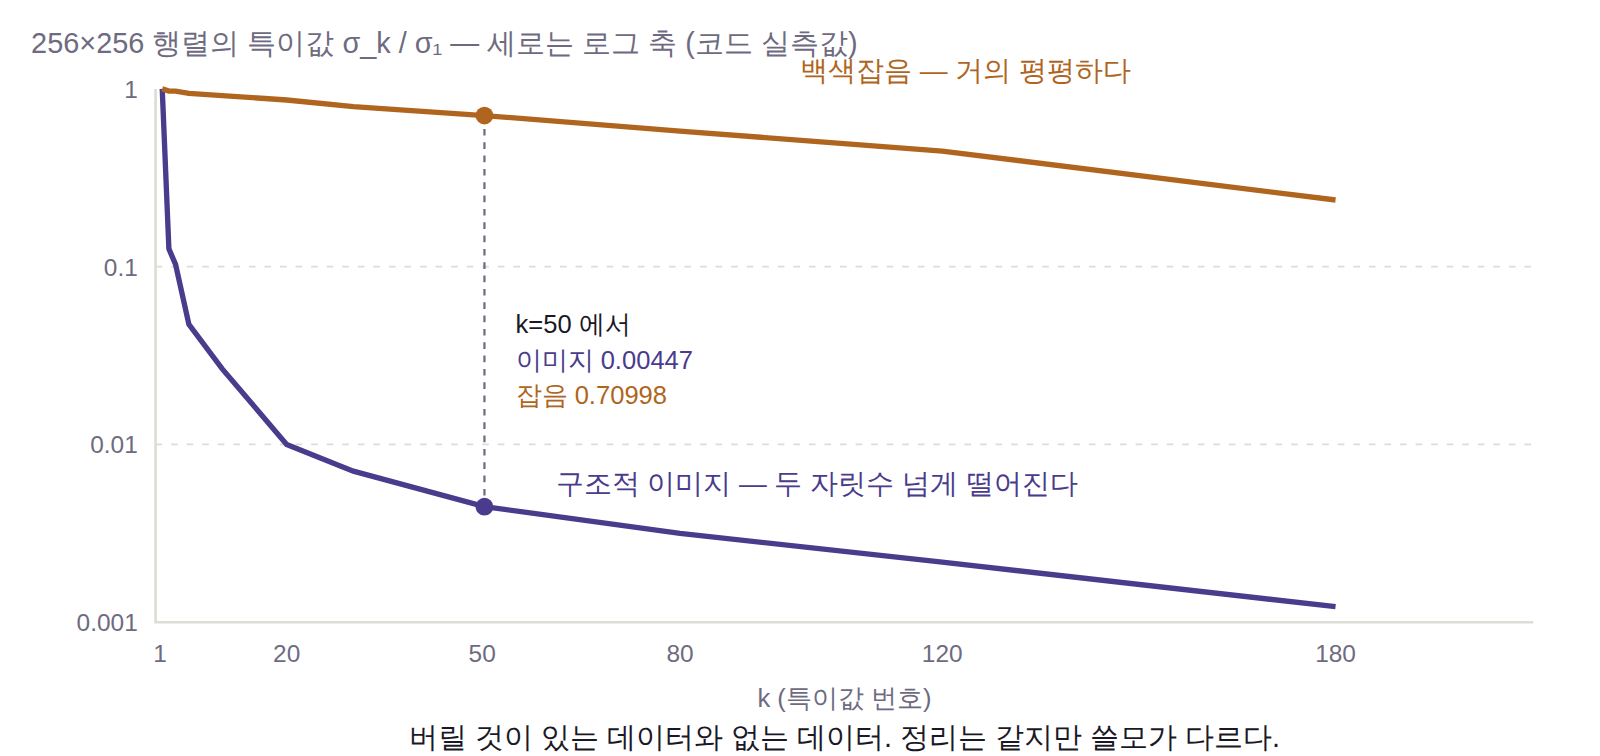
σ₅₀/σ₁ : 이미지 0.00447 잡음 0.70998
읽을 것이 네 덩이다.
첫째, 위쪽 표의 두 열 쌍이 소수점 다섯 자리까지 같다. 3.16228 = 3.16228, 3.00000 = 3.00000. 식 (18.2)가 근사식이 아니라 등식이라는 뜻이다. 누적에너지 61.54 % → 96.15 % → 100 %도 3단 손계산 표와 그대로 맞는다.
둘째, A1이 손으로 만든 (1/35)(6,10,10,18)T(1,5,3)과 numpy의 절단 SVD가 같다고 나왔다. 그리고 35(A−A1)가 [29, 5, −18; −10, 20, −30; 25, −50, 75; −18, 15, −19] — 식 (18.5)의 정수 행렬이 그대로다. 손계산이 부동소수점 계산과 한 자리도 어긋나지 않았다.
셋째, Eckart–Young을 무식하게 때려 본 줄. 랜덤 랭크1 행렬 20만 개를 만들고 각각 스케일까지 최적으로 맞춰 줬는데도 최소 오차가 3.21488로 √10 = 3.16228을 못 이겼다. 물론 이것은 증명이 아니라 납득이다. 하지만 "혹시 더 가까운 게 있지 않을까"라는 의심을 실물로 지워 준다.
넷째, 아래 두 블록이 이 장의 실무적 결론이다. 따로 보자.
스펙트럼이 떨어져야 저랭크가 통한다
256×256 구조적 패턴에서 k=5면 저장 숫자가 65,536 → 2,565개로 25.55배 줄었는데 상대오차는 9.63 %이고 에너지는 99.07 %를 붙잡았다. 압축률과 품질을 동시에 얻은 것이다. 그런데 k를 10배 늘려 50으로 가도 상대오차는 9.63 % → 2.95 %로 겨우 3분의 1이 되고 압축률은 25.55× → 2.56×로 10분의 1이 된다. 앞쪽 몇 개가 거의 전부를 가져가고 뒤는 지지부진하다. 이것이 수확체감이고, 실무에서 k를 "에너지 99 %가 차는 지점"으로 잡는 이유다.
같은 크기의 백색잡음에서는 정반대다. 상위 1개가 담는 에너지가 1.51 % — 256개가 균등하면 0.39 %일 테니 그보다는 크지만 거의 평평하다. 상위 50개(전체의 약 20 %)를 다 써도 52.61 %밖에 못 담는다. σ50/σ1이 이미지에서는 0.00447로 400배 넘게 떨어졌는데 잡음에서는 0.70998로 겨우 30 % 줄었을 뿐이다.
구조적 이미지 :  σ₅₀/σ₁ = 0.00447   →  50 번째 방향은 첫 방향의 0.45 % 세기.  버려도 된다.
백색잡음     :  σ₅₀/σ₁ = 0.70998   →  50 번째도 첫 방향의 71 % 세기.      버릴 게 없다.
결론은 단순하다. 저랭크 근사는 방법이 아니라 데이터의 성질을 이용하는 것이다. 데이터에 구조(반복·상관·저차원 다양체)가 있으면 스펙트럼이 떨어지고 저랭크가 통한다. 구조가 없으면 아무리 좋은 정리를 들이대도 버릴 게 없다. 17장의 PCA가 "주성분 몇 개로 설명된다"고 말할 수 있는 것도 데이터의 공분산 스펙트럼이 떨어지기 때문이고, 떨어지지 않는 데이터에 PCA를 걸면 성분 개수만 세다 끝난다.
시각화 — 에너지가 어디에 쌓여 있는가
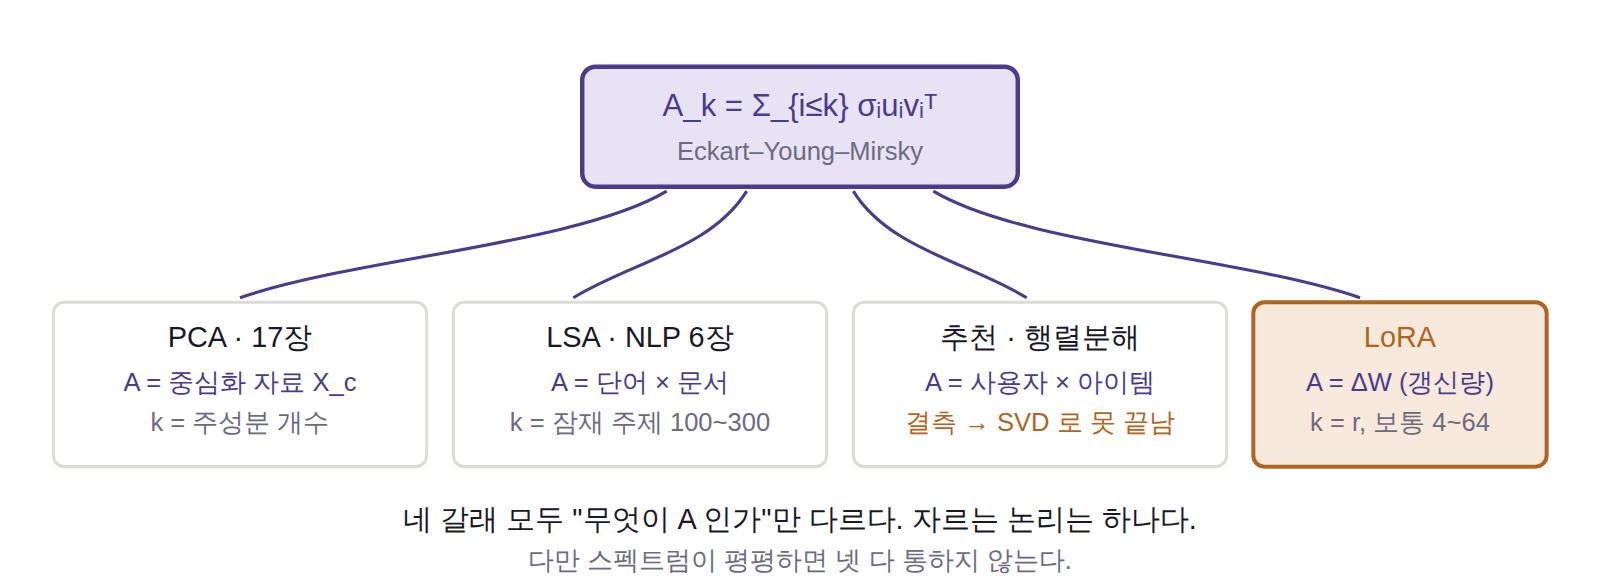
ML에서 이 정리가 어디에 있는가 — "무엇이 A이고 무엇이 k인가"
PCA (17장). A = 중심화한 자료행렬 Xc (n×d). k = 남길 주성분 개수. Xc를 랭크 k로 근사한 것이 "주성분 k개로 재구성한 데이터"이고, 설명분산 비율이 바로 이 장의 누적 에너지다. 17장에서 "분산을 최대로 하는 방향"으로 유도한 것과 여기서 "재구성 오차를 최소로 하는 부분공간"으로 유도한 것이 같은 답인 이유가 Eckart–Young이다.
잠재의미분석 LSA (「자연어처리 입문」 6장). A = 단어×문서 행렬(또는 TF-IDF). k = 잠재 주제 수, 보통 100~300. Ak의 행이 단어 임베딩, 열이 문서 임베딩이 된다. 동의어가 같은 방향으로 모이는 것은 잘라 버린 뒤쪽 차원에 표기의 차이가 들어 있었기 때문이다.
추천시스템 행렬분해. A = 사용자×아이템 평점행렬. k = 잠재 요인 수. 단 여기서는 대부분이 결측이므로 노름이 "관측된 성분에만 걸린 가중 프로베니우스"가 된다. 직교불변이 깨지므로 SVD 한 번으로 끝나지 않고 ALS·SGD로 반복 최적화한다 — 2단 표의 셋째 줄이 실제로 벌어지는 현장이다.
LoRA. A = 미세조정으로 인한 가중치 갱신량 ΔW. 원래 가중치 W가 아니라 변화분이라는 점이 핵심이다. k = 랭크 r, 보통 4~64. ΔW = BA로 B(d×r), A(r×d)만 학습하므로 저장이 d2 → 2rd로 준다. d=4096, r=8이면 16,777,216 → 65,536, 식 (18.6)의 256배다. 가정은 "적응에 필요한 변화는 저랭크다" — 이 가정이 맞는 과제에서만 통한다.
기타. 랜덤 스케치·Nyström 근사(커널행렬 A = K), 주성분 회귀, 노이즈 제거(작은 σ가 잡음이라고 보고 자르기), 트랜스포머 KV 캐시 압축.
그리고 — 저랭크가 항상 좋은 건 아니다. 스펙트럼이 평평하면 버릴 게 없다. 4단의 백색잡음이 그 극단이고, 실제 데이터도 특징이 서로 독립에 가까우면 그쪽에 가까워진다. 이때 k를 줄이면 압축이 아니라 그냥 정보 파괴다. 게다가 작은 σ가 항상 잡음인 것도 아니다 — 희귀하지만 중요한 신호(이상탐지의 이상치, 소수 집단의 패턴)가 뒤쪽 특이값에 들어 있으면 저랭크 근사는 그것을 제일 먼저 지운다. 잘라내기 전에 반드시 스펙트럼을 그려 보라는 말은 그래서 나온다.
이것만 기억하자
- 뒤를 자르는 것이 최선이다 — 증명된 사실이다. 랭크 k 이하 행렬 전체(연속체)를 뒤져도 Ak = Σi≤kσiuiviT보다 가까운 것은 없다. 단 노름이 직교불변일 때만.
- 오차를 자르기 전에 이미 안다. ‖A−Ak‖2 = σk+1, ‖A−Ak‖F = √(Σi>kσi2). 우리 A에서 k=1이면 3과 √10, k=2면 둘 다 1.
- 통하느냐는 정리가 아니라 스펙트럼이 정한다. 26 = 16+9+1처럼 앞쪽에 몰려 있으면 k=2에 96.15 %를 담는다. 백색잡음처럼 평평하면 k=50에도 52.61 %뿐이다.
흔한 오해
- "큰 것부터 남기는 건 당연하니 정리랄 게 없다." — 후보 집합이 무한하고 볼록하지도 않다. 그런 최소화에 닫힌 해가 있는 것 자체가 예외다. 게다가 원소별 최대값 노름이나 가중 프로베니우스 노름에서는 실제로 성립하지 않는다. 결측이 있는 추천시스템이 SVD 한 방으로 안 끝나는 이유가 그것이다.
- "저랭크 근사는 항상 용량을 줄인다." — 아니다. 랭크 k는 k(m+n+1)개를 쓰므로 k ≥ mn/(m+n+1)이면 손해다. 우리 4×3에서 랭크2는 16개로 원본 12개보다 많다. 이득은 m, n이 클 때 N/(2k)로 커진다.
- "작은 특이값은 잡음이니 버려도 된다." — 대체로 맞지만 항상은 아니다. 희귀하고 중요한 패턴이 뒤쪽 특이값에 들어 있으면 저랭크 근사가 그것을 제일 먼저 지운다. 이상탐지는 오히려 버려진 부분을 본다.
- "‖·‖F와 ‖·‖2는 비슷하니 아무거나." — 최적해는 같지만 값이 다르다. k=1에서 3과 3.16228이다. ‖·‖2는 최악의 한 방향만, ‖·‖F는 버린 전부를 센다. 오차 예산을 정할 때 어느 자를 쓰는지 밝혀야 한다.
'선형대수' 카테고리의 다른 글
| 손으로 푸는 선형대수 20장 — 한 장으로 되짚는 ML의 선형대수 (완결) (0) | 2026.09.24 |
|---|---|
| 손으로 푸는 선형대수 19장 — 행렬로 하는 미분: 그래디언트·야코비안·헤시안 (0) | 2026.09.24 |
| 손으로 푸는 선형대수 17장 — PCA는 결국 SVD다 (0) | 2026.09.24 |
| 손으로 푸는 선형대수 16장 — SVD: 모든 행렬의 정규분해 (0) | 2026.09.24 |
| 손으로 푸는 선형대수 15장 — 양정치와 이차형식: 공분산이 왜 대칭 양반정치인가 (0) | 2026.09.24 |
댓글