들어가며: "컨텍스트 윈도우를 늘린다"는 발상 자체를 버리다
긴 문서를 다루는 LLM 연구는 대개 "컨텍스트 윈도우를 어떻게 더 늘릴 것인가"라는 질문에서 출발합니다. 하지만 윈도우를 아무리 늘려도 어텐션 연산량은 문서 길이의 제곱에 비례해 폭증하고, 모델이 학습해본 적 없는 길이로 가면 성능이 급격히 무너지는 외삽(extrapolation) 문제가 남습니다.
ICLR 2026에 Oral로 선정된 논문 "MemAgent: Reshaping Long-Context LLM with Multi-Conv RL-based Memory Agent"(arXiv:2507.02259)는 이 질문 자체를 바꿔버립니다. "컨텍스트를 어떻게 늘릴까"가 아니라 "애초에 문서 전체를 한 번에 볼 필요가 있을까"라고 되묻는 것이죠. 사람이 긴 책을 읽을 때 전체 문장을 한꺼번에 기억하지 않고, 챕터를 읽어나가며 요약 노트를 계속 고쳐 쓰는 것과 비슷한 방식을 모델에 도입했습니다(출처: arXiv:2507.02259). 그 결과 8K 토큰짜리 작은 컨텍스트로 학습한 모델이 350만 토큰 분량의 QA 작업까지 성능 저하 5% 미만으로 처리하는, 다소 믿기 어려운 결과를 보여줍니다.
핵심 아이디어: 읽고, 덮어쓰고, 다음 세그먼트로
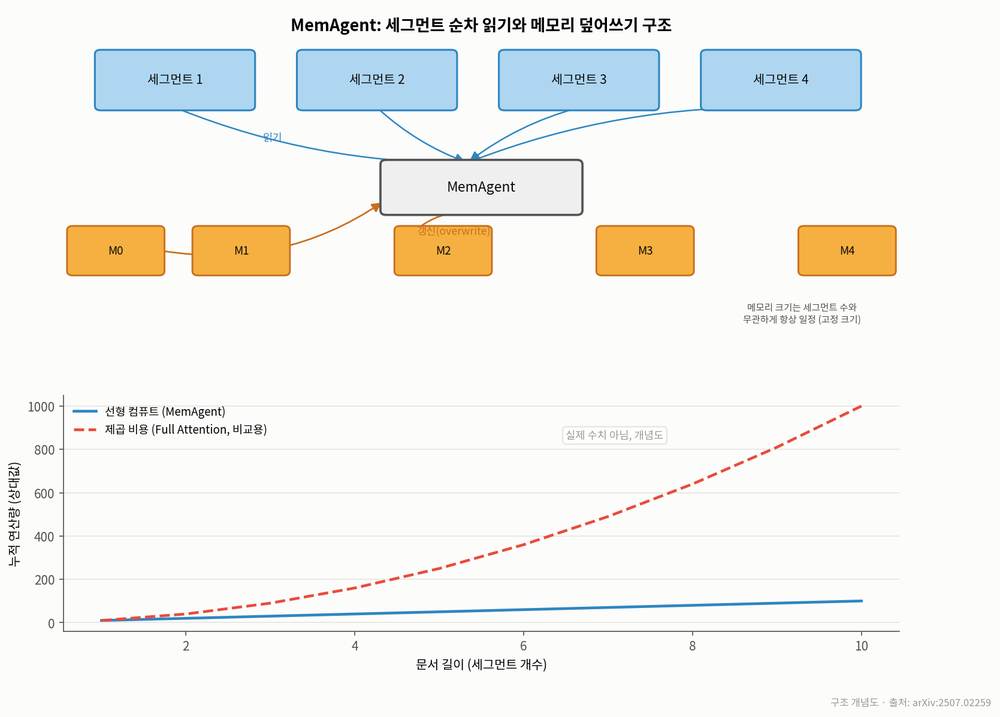
MemAgent의 구조는 생각보다 단순합니다. 입력 문서를 통째로 모델에 넣는 대신 일정한 크기의 세그먼트(segment)로 잘라, 모델이 한 세그먼트씩 순차적으로 읽어나가게 합니다(출처: arXiv:2507.02259). 이때 모델은 이전까지 유지해온 '메모리'와 새로 읽은 세그먼트를 함께 입력받아, 다음 세그먼트로 넘어가기 전에 메모리를 새로 갱신합니다. 중요한 점은 이 갱신이 기존 메모리에 내용을 덧붙이는 방식이 아니라 통째로 덮어쓰는(overwrite) 방식이라는 것입니다(출처: arXiv:2507.02259).
덮어쓰기 방식을 택하면 메모리의 크기가 문서 길이와 무관하게 항상 고정된 상태를 유지합니다. 세그먼트 하나를 처리하는 데 드는 연산량은 일정하고, 문서가 아무리 길어져도 전체 연산량은 세그먼트 개수에 비례해 선형적으로만 늘어납니다(출처: arXiv:2507.02259). 어텐션의 제곱 비용 문제를 아키텍처 차원에서 우회해버리는 셈입니다. 대신 이 구조가 성립하려면 모델이 "지금까지 읽은 내용 중 앞으로 필요한 정보만 골라 메모리에 남기고, 불필요한 건 버리는" 판단을 정확히 해내야 하는데, 이 판단력을 길러주는 것이 바로 이 논문이 제안하는 강화학습 훈련법입니다.
어떻게 학습시키나: 독립 컨텍스트 다중 대화 생성과 확장된 DAPO
여기서 기술적으로 가장 까다로운 문제가 등장합니다. 메모리를 "잘" 요약하도록 모델을 가르치려면, 중간에 어떤 정보를 남기고 버릴지에 대한 보상 신호가 필요합니다. 그런데 이 중간 판단 하나하나에 정답 레이블을 달아줄 수는 없습니다. 최종적으로 질문에 올바르게 답했는지만 알 수 있을 뿐, 그 과정에서 몇 번째 세그먼트의 메모리 갱신이 결정적이었는지는 알기 어렵기 때문입니다.
저자들은 이를 강화학습(RL) 문제로 재정의하고, DAPO(Decoupled clip and Dynamic sAmpling Policy Optimization) 알고리즘을 확장해 적용합니다(출처: arXiv:2507.02259). 구체적으로는 "독립 컨텍스트 다중 대화 생성(independent-context multi-conversation generation)"이라는 기법을 도입하는데, 이는 하나의 긴 문서 처리 과정을 여러 개의 독립적인 대화(conversation) 단위로 쪼개어 각각 다른 컨텍스트에서 샘플링한 뒤, 최종 답변의 정답 여부에서 나온 보상을 전체 메모리 갱신 과정에 걸쳐 전파하는 방식입니다(출처: arXiv:2507.02259). 이를 통해 모델은 "어떤 정보를 메모리에 남겨야 최종적으로 정답을 맞힐 확률이 높아지는지"를 엔드투엔드로 학습하게 됩니다. 사람이 일일이 "이 문장은 중요하다"고 라벨링해줄 필요 없이, 결과 기반 보상만으로 압축·요약 전략이 자연스럽게 체득되는 것이 이 방법의 핵심입니다.
실험 결과: 8K로 배워서 512K, 350만 토큰까지
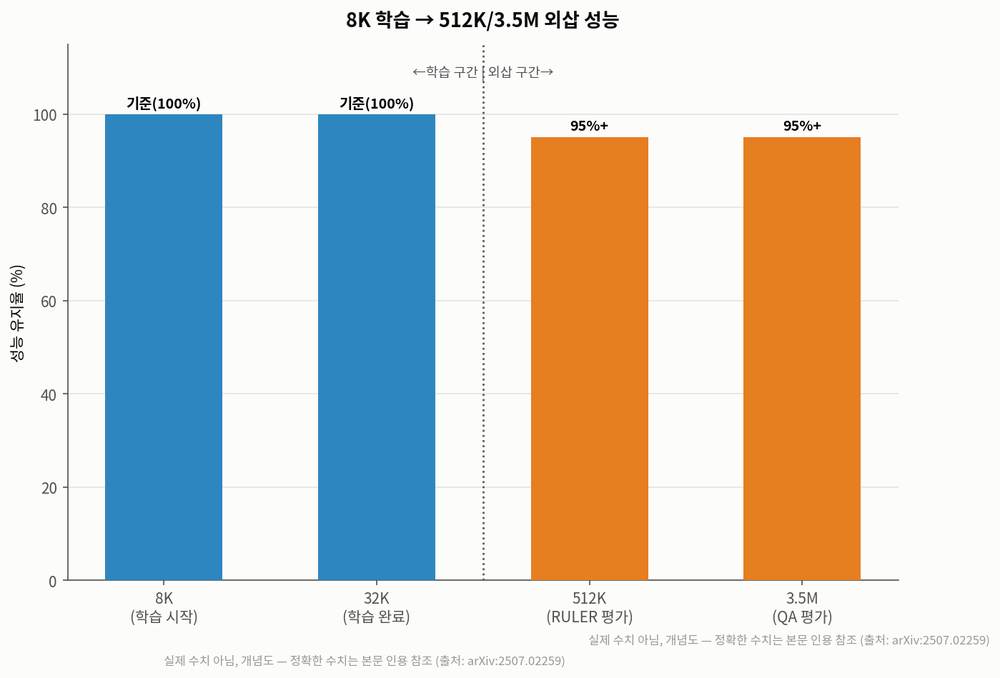
훈련 자체는 비교적 짧은 컨텍스트에서 이뤄졌습니다. 논문에 따르면 모델은 8K 토큰 기반 환경에서 출발해 32K 토큰 컨텍스트로 학습되었습니다(출처: arXiv:2507.02259). 그런데 평가 단계에서는 이보다 훨씬 긴 입력에 대해 테스트했고, 결과는 다음과 같이 보고됩니다.
- 장문서 기반 QA 작업을 350만(3.5M) 토큰 규모까지 확장했을 때도 성능 저하가 5% 미만에 그쳤습니다(출처: arXiv:2507.02259). - 장문 컨텍스트 벤치마크인 RULER의 512K 토큰 설정에서 95% 이상의 성능을 달성했습니다(출처: arXiv:2507.02259).
이 두 수치가 중요한 이유는, 학습에 사용한 컨텍스트 길이(32K)와 평가에 사용한 컨텍스트 길이(최대 350만) 사이에 100배 이상의 격차가 있다는 점입니다. 일반적인 긴 컨텍스트 모델은 학습 시점의 길이를 벗어나면 성능이 급격히 무너지는 경향을 보이는데, MemAgent는 세그먼트 단위 처리와 고정 크기 메모리 구조 덕분에 "얼마나 긴 문서가 들어오든 한 번에 처리하는 단위의 길이는 동일하다"는 특성을 가지므로 이런 외삽이 상대적으로 자연스럽게 이뤄진다는 것이 저자들의 설명입니다(출처: arXiv:2507.02259).
왜 화제가 되었나: 오랜 트레이드오프에 대한 다른 답
장문 컨텍스트 처리 연구는 크게 두 갈래로 나뉘어 왔습니다. 하나는 어텐션 메커니즘 자체를 근사하거나 희소화해서 비용을 줄이는 접근(스파스 어텐션, 선형 어텐션 계열), 다른 하나는 검색 증강(RAG)처럼 외부에 정보를 저장해두고 필요할 때 불러오는 접근입니다. MemAgent는 이 둘과 결이 다릅니다. 모델 자체를 "읽으면서 압축하는 에이전트"로 재정의하고, 그 압축 전략 자체를 RL로 학습시킨다는 점에서 memory-as-agent라는 새로운 패러다임을 제시합니다(출처: arXiv:2507.02259).
ICLR 2026 심사에서 Oral로 선정되었다는 점도 이 접근의 참신성을 뒷받침합니다. 특히 "짧은 컨텍스트로 훈련해 긴 컨텍스트로 확장한다"는 역발상이, 긴 컨텍스트 데이터 확보와 학습 비용이라는 실무적 병목을 동시에 해결할 수 있다는 점에서 산업계의 관심도 클 것으로 보입니다. 다만 세그먼트 분할 방식이나 메모리 크기 설정이 태스크에 따라 민감하게 작동할 가능성, 그리고 RL 학습 자체의 안정성과 비용 문제는 추후 검증이 더 필요한 부분으로 남아 있습니다.
정리하며
MemAgent는 "컨텍스트 윈도우를 늘리는" 대신 "모델이 읽으면서 스스로 요약하게 만드는" 방향으로 장문 처리 문제에 접근한 논문입니다. 세그먼트 단위 읽기와 메모리 덮어쓰기라는 단순한 구조에, 독립 컨텍스트 다중 대화 생성으로 확장한 DAPO 강화학습을 결합해, 8K~32K라는 짧은 컨텍스트 학습만으로 512K RULER 95%+, 350만 토큰 QA에서도 5% 미만의 성능 손실이라는 결과를 냈다는 점이 핵심입니다(출처: arXiv:2507.02259). 연산량이 문서 길이에 선형으로만 증가한다는 점까지 더하면, 실질적으로 "사실상 무제한 컨텍스트"를 다루는 실용적 해법으로 평가할 만합니다. 앞으로 다양한 실무 환경에서 이 메모리 에이전트 구조가 어떻게 재현되고 변형되는지 지켜볼 가치가 있습니다.
댓글