들어가며: MoE는 정말 "타협"일 뿐일까
GPT-4, Mixtral, DeepSeek-V3 같은 최신 대형 언어모델들이 앞다퉈 채택하고 있는 Mixture-of-Experts(MoE, 전문가 혼합) 구조는 보통 "같은 추론 비용으로 더 큰 용량을 쓸 수 있는 효율화 기법"으로 소개됩니다. 다시 말해 "동일 연산량(compute) 대비 성능"에서는 MoE가 유리하지만, 파라미터 수·학습 연산량·데이터량을 모두 밀집(dense) 모델과 똑같이 맞춰놓고 "순수 실력"을 겨루면 결국 dense가 더 낫다는 것이 암묵적인 통념이었습니다.
ICLR 2026에 Oral로 선정된 논문 "Mixture-of-Experts Can Surpass Dense LLMs Under Strictly Equal Resource"(arXiv:2506.12119)는 바로 이 통념에 정면으로 도전합니다. 저자들은 활성화 비율(activation ratio)을 제대로 조정하기만 하면, 총 파라미터 수·학습 컴퓨트·데이터 예산을 모두 엄격히 동일하게 고정한 상태에서도 MoE가 dense 모델을 능가할 수 있다는 것을 대규모 실증 연구로 보여줍니다(출처: arXiv:2506.12119).
연구 규모: 2B급 약 200개, 7B급 50개 이상, 총 50조 토큰
이 논문의 설득력은 실험 규모에서 나옵니다. 저자들은 2B 파라미터 규모에서 약 200개의 모델을, 7B 규모에서는 50개 이상의 모델을 학습시켰고, 이 모든 실험에 투입된 토큰 수는 누적 50조(50T) 토큰에 달합니다(출처: arXiv:2506.12119). 단순히 한두 번의 운 좋은 설정을 찾은 것이 아니라, 활성화 비율을 촘촘하게 스윕(sweep)하면서 "어느 지점에서 MoE가 dense를 이기는지"를 체계적으로 지도화한 것입니다.
여기서 핵심 통제 변수는 "엄격하게 동일한 자원(strictly equal resource)"이라는 조건입니다. 즉 총 파라미터 수(N), 학습에 쓰인 총 연산량(C), 학습 데이터량(D)을 MoE와 dense 모델 사이에서 정확히 맞춘 뒤 성능만 비교합니다. 흔히 MoE 논문들이 비교하는 "동일 활성 파라미터, 다른 총 파라미터" 식의 비교가 아니라, dense 모델 입장에서 가장 유리하도록 자원을 철저히 동일하게 맞춰놓고도 MoE가 이길 수 있는지를 검증한 셈입니다.
활성화 비율(Activation Ratio)이라는 숨은 변수
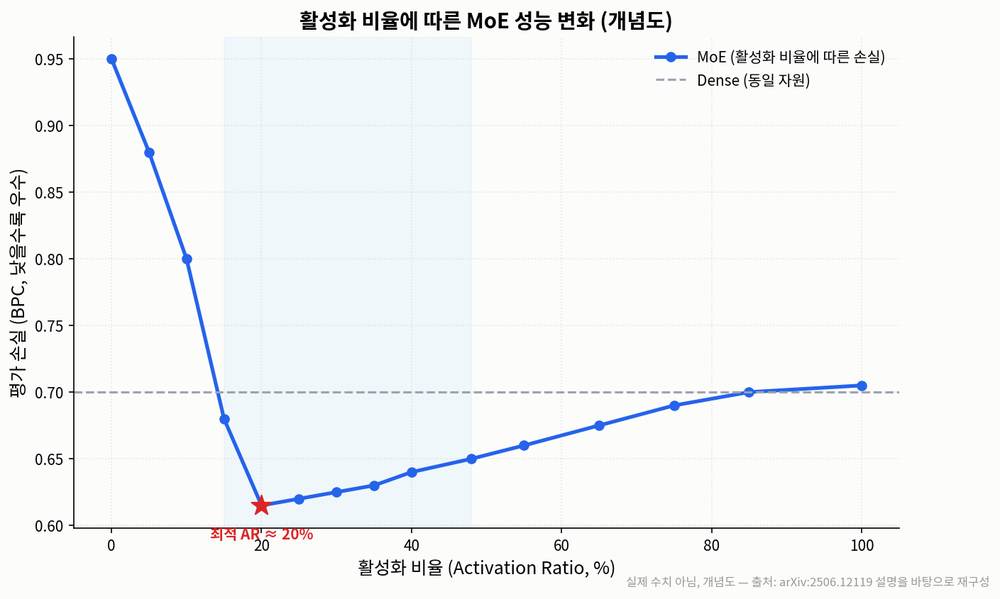
MoE 모델의 성능은 전체 파라미터 중 토큰마다 실제로 활성화되는 파라미터의 비율, 즉 활성화 비율(activation ratio, AR)에 크게 좌우됩니다. AR이 100%에 가까우면 사실상 dense 모델과 다를 바 없어지고, AR이 지나치게 낮으면 각 전문가(expert)가 충분히 학습되지 못해 성능이 급격히 나빠집니다. 저자들은 이 AR을 핵심 조작 변수로 삼아 실험을 설계했습니다(출처: arXiv:2506.12119).
실험 결과, 저자들은 AR이 특정한 "최적 구간"에 들어올 때 MoE가 동일 자원의 dense 모델을 꾸준히 능가한다는 사실을 확인했습니다. 보고된 바에 따르면 2B 규모에서 대략 15~48% 범위가 우수한 성능을 내는 구간이었고, 그 중에서도 약 20% 부근이 가장 좋은 지점으로 나타났습니다(출처: arXiv:2506.12119). 더 흥미로운 점은, 이 최적 AR 지점이 2B·3B·7B 등 모델 규모가 달라져도 비교적 일관되게 유지된다는 것입니다(출처: arXiv:2506.12119). 이는 기존에 "모델이 커질수록 최적 활성화 비율도 달라질 것"이라고 여겨지던 가정과 배치되는 결과로, 실무자 입장에서는 규모를 바꿔가며 매번 AR을 재탐색할 필요가 줄어든다는 뜻이기도 합니다.
성능 격차와 벤치마크: 얼마나 더 잘하나
그렇다면 실제 성능 격차는 어느 정도일까요. 저자들에 따르면 최적 AR(약 20%) 지점에서 MoE 모델은 동일 컴퓨트로 학습된 dense 모델 대비 평가 손실(BPC, bits-per-character) 기준으로 더 낮은 값을 기록했으며, 그 격차는 dense 모델을 두 배의 컴퓨트로 학습시켰을 때 얻을 수 있는 개선 폭에 근접하는 수준이었다고 보고됩니다(출처: arXiv:2506.12119). 다시 말해 동일한 자원으로 "컴퓨트를 두 배 들인 것과 비슷한 효과"를 MoE 구조 자체의 설계만으로 얻어낸 셈입니다.
이 우위는 사전학습 손실 같은 업스트림 지표에서만 나타나는 것이 아니라, 7B 규모 모델을 지식·추론·수학·코드 등 다양한 영역을 아우르는 약 29개의 다운스트림 벤치마크에 적용했을 때도 일관되게 관찰되었습니다(출처: arXiv:2506.12119). 예를 들어 다단계 추론 능력을 측정하는 벤치마크나 지식 기반 벤치마크에서 최적 AR로 학습된 MoE가 동일 자원의 dense 모델보다 높은 점수를 기록한 사례들이 보고되었습니다(출처: arXiv:2506.12119). 구체적인 벤치마크별 점수 차이는 과제에 따라 편차가 있으므로, 정확한 수치는 원 논문의 표를 직접 확인하는 것을 권장합니다.
데이터는 어떻게 맞췄나: "제한된 데이터" 문제에 대한 해법
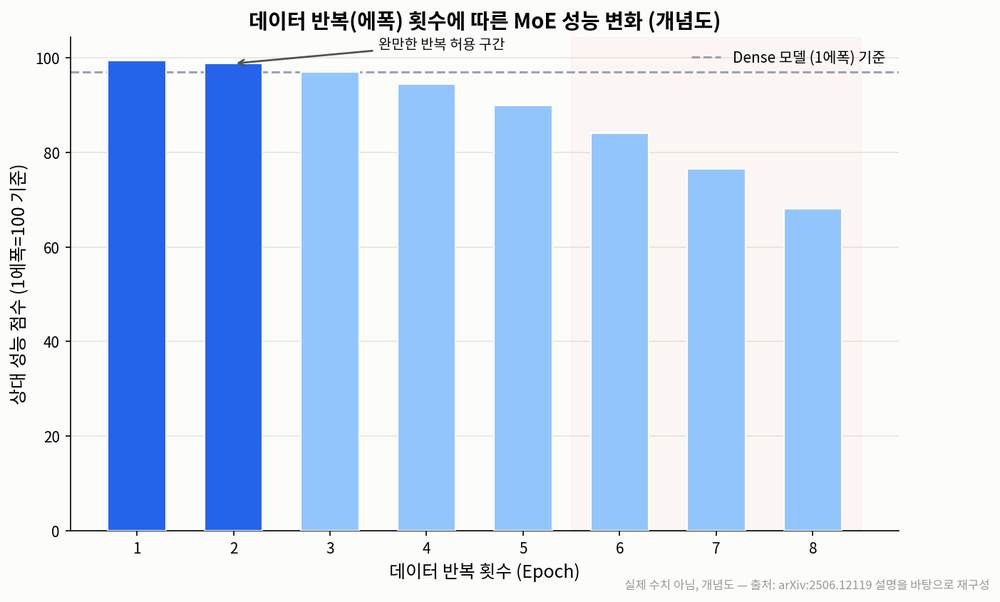
"파라미터·컴퓨트·데이터를 모두 동일하게 맞춘다"는 조건에는 한 가지 까다로운 문제가 숨어 있습니다. MoE는 같은 컴퓨트 예산 안에서 dense보다 더 많은 토큰을 "소비"하는 경향이 있어서, 고유(unique) 데이터가 충분하지 않으면 같은 토큰을 여러 번 반복 학습(epoch)해야 하는 상황이 생깁니다. 저자들은 이를 위해 두 가지 데이터 구성 방식을 설계했습니다(출처: arXiv:2506.12119).
첫째는 '엄격(strict)' 방식으로, MoE와 dense 모두 동일한 N/C/D 제약 아래 두되, MoE 쪽은 더 작은 고유 데이터셋을 1.7~8.3회 정도 반복 학습하도록 허용합니다. 둘째는 '완화(loose)' 방식으로, 에폭 수를 2회로 고정한 채 고유 데이터량만 바꿔가며 실험합니다. 두 방식 모두에서 공통적으로 확인된 사실은, MoE 모델이 약 2에폭 수준의 가벼운 데이터 반복은 비교적 잘 견뎌내며 성능 저하가 크지 않다는 점입니다(출처: arXiv:2506.12119). 즉 데이터가 제한적인 상황에서도 소량의 반복 학습을 통해 MoE의 우위를 실질적으로 재현할 수 있다는 실용적인 결론을 제시합니다.
왜 중요한가: 스케일링 법칙 재설계의 신호탄
이 논문이 화제가 되는 이유는 단순히 "MoE가 더 좋다더라"는 새로운 벤치마크 승리 소식이 아니라, 지금까지 업계가 암묵적으로 받아들여 온 "동일 자원 비교에서는 dense가 유리하다"는 전제 자체를 대규모 실증으로 뒤집었기 때문입니다. 저자 소속 기관에는 StepFun, 푸단대학교(Fudan University), 중국과학기술대학교, 저장대학교 등이 포함되어 있으며(출처: arXiv:2506.12119), 상업용 LLM을 실제로 서빙하는 기업과 학계가 함께 참여해 수십 개에서 수백 개 모델을 학습시키는 "스케일링 법칙 탐색형" 연구라는 점도 신뢰도를 높이는 요소입니다.
실무적으로는 앞으로 LLM을 새로 설계할 때 "파라미터 예산이 고정되어 있다면 무조건 dense를 쓰는 것이 안전하다"는 식의 기본값이 재검토될 가능성이 큽니다. 활성화 비율을 15~48%, 특히 20% 근방으로 설정한 MoE 아키텍처가 동일 비용에서 더 강력한 선택지가 될 수 있다는 근거가 이번 연구로 한층 두터워졌기 때문입니다.
한계와 정리
다만 이 결과를 과도하게 일반화하기 전에 짚을 부분도 있습니다. 실험은 주로 2B~7B 규모에서 수행되었으며, 수백억~수조 파라미터급 초대형 모델에서도 동일한 최적 AR 구간과 격차가 그대로 유지되는지는 추가 검증이 필요합니다. 또한 라우팅(routing) 알고리즘, 전문가 수, 공유 전문가(shared expert) 설계 등 MoE의 다른 구조적 선택지에 따라 결과가 달라질 여지도 있습니다. 논문이 공개한 정확한 수치와 실험 세부 설정은 원문 표와 부록을 확인하는 것이 가장 정확합니다.
그럼에도 "동일 자원 하에서 MoE가 dense를 이길 수 있다"는 명제를 2B~7B 규모, 수백 개 모델, 50조 토큰 규모의 실증으로 뒷받침했다는 점에서, 이 논문은 향후 LLM 아키텍처 설계의 기본 가정을 바꿀 만한 레퍼런스로 자리 잡을 가능성이 높습니다.
댓글