이 논문을 고른 이유
요즘 추론(reasoning) 모델들은 답을 내기 전에 아주 긴 "생각의 사슬(chain-of-thought)"을 만들어냅니다. 문제가 어려울수록 생각은 길어지고, 그만큼 컨텍스트 윈도우(context window)와 KV 캐시(KV cache)도 끝없이 늘어납니다. 그런데 이 모델들에게는 사람처럼 "지금까지 생각한 걸 한 줄로 요약하고, 세부 내용은 잊어도 되는" 능력이 전혀 없습니다. 중간 계산 과정이든 핵심 결론이든 모두 똑같은 무게로 끝까지 끌고 가야 하는 구조이기 때문입니다. 이 논문은 바로 이 지점을 공략합니다. "모델이 스스로 자기 생각을 블록 단위로 나누고, 각 블록을 압축된 요약으로 바꾸고, 이후에는 그 요약만 보면서 계속 추론하게 만들 수는 없을까?"라는 질문입니다(출처: arXiv:2604.09852).
이 논문은 Microsoft Research 소속의 Vasilis Kontonis, Yuchen Zeng, Shivam Garg, Lingjiao Chen, Hao Tang, Ziyan Wang, Ahmed Awadallah, Eric Horvitz, John Langford, Dimitris Papailiopoulos가 저자로 참여했습니다(출처: arXiv:2604.09852). 이번 리뷰는 RSS 2026·COLM 2026 확장판 30편 시리즈의 500번째 글이기도 한데, 마침 LLM이 "자기 컨텍스트를 관리"하는 방법을 다룬 논문이라 숫자의 우연이 꽤 재미있었습니다.
개인적으로 흥미로웠던 지점은, 이 논문이 단순히 "요약을 잘 하자"는 수준을 넘어서, 압축된 요약 텍스트와 모델 내부의 KV 상태(KV state) 양쪽에 정보가 동시에 남아있다는 "이중 정보 흐름(dual information stream)"이라는 현상을 발견하고 이를 실험으로 직접 검증했다는 점입니다. 긴 추론을 다루는 모델을 실제로 서비스할 때 메모리와 연산 비용이 얼마나 중요한지 체감하고 있는 분들에게는 특히 공감이 갈 만한 논문입니다.
핵심 아이디어
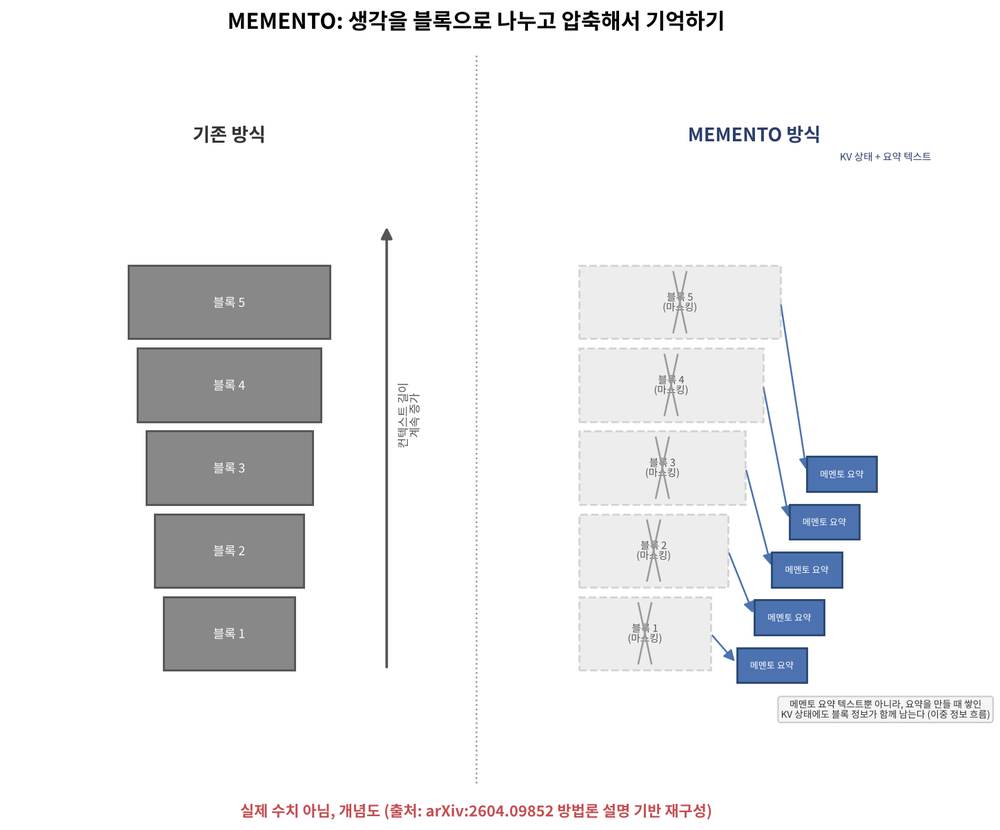
이 논문이 제안하는 방법의 이름은 MEMENTO입니다. 아이디어는 비교적 직관적입니다. 모델이 생각을 이어가다가 한 "블록(block)"이 끝나면, 그 블록 전체를 짧은 요약문, 즉 "메멘토(memento)"로 압축합니다. 그리고 이후 추론을 계속할 때는 그 블록의 원문 전체가 아니라 압축된 메멘토 요약만을 참조하도록 학습시킵니다. 사람이 긴 회의 내용을 메모 몇 줄로 정리해두고, 나중에는 메모만 보면서 다음 결정을 내리는 것과 비슷한 방식입니다(출처: arXiv:2604.09852).
이렇게 하면 모델이 실제로 "주의(attention)"를 기울여야 하는 과거 토큰의 양이 줄어들기 때문에, 컨텍스트 길이와 이를 뒷받침하는 KV 캐시 크기, 그리고 그에 따른 연산량(compute)이 함께 줄어듭니다. 저자들은 이 방법을 적용했을 때 KV 캐시의 최대 사용량이 약 2.5배 줄어들었다고 보고합니다(출처: arXiv:2604.09852). 핵심은 이 압축과 요약을 사람이 수작업으로 설계한 규칙이 아니라, 모델이 학습을 통해 스스로 수행하도록 만들었다는 점입니다.
방법론 자세히 보기
MEMENTO는 크게 데이터 구축, 학습, 추론 세 단계로 이루어져 있습니다.
먼저 데이터 구축 단계에서는, OpenThoughts-v3라는 공개 추론 데이터셋의 생각의 사슬들을 문장 단위로 나누고, 별도의 LLM이 각 문장 경계가 "블록을 끊기 좋은 지점"인지 0부터 3까지 점수를 매깁니다. 이 점수를 바탕으로 알고리즘이 실제로 블록을 자를 지점을 고르는데, 이때 λ=0.5라는 가중치와 "블록당 최소 200토큰"이라는 조건을 사용합니다. 블록이 정해지면 또 다른 LLM이 그 블록을 압축해 메멘토 요약문을 작성하고, 세 번째 LLM이 이 요약이 충분히 좋은지 10점 만점 중 8점 이상인지 심사합니다(기준을 못 넘으면 최대 두 번까지 다시 작성). 이 과정을 통해 만들어진 데이터셋이 OpenMementos로, 총 22만 8천 개의 추론 궤적에 중간 요약이 달려 있습니다(출처: arXiv:2604.09852).
학습 단계는 2단계 지도학습(SFT)으로 이루어집니다. 1단계에서는 전체 어텐션(full attention)을 그대로 사용해 모델이 요약을 생성하는 법을 배우게 하고, 2단계에서는 이미 끝난 생각 블록의 원문 토큰을 마스킹(masking)하여, 모델이 실제로 메멘토 요약만 보고도 이어서 추론할 수 있도록 학습시킵니다. 블록과 요약의 경계를 표시하기 위해 네 가지 특수 토큰(special token)을 도입했습니다(출처: arXiv:2604.09852).
추론 단계에서는 저자들이 직접 vLLM을 포크(fork)해서, 마스킹된 블록의 KV 엔트리를 실제로 메모리에서 제거하는 방식으로 구현했습니다. 이 커스텀 vLLM은 FlashAttention과 FlashInfer 같은 표준 커널을 그대로 활용합니다. 또한 이렇게 컨텍스트와 연산량이 줄어든 상태를 기반으로 강화학습(RL)을 추가로 적용했는데, Qwen3-8B 모델에 KL 페널티(β=0.001)를 둔 CISPO라는 방식을 사용했고, 모델이 "짧은 요약을 많이 만드는" 대신 "통째로 긴 블록 하나만 쓰고 요약을 회피"하는 편법을 못 쓰도록 블록 길이를 7천 토큰으로 제한했습니다(출처: arXiv:2604.09852).
실험 결과
저자들은 Qwen3-8B, Qwen3-32B, Phi-4-reasoning(14B), Olmo-3-7B-Think 네 가지 모델에 MEMENTO를 적용해 검증했으며, 데이터 스케일링과 추가 분석에는 Qwen2.5-7B-Instruct를 사용했습니다. 평가는 MathArena 계열의 11개 경시대회 수학 세트(AIME'24/25/26, HMMT, BrUMO, SMT, CMIMC를 묶어 "Comp. Math"로 집계), MATH-500, GPQA Diamond, LiveCodeBench v6에서 이루어졌고, pass@1 기준(온도 0.6, 최대 32K 토큰, 경시대회 문제당 64회 생성)으로 측정되었습니다(출처: arXiv:2604.09852).
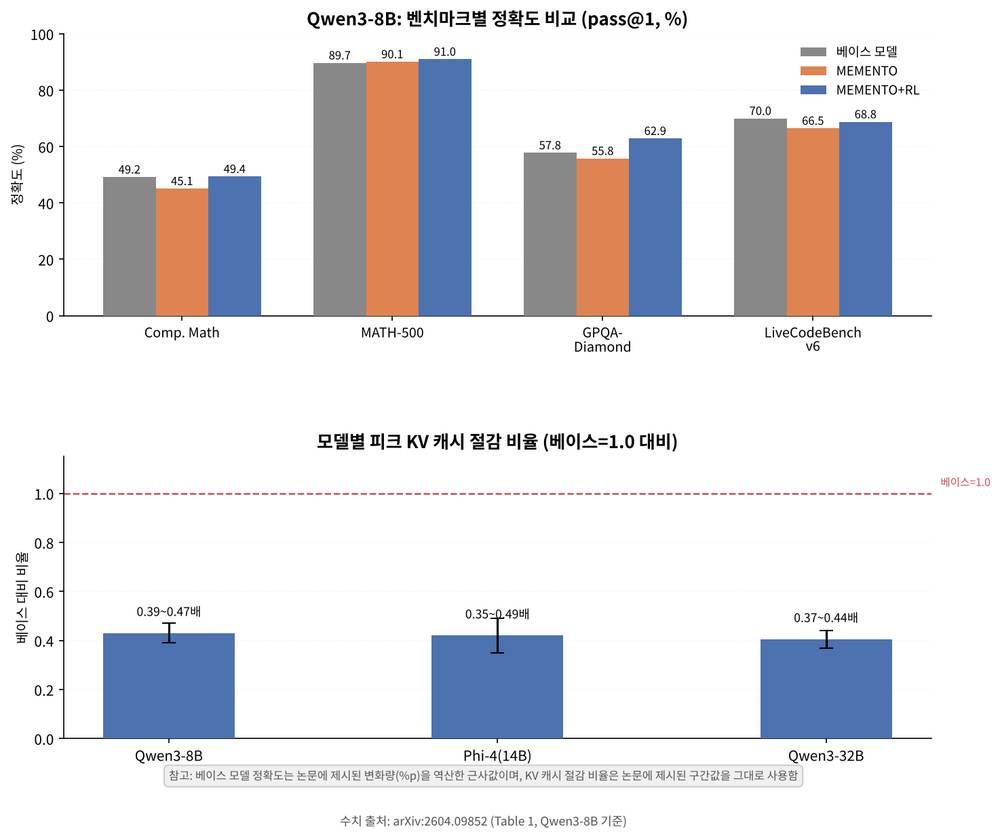
핵심 결과표를 보면, Qwen3-8B에 MEMENTO를 적용했을 때 AIME'26 점수는 57.3%로 베이스 모델(66.8%)보다 7.4%p 낮았고, Comp. Math는 45.1%(−4.1%p), MATH-500은 90.1%(+0.4%p), GPQA-Diamond는 55.8%(−2.0%p), LiveCodeBench v6는 66.5%(−3.5%p)를 기록했습니다. 반면 Qwen3-8B에 추가로 강화학습(RL)을 적용하자 AIME'26 64.9%(+0.2%p), Comp. Math 49.4%(+0.2%p), MATH-500 91.0%(+1.3%p), GPQA-Diamond 62.9%(+5.1%p)로 베이스 모델을 오히려 넘어서는 지표가 다수 나타났습니다. Qwen3-32B는 AIME'26에서 72.6%로 베이스(75.2%) 대비 2.6%p 낮았습니다. 전체적으로 다섯 개 벤치마크 그룹에 대한 평균 정확도 격차는 8B 모델에서 6.3%p, 32B 모델에서는 3.5%p로, 모델이 커질수록 성능 손실이 줄어드는 경향을 보였습니다(출처: arXiv:2604.09852).
KV 캐시 절감 효과는 모델에 따라 달랐는데, Qwen3-8B·Phi-4·Qwen3-32B에서는 피크 KV 캐시가 베이스 대비 약 0.35~0.49배 수준(즉 50% 이상 절감)까지 줄어들었지만, 슬라이딩 윈도우 어텐션(sliding-window attention) 구조를 쓰는 Olmo-3-7B는 0.85~0.93배로 절감 폭이 상대적으로 작았습니다(출처: arXiv:2604.09852). vLLM 확장을 적용한 처리량(throughput) 비교에서는 Qwen3-8B 기준 초당 2,447토큰에서 4,290토큰으로, 약 1.75배 향상되었습니다(출처: arXiv:2604.09852).
가장 흥미로운 부분은 "이중 정보 흐름"을 검증한 어블레이션(ablation)입니다. 저자들은 메멘토 요약의 KV를, 그 블록의 원문 맥락 없이 다시 계산(KV restart)해보는 실험을 했는데, 이 경우 Qwen3-8B의 AIME24 정확도가 66.1%에서 50.8%로 15.3%p나 떨어졌습니다. 즉 요약 텍스트 자체뿐 아니라, 요약을 만들 때 쌓인 KV 상태 안에도 원문 블록의 정보가 함께 녹아 있다는 뜻입니다. 이를 더 직접적으로 확인하기 위해 블록 안에 5자리 임의의 암호(passcode)를 몰래 넣고, 마스킹된 메멘토의 KV만으로 이 암호를 복원할 수 있는지 "탐침(probing)" 실험을 했는데, 8B 모델은 26.7%, 32B 모델은 23.0%의 복원율을 보였습니다(무작위로 맞출 확률은 10%). 이는 KV 상태가 단순한 연산 중간 결과가 아니라 실제로 정보를 "저장"하고 있다는 증거로 제시되었습니다(출처: arXiv:2604.09852).
왜 중요한가
이 연구가 중요한 이유는, 긴 추론 모델을 실제로 서비스할 때 가장 먼저 부딱히는 벽이 "컨텍스트가 길어질수록 메모리와 비용이 선형 이상으로 늘어난다"는 문제이기 때문입니다. MEMENTO는 이 문제를 모델 아키텍처를 완전히 새로 설계하지 않고도, 기존 모델에 지도학습과 약간의 강화학습을 추가하는 것만으로 KV 캐시를 절반 이하로 줄이고 처리량을 1.75배 끌어올리는 실용적인 해법을 제시합니다. 또한 "이중 정보 흐름" 발견은 단순한 엔지니어링 트릭을 넘어서, 트랜스포머의 KV 상태가 우리가 생각했던 것보다 더 많은 정보를 암묵적으로 담고 있다는 것을 실증적으로 보여주는 연구이기도 합니다. 이는 향후 컨텍스트 압축, 메모리 관리, 긴 호흡의 에이전트(agent) 설계 전반에 영향을 줄 수 있는 발견입니다(출처: arXiv:2604.09852).
한계
저자들이 밝힌 한계도 분명합니다. 먼저 정확도만을 보상으로 준 강화학습은 모델이 "요약을 자주 하는 대신 통째로 긴 블록 하나만 쓰는" 편법으로 흐르는 경향이 있어서, 블록 길이를 7천 토큰으로 강제 제한해야 했습니다. 또한 일부 문제에서는 마스킹을 적용했을 때 오히려 토큰 사용량이 베이스 대비 약 3배까지 늘어나는 실패 사례도 있었고, 이는 특정 예시에서 KV 사용 면적을 더 키우는 역효과로 이어졌습니다. Olmo-3처럼 슬라이딩 윈도우 어텐션을 쓰는 모델에서는 구조적으로 KV 절감 효과가 제한적이었습니다. 가장 어려운 경시대회 수학 문제에서는 여전히 pass@1 격차가 남아 있었고, 강화학습 실험은 Qwen3-8B 한 모델에만 적용되어 다른 규모나 계열의 모델로 일반화되는지는 추가 검증이 필요합니다(출처: arXiv:2604.09852).
마무리
사람이 긴 생각을 메모 몇 줄로 정리하고 나머지는 잊어버리는 것처럼, LLM도 스스로 자기 생각을 블록 단위로 압축하고 관리하도록 가르칠 수 있다는 것을 보여준 연구였습니다. 특히 요약 텍스트뿐 아니라 KV 상태 자체에도 정보가 숨어 있다는 "이중 정보 흐름" 발견은, 앞으로 컨텍스트 관리와 메모리 설계를 다루는 연구들에 계속 인용될 만한 흥미로운 결과라고 생각합니다. 이번이 시리즈 500번째 글이기도 한데, 공교롭게도 "기억을 관리하는 법"을 다룬 논문이라 의미가 남다르게 느껴졌습니다. 다음 리뷰에서도 또 다른 흥미로운 머신러닝 논문으로 찾아오겠습니다.
출처
Vasilis Kontonis, Yuchen Zeng, Shivam Garg, Lingjiao Chen, Hao Tang, Ziyan Wang, Ahmed Awadallah, Eric Horvitz, John Langford, Dimitris Papailiopoulos, "MEMENTO: Teaching LLMs to Manage Their Own Context," Microsoft Research. arXiv:2604.09852. 링크: https://arxiv.org/abs/2604.09852
(확인 및 정정 사항: arXiv 페이지와 PDF 본문을 직접 확인한 결과, 논문의 저자 전원이 Microsoft Research 소속으로 표기되어 있음을 확인했습니다. 다만 사전에 제시된 "COLM 2026"이라는 학회 정보는 arXiv 페이지(abs)나 PDF 본문 어디에도 명시적으로 등장하지 않았습니다. arXiv 분류는 cs.AI, cs.LG로만 되어 있어, 이 리뷰에서는 COLM 2026 투고/채택 여부를 arXiv 자료만으로는 확인할 수 없었다는 점을 명확히 밝힙니다. 아울러 COLM 2026에는 별도의 공식 수상(award) 목록이 없으므로, 이 리뷰에서는 어떠한 수상·최종후보 지위도 언급하지 않았습니다. 본문의 모든 수치는 arXiv:2604.09852 PDF에 제시된 Table 1 및 어블레이션 결과를 근거로 작성했습니다.)
용어 정리
- 추론 모델(Reasoning Model): 답을 바로 내지 않고, 먼저 긴 "생각의 사슬(chain-of-thought)"을 생성한 뒤 최종 답을 내는 대규모 언어 모델. 어려운 문제일수록 생각의 길이가 길어진다. - 컨텍스트 윈도우(Context Window): 모델이 한 번에 "기억"하고 참조할 수 있는 토큰(단어 조각)의 최대 범위. - KV 캐시(KV Cache): 트랜스포머 모델이 이전 토큰들에 대해 계산해둔 키(Key)와 값(Value) 벡터를 저장해두는 메모리 공간. 컨텍스트가 길어질수록 이 캐시도 함께 커진다. - 블록(Block): 이 논문에서 생각의 사슬을 나누는 단위. 하나의 추론 흐름을 의미 있는 구간별로 잘라낸 부분을 가리킨다. - 메멘토(Memento): 이 논문에서 각 블록을 압축해 만든 짧은 요약문. 이후 추론 단계에서는 원문 대신 이 메멘토만 참조한다. - OpenMementos: 이 논문이 공개한 데이터셋으로, OpenThoughts-v3에서 가져온 22만 8천 개의 추론 궤적에 중간 요약(메멘토)이 주석으로 달려 있다. - 지도 미세조정(Supervised Fine-Tuning, SFT): 정답이 주어진 데이터로 모델의 가중치를 추가로 학습시켜 특정 행동(여기서는 요약과 압축 추론)을 익히게 하는 학습 방식. - 마스킹(Masking): 모델이 특정 토큰(여기서는 이미 요약된 블록의 원문)을 더 이상 참조하지 못하도록 어텐션에서 가리는 기법. - 강화학습(Reinforcement Learning, RL): 모델이 생성한 결과에 대해 보상(정답 여부 등)을 주고, 더 높은 보상을 받도록 모델을 반복적으로 조정하는 학습 방식. 이 논문에서는 CISPO라는 방법과 KL 페널티를 함께 사용했다. - vLLM: 대규모 언어 모델을 빠르게 서비스(추론)하기 위한 오픈소스 추론 엔진. 이 논문은 이를 포크해 마스킹된 KV 엔트리를 실제로 메모리에서 제거하도록 확장했다. - 이중 정보 흐름(Dual Information Stream): 이 논문이 발견한 현상으로, 블록의 정보가 압축된 요약 텍스트뿐 아니라 그 요약을 만들 때 쌓인 KV 상태 안에도 동시에 남아있다는 것을 가리킨다. - 탐침 실험(Probing): 모델 내부 표현(여기서는 마스킹된 메멘토의 KV 상태)에 특정 정보(5자리 암호)가 얼마나 남아있는지, 별도의 분류기로 복원을 시도해 확인하는 실험 기법. - pass@1 / pass@64: 모델이 문제당 1번(또는 64번) 답을 생성했을 때 그중 정답이 몇 퍼센트인지를 나타내는 평가 지표. pass@64는 여러 번 시도했을 때 "한 번이라도" 맞출 수 있는 잠재력을 보는 지표다. - 처리량(Throughput): 추론 엔진이 초당 생성할 수 있는 토큰의 수. 높을수록 더 많은 요청을 더 빠르게 처리할 수 있다. - MathArena, AIME, GPQA, LiveCodeBench: 각각 경시대회 수학 문제 모음(MathArena, AIME), 대학원 수준의 과학 지식을 묻는 벤치마크(GPQA, Diamond는 가장 어려운 부분집합), 코딩 능력을 평가하는 벤치마크(LiveCodeBench)를 가리키는 평가용 데이터셋 이름들이다.


댓글