이 논문을 고른 이유
거대언어모델(LLM)을 실제 서비스에 쓰려면 느린 추론 속도와 큰 메모리 사용량이 항상 걸림돌입니다. 이 문제를 푸는 대표적인 방법이 프루닝(pruning, 가지치기)인데, 모델의 일부 가중치나 구조를 통째로 잘라내서 크기를 줄입니다. 그런데 모델의 어느 부분을 얼마나 잘라낼지 정하는 일은 생각보다 까다롭습니다. 어텐션(attention) 층과 MLP 층이 가지치기에 얼마나 민감한지가 서로 다르고, 층마다도 다르기 때문입니다(출처: arXiv:2502.07780).
이 논문은 "어디를 얼마나 자를지"를 사람이 일일이 정하는 대신, 생물의 진화 과정을 본뜬 탐색 알고리즘으로 자동으로 찾아냅니다. 이름도 그래서 DarwinLM입니다. 자연선택에서 환경에 잘 적응한 개체가 살아남듯, 이 방법은 여러 "가지치기 설계안(자손 모델)"을 만들어서 성능이 좋은 것만 살려두고 나머지는 버리는 과정을 반복합니다. 단순히 "지금 당장 손실이 적은 설계"가 아니라 "조금만 추가 학습을 시켜봤을 때도 잘 회복하는 설계"를 고른다는 점이 특히 흥미로워서 소개하고 싶었습니다(출처: arXiv:2502.07780).
핵심 아이디어
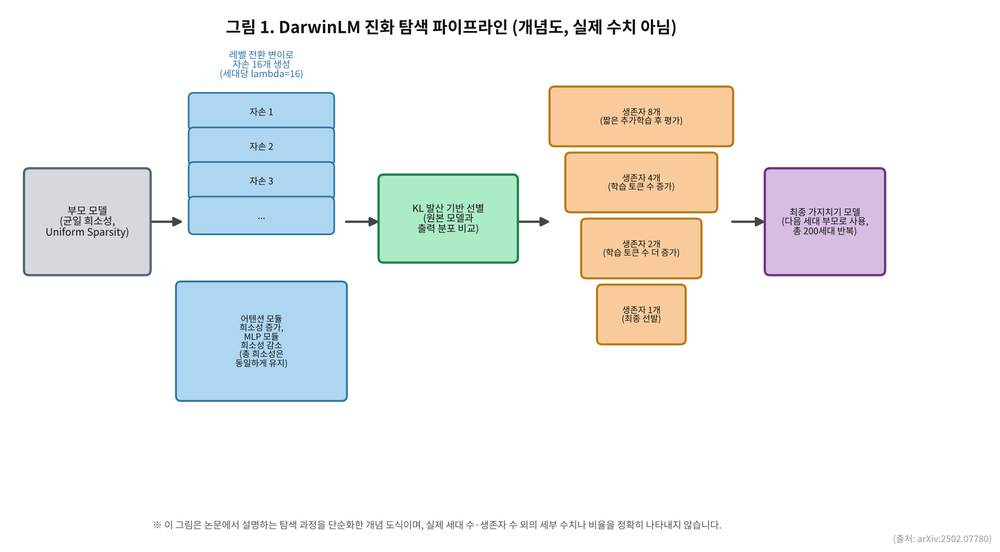
비유를 하나 들어보면, 같은 예산(총 삭감량)을 여러 부서(모델의 각 모듈)에 어떻게 배분할지 정하는 상황과 비슷합니다. 이 논문은 처음에 모든 부서에 똑같이 예산을 깎는(균일 희소성, uniform sparsity) "부모 모델"에서 출발합니다. 그다음 세대마다 "한 부서에서는 예산을 더 깎고, 다른 부서에서는 그만큼 덜 깎는" 식으로 살짝 바꿔본 여러 "자손 설계안"을 만들어 봅니다. 이걸 저자들은 "레벨 전환 변이(level switch mutation)"라고 부르는데, 전체 희소성(잘라낸 비율의 총합)은 그대로 유지한 채 모듈 간 배분만 바꾸는 것입니다. 어텐션 모듈과 MLP 모듈은 따로따로 변이를 줍니다(출처: arXiv:2502.07780).
여러 자손 설계안 중에서 어느 것을 "살릴지"는 두 가지 기준으로 정합니다. 먼저 원본(dense) 모델과 가지치기한 모델이 같은 입력에 대해 얼마나 다른 출력을 내는지를 KL 발산(KL divergence)이라는 지표로 재서 1차로 거릅니다(선행 연구 EvoPress 방식을 따름). 그다음 살아남은 후보들에게 아주 짧게 추가 학습을 시켜보고, "학습을 조금 시켰을 때 얼마나 잘 회복하는지"를 보고 다시 추립니다. 이 과정을 여러 단계에 걸쳐 반복하면서, 매 단계마다 학습에 쓰는 데이터 양을 늘리고 살아남는 후보 수는 줄여갑니다. 즉, "당장의 성능"뿐 아니라 "학습 가능성(trainability)"까지 평가에 반영한다는 것이 이 논문의 핵심 아이디어입니다(출처: arXiv:2502.07780).
방법론 자세히 보기
먼저 가지치기 자체는 구조적 가지치기(structured pruning) 방식입니다. 개별 가중치를 하나씩 없애는 비구조적 가지치기와 달리, 가중치 행렬의 행(row)이나 열(column)을 통째로 제거합니다. 어텐션은 헤드(head) 단위로, MLP는 중간 차원(intermediate dimension)을 32의 배수 단위로 잘라냅니다. 어느 행/열을 지울지, 그리고 남은 가중치를 어떻게 보정할지는 ZipLM과 Optimal Brain Surgeon이라는 기존 2차(second-order) 가지치기 기법을 바탕으로, 헤시안(Hessian) 정보를 이용해 가지치기로 생기는 오차를 보정하는 방식을 씁니다(출처: arXiv:2502.07780).
이 논문은 탐색을 빠르게 하려고 "희소성 레벨 데이터베이스"를 미리 만들어 둡니다. 각 모듈(어텐션/MLP 블록)마다 0(가지치기 없음)부터 10(해당 모듈을 100% 가지치기)까지 희소성 단계별로 미리 잘라낸 버전을 계산해 저장해 둔 뒤, 탐색 과정에서는 이 데이터베이스에서 모듈별 레벨을 골라 이어붙이기만 하면 됩니다. 어텐션과 MLP는 서로 단계 폭(step size)이 다르게 설정됩니다(출처: arXiv:2502.07780).
진화 탐색의 구체적인 설정은 200세대(generation)에 걸쳐 진행되며, 매 세대마다 16개의 자손(offspring)을 만듭니다. 선발은 4단계에 걸쳐 이뤄지는데, 각 단계를 지날 때마다 살아남는 후보 수가 8개, 4개, 2개, 1개로 줄어들고, 동시에 평가에 쓰는 학습·평가 토큰 수는 늘어납니다. 짧은 추가 학습 동안 학습률은 1e-5를 사용했습니다. 또한 그룹 쿼리 어텐션(GQA)을 쓰는 Llama-3.1과 Qwen-2.5 모델에서는 키(K)·값(V) 행렬은 가지치기에서 제외하는 "GQA 인식(GQA-aware)" 변형도 적용했습니다(출처: arXiv:2502.07780).
실험 결과
저자들은 Llama-2-7B, Llama-3.1-8B, Qwen-2.5-14B-Instruct 세 모델에 DarwinLM을 적용했습니다. 평가는 9개의 제로샷(zero-shot) 다운스트림 과제(사전 학습 없이 바로 평가하는 벤치마크, 예: ARC, PIQA, WinoGrande, HellaSwag 등을 포함)의 평균 점수로 측정했습니다(출처: arXiv:2502.07780).
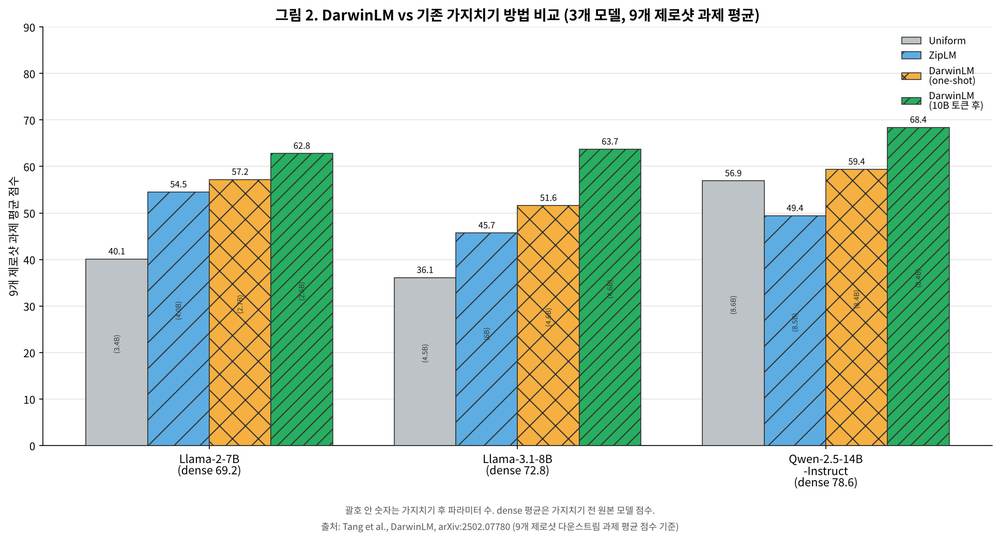
Llama-2-7B(원본 평균 69.2)의 경우, 추가 학습 없이 바로 비교한 one-shot 결과에서 균일 가지치기(Uniform, 3.4B 파라미터)는 40.1점, ZipLM(4.0B)은 54.5점, ShearedLLaMA(2.7B)는 51.0점이었던 반면, DarwinLM(2.7B)은 57.2점을 기록했습니다. 여기에 100억(10B) 개의 토큰으로 추가 학습을 시키자 DarwinLM(2.6B)은 62.8점까지 올라, 500억(50B) 토큰으로 학습한 ShearedLLaMA(2.7B, 62.6점)와 비슷하거나 더 나은 성능을 단 5분의 1의 학습 데이터로 달성했습니다. 같은 10B 토큰으로 재현한 ShearedLLaMA는 61.9점이었습니다(출처: arXiv:2502.07780).
Llama-3.1-8B(원본 평균 72.8)에서는 one-shot DarwinLM(4.6B)이 51.6점으로 균일 가지치기(4.5B, 36.1점)와 ZipLM(6B, 45.7점)을 크게 앞섰고, 10B 토큰 추가 학습 후에는 63.7점까지 올라갔습니다(참고로 2.5조 토큰으로 학습된 7B 규모 OLMO 모델이 62.9점이었습니다)(출처: arXiv:2502.07780). Qwen-2.5-14B-Instruct(원본 평균 78.6)에서는 one-shot DarwinLM(8.4B)이 59.4점, 10B 토큰 학습 후 68.4점을 기록했고, 2.05조 토큰으로 학습한 7B 규모 OLMO-0424가 67.9점이었습니다(출처: arXiv:2502.07780).
과제별로 보면 one-shot 상태에서의 차이가 특히 컸던 것이 HellaSwag였습니다. Llama-2-7B에서 균일 가지치기는 27.3점에 그쳤지만 DarwinLM은 53.5점을, Llama-3.1-8B에서는 균일 가지치기 27.1점 대비 DarwinLM 44.6점을 기록했습니다(출처: arXiv:2502.07780). 또한 학습을 고려한 선발 방식(training-aware selection, TAS)의 효과를 따로 검증한 실험에서는, 추가 학습을 전혀 하지 않은 상태에서는 TAS를 쓰든 안 쓰든 차이가 작았지만, 10억(1B) 토큰만 추가 학습해도 차이가 벌어져서 예를 들어 ARC-E 과제에서 TAS를 적용한 경우 70.8점, 적용하지 않은 경우 69.0점을 기록했습니다(출처: arXiv:2502.07780).
학습 비용 측면에서는, DarwinLM이 압축 후 성능 회복에 쓴 토큰 수가 10B로, ShearedLLaMA가 쓴 50B 토큰의 5분의 1 수준이라는 점이 강조되었습니다. 전체 압축 후 추가 학습은 H100 GPU 40개로 13시간이 걸렸다고 밝혔습니다. 실행 시간 비교 표에서는 ShearedLLaMA가 A100-80G GPU 8개로 7.4시간, DarwinLM이 L40S-48G GPU 4개로 6.9시간이 걸렸다고 보고했습니다(출처: arXiv:2502.07780).
왜 중요한가
이 연구가 의미 있는 이유는, "모델을 어떻게 자를지"를 고정된 규칙이 아니라 탐색의 대상으로 바꿨다는 점입니다. 실제로 모델의 각 부분이 가지치기에 얼마나 민감한지는 모델마다, 층마다 다른데, 사람이 직관으로 정하기보다 진화 탐색이 데이터에 기반해 더 나은 배분을 찾아낼 수 있음을 보여줍니다. 또한 "당장의 손실"이 아니라 "추가 학습 후 회복 가능성"까지 선발 기준에 넣은 것은, 압축 후 반드시 재학습(fine-tuning)을 거쳐 서비스에 투입하는 실무 환경에 더 맞는 접근입니다(출처: arXiv:2502.07780).
실용적으로도 같은 성능을 훨씬 적은 추가 학습 데이터(5분의 1 수준)로 달성했다는 점은, 모델을 가볍게 만드는 데 드는 GPU 비용과 시간을 크게 줄일 수 있다는 뜻입니다. 구조적 가지치기는 비구조적 가지치기와 달리 특수한 하드웨어나 커널 없이도 실제 추론 속도 향상으로 바로 이어지는 장점이 있어, 이런 효율성 개선은 실제 서비스 배포에 곧바로 체감될 수 있습니다(출처: arXiv:2502.07780).
한계
저자들이 부록에서 직접 밝힌 한계는 세 가지입니다. 첫째, "성능"과 "추가 학습 후 회복력"이라는 두 가지 목표를 동시에 최적화하다 보니, 특정 과제에서는 최적이 아닌 결과가 나올 수 있고, 속도(효율)에 치중한 최적화가 정확도나 견고성(robustness)을 떨어뜨릴 수도 있습니다. 둘째, 수십억 파라미터 규모의 모델을 다루는 만큼 추가 학습(fine-tuning) 자체에 여전히 상당한 연산량이 필요합니다. 셋째, 학습을 고려한 선발 방식은 자손 모델 수가 많아질수록 계산 비용이 늘어난다는 점도 저자들이 인정한 한계입니다(출처: arXiv:2502.07780).
마무리
결국 DarwinLM은 "모델의 어느 부분을 얼마나 가볍게 할지"를 사람의 직관이 아니라 진화 탐색으로 찾아내고, 그 기준에 "추가 학습 후 회복력"까지 포함시킨 시도입니다. 적은 추가 학습 데이터로도 기존 방법들을 앞서는 결과를 보여준 점이 인상적이었습니다. 다음 논문에서는 또 어떤 흥미로운 압축/효율화 접근을 만나게 될지, 계속 지켜봐 주세요.
출처
Shengkun Tang, Oliver Sieberling, Eldar Kurtic, Zhiqiang Shen, Dan Alistarh, "DarwinLM: Evolutionary Structured Pruning of Large Language Models", arXiv:2502.07780, https://arxiv.org/abs/2502.07780 (코드: https://github.com/IST-DASLab/DarwinLM) (※ 저자 소속은 MBZUAI, ETH Zurich, ISTA(오스트리아 과학기술연구소), Red Hat AI입니다. 이 글은 "COLM 2026" 투고 논문으로 소개받았으나, 확인한 arXiv 페이지(최신 버전인 v4, 2026년 7월 제출)에는 학회명이 명시적으로 표기되어 있지 않아, 학회 정보는 별도로 전달받은 사항으로 밝혀둡니다. 또한 이 논문은 COLM 2026의 공식 수상작 관련 정보가 확인되지 않아, 이 글에서는 수상 여부에 대해 언급하지 않았습니다. 추가로 원문 자체에 일부 수치 불일치가 있었는데, 예를 들어 Llama-3.1-8B의 가지치기 후 파라미터 수가 본문·표1에서는 4.6B로, 다른 표(Table 5)에서는 4.4B로 다르게 적혀 있었고, 탐색 과정의 캘리브레이션(calibration) 데이터 규모도 본문 설정 설명에서는 "최대 16개 시퀀스", 부록에서는 "4096 토큰짜리 시퀀스 2048개"로 다르게 기술되어 있었습니다. 이 글에서는 본문에 가장 일관되게 등장하는 수치를 우선 인용했습니다.)
용어 정리
- 구조적 가지치기(Structured Pruning): 신경망의 가중치를 개별적으로 지우는 것이 아니라, 행렬의 행/열, 어텐션 헤드, MLP의 중간 차원처럼 "구조 단위"로 통째로 잘라내는 모델 압축 기법. 특수 하드웨어 없이도 실제 속도 향상으로 이어지는 장점이 있음. - 진화 탐색(Evolutionary Search): 생물의 자연선택을 본뜬 최적화 기법으로, 여러 후보(개체)를 만들고 그중 성능이 좋은 것만 남겨 다음 세대로 이어가며 점점 더 나은 해를 찾는 방법. - 모델 압축(Model Compression): 모델의 크기(파라미터 수)나 연산량을 줄이면서 성능 저하를 최소화하려는 기법들을 통칭하는 말. 가지치기, 양자화, 지식증류 등이 대표적. - LLM(Large Language Model, 거대언어모델): 매우 많은 텍스트 데이터로 학습된 대규모 언어 생성/이해 AI 모델. - 희소성(Sparsity): 모델의 가중치 중 제거되어 0으로 처리되거나 아예 없는 비율. 희소성이 높을수록 더 많이 가지치기된 것. - 레벨 전환 변이(Level Switch Mutation): 이 논문에서 쓰인 변이 방식으로, 전체 희소성은 그대로 유지한 채 한 모듈의 희소성을 높이고 다른 모듈의 희소성을 같은 만큼 낮추는 방식. - KL 발산(Kullback-Leibler Divergence): 두 확률분포가 얼마나 다른지를 재는 지표. 이 논문에서는 원본 모델과 가지치기한 모델의 출력 분포 차이를 측정하는 데 쓰임. - 헤시안(Hessian) / 2차(Second-order) 가지치기: 손실 함수의 2차 미분(곡률) 정보를 활용해, 가중치를 제거했을 때 생기는 오차를 더 정밀하게 예측하고 보정하는 가지치기 기법. - 학습을 고려한 선발(Training-Aware Selection, TAS): 가지치기 직후의 성능만 보는 것이 아니라, 짧게 추가 학습을 시켜본 뒤의 회복 성능까지 평가에 반영해 후보를 선발하는 방식. - 그룹 쿼리 어텐션(Grouped Query Attention, GQA): 여러 쿼리(query) 헤드가 적은 수의 키(Key)/값(Value) 헤드를 공유하는 어텐션 구조로, 메모리 사용량과 추론 속도를 개선함. Llama-3.1, Qwen-2.5 등 최신 모델에서 사용됨. - 제로샷(Zero-shot) 평가: 해당 과제에 맞춰 별도로 추가 학습을 하지 않은 상태에서, 모델이 바로 과제를 수행하게 해 성능을 측정하는 평가 방식. - 캘리브레이션 데이터(Calibration Data): 가지치기할 부분을 정하거나 보정 계산을 할 때 참고용으로 모델에 통과시키는 소량의 샘플 데이터. - 미세조정(Fine-tuning): 이미 학습된 모델을 추가 데이터로 더 학습시켜 특정 목적에 맞게 성능을 보강하는 과정. 이 논문에서는 가지치기 후 손상된 성능을 회복시키는 데 사용됨.


댓글