CH 28 강화학습 · Part 5 보상을 사람에게서 배우다
RLHF ① 선호에서 보상모델로
27장은 시연에서 보상을 거꾸로 알아내려 했다. 이 장은 재료를 바꾼다. 사람에게 "이 답변 몇 점?"이라 묻지 않고 "둘 중 어느 쪽이 낫나"만 묻는다. 절대점수는 평가자마다·날마다 흔들리지만 쌍 비교는 흔들리지 않는다. 이 장은 그 비교 더미에서 보상함수를 꺼내는 브래들리–테리 모형을 손으로 풀고, SFT → RM → PPO 3단 파이프라인을 조립하고, KL 페널티가 붙은 목적 𝔼[r] − β·KL 의 최적해가 πref(y)·exp(r(y)/β) 에 비례함을 유도한다. 이 마지막 식이 29장 DPO 의 출발점이다.
- 01 직관
- 02 수식 읽는 법
- 03 손으로 풀기
- 04 코드
- 05 시각화
약어 및 기호 정의
- RLHF
- Reinforcement Learning from Human Feedback. 사람의 선호를 보상으로 바꿔 정책을 미세조정하는 절차
- 프롬프트 x
- 모델에 주는 입력. 토큰 단위 MDP 에서는 초기 상태에 해당한다
- 응답 y
- 모델이 생성한 토큰열 전체. 한 에피소드의 궤적 하나로 본다
- 선호쌍 (yw, yl)
- preference pair. 같은 x 에 대한 두 응답 중 사람이 이긴 쪽(win)과 진 쪽(lose)
- 브래들리–테리 BT
- Bradley–Terry(1952). P(yw ≻ yl) = σ(rw − rl). 승패를 잠재점수 차이로 설명하는 모형
- 보상모델 RM
- reward model. rφ(x,y) ∈ ℝ. 선호쌍으로 학습한 사람 취향의 대리인
- SFT
- Supervised Fine-Tuning. 사람이 쓴 시범 응답을 그대로 모방하는 1단계. 27장의 행동복제와 같은 것이다
- 기준정책 πref
- reference policy. 보통 SFT 모델을 고정해 쓴다. KL 페널티의 기준점이자 초기값
- KL 페널티 β
- β·KL(π‖πref) 의 계수. 작으면 과감하고 크면 πref 에 붙어 있는다
- 분할함수 Z(x)
- Σy πref(y|x)exp(r(x,y)/β). KL 정규화 최적해의 정규화 상수. 29장에서 DPO 가 지워 없애는 항
- 게이지 자유도 gauge freedom
- 보상 전체를 같은 상수만큼 옮겨도 모든 예측이 같은 성질. 27장 보상 비유일성과 같은 이야기
- 보상 해킹 reward hacking
- 보상모델의 점수만 올리고 실제 품질은 떨어지는 현상. 29장의 주제
직관: 점수는 흔들리지만 순서는 흔들리지 않는다
27장은 보상이 주어지지 않는 상황을 시연으로 풀었다. 전문가가 어떻게 하는지 보여 주면 그 궤적을 설명하는 보상함수를 역으로 추정할 수 있다. 그런데 "좋은 답변을 쓰는 일"에는 잘 맞지 않는다. 시연을 모으는 비용이 크고 — 사람이 직접 좋은 답변을 써야 한다 — 무엇보다 사람이 쓴 것보다 잘하는 모델을 만들 수 없다. 모방의 천장은 시연자다.
그러면 사람에게 채점을 부탁하면 어떨까. 응답 하나를 보여 주고 1점부터 7점까지 매기라고 하는 것이다. 이 방법은 실제로 써 보면 무너진다. 이유가 셋이다.
절대점수가 무너지는 세 가지 방식
1. 기준점이 사람마다 다르다. 어떤 평가자는 어지간하면 5점을 주고, 어떤 평가자는 7점을 아껴 둔다. 같은 응답이 평가자 A 에게 6점, B 에게 4점을 받는다. 점수를 평균하면 두 사람의 서로 다른 자(ruler)를 섞는 것이다.
2. 기준점이 시간에 따라 흐른다. 오늘 50개를 채점하고 나면 눈이 높아진다. 아침에 6점이던 품질이 오후에는 4점이 된다. 같은 평가자 안에서도 자가 늘어난다.
3. 맥락 효과가 크다. 직전에 본 응답이 나빴으면 다음 응답이 후하게 평가된다. 앵커링은 의식해서 막을 수 있는 편향이 아니다.
그런데 이 세 가지 문제 모두 두 응답을 나란히 놓고 "어느 쪽?"이라 물으면 대부분 사라진다. 내 자가 늘어났든 줄어들었든, 같은 자로 둘을 재면 순서는 그대로다. 맥락도 두 응답에 똑같이 작용하니 상쇄된다.
이것이 RLHF 의 첫 번째 설계 결정이다. 절대평가를 버리고 쌍 비교만 모은다. 정보량으로 보면 손해다. 7점 척도는 한 응답에 대해 약 log27 ≈ 2.8 비트를 주고, 쌍 비교는 1비트를 준다. 그런데 그 1비트는 믿을 수 있는 1비트다. 2.8비트 중 2비트가 평가자의 자에서 온 잡음이면 쓸 데가 없다.
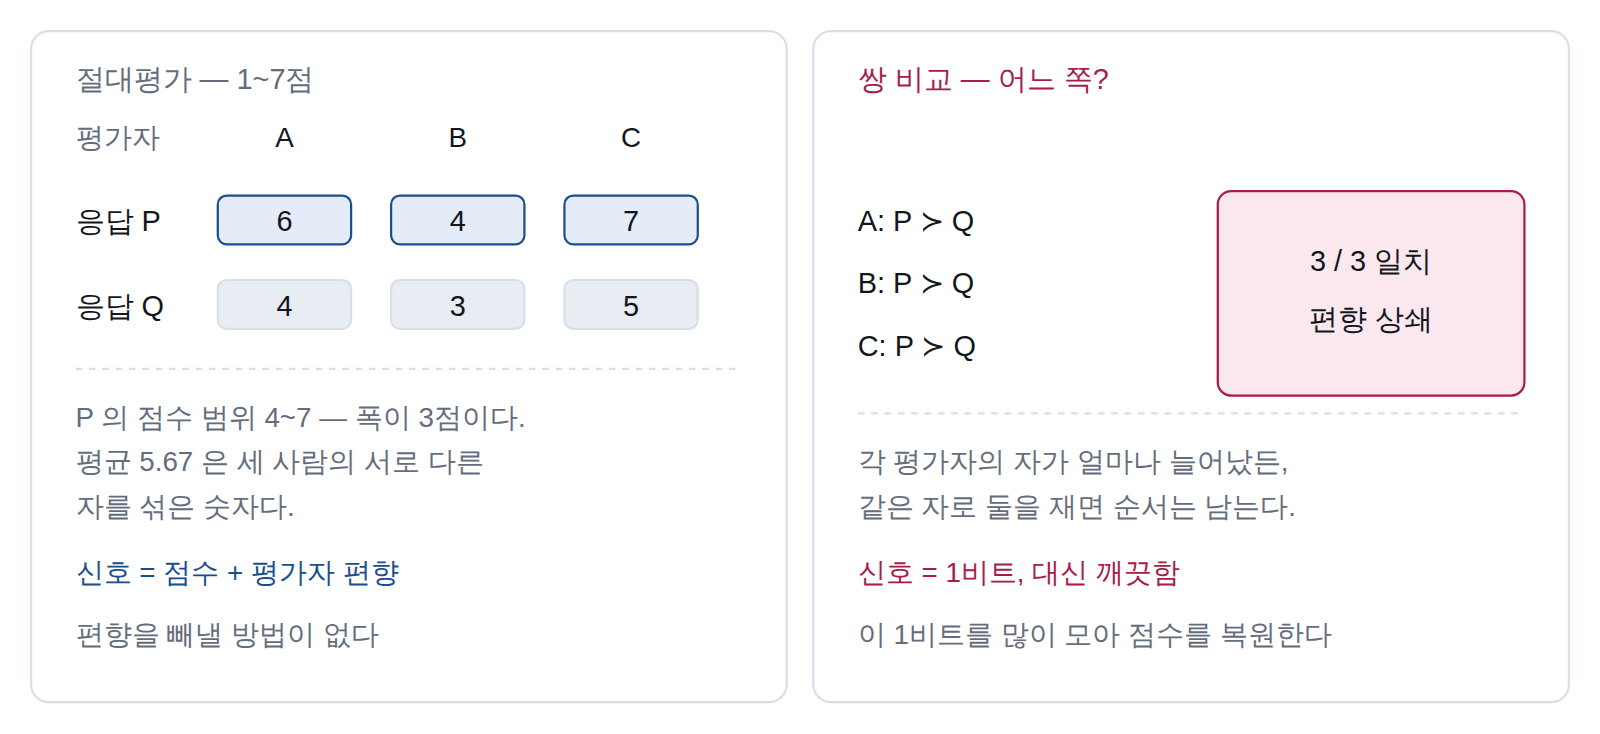
마지막 문장이 이 장의 전부다. 우리는 1비트짜리 비교를 수만 개 모아 실수값 보상함수를 역추정한다. 구조만 보면 27장의 역강화학습과 같다. 관측이 "전문가의 궤적"에서 "사람의 선호 순서"로 바뀌었을 뿐이고, 어느 쪽이든 드러나지 않은 보상을 관측 가능한 행동에서 거꾸로 읽어 내는 일이다. 그래서 27장에서 본 문제가 여기서도 그대로 돌아온다 — 보상은 유일하게 정해지지 않는다. 선호로 식별되는 것은 보상의 차이뿐이다. 이 점을 다음 절에서 못박는다.
그래서 왜 강화학습이 필요한가
보상모델만 있으면 되지 않나 — 응답을 여러 개 뽑아 점수가 가장 높은 것을 고르면 된다. 실제로 이것이 최선의 N 개 중 선택(best-of-N sampling)이고 잘 동작하지만, 추론 때마다 N 배의 계산을 쓴다. 강화학습은 그 선택을 모델 파라미터 안으로 옮긴다 — 학습 때 한 번 비용을 치르고 추론은 한 번만 생성한다. 갱신 수단은 이미 우리 손에 있다. 20장의 PPO 다. 언어모델 생성은 토큰을 하나씩 고르는 순차적 의사결정이고, PPO 는 그런 문제의 표준 정책경사다. RLHF 가 "새 알고리즘"이 아니라 새 보상 정의 + 기존 PPO 인 이유다.
수식 읽는 법: 차이만 식별된다
브래들리–테리 모형
응답 하나하나에 숨은 실수값 점수 r(x,y) 가 있다고 가정한다. 사람이 두 응답을 비교할 때, 점수가 높은 쪽을 고르지만 확정적으로는 아니다. 차이가 크면 거의 확실히, 차이가 작으면 반쯤 동전 던지기로 고른다. 이 가정을 가장 단순하게 쓴 것이 브래들리–테리 모형(Bradley–Terry model, 1952)이다.
식 (28.1) 을 읽는 요령은 오른쪽에 들어가는 것이 차이뿐이라는 데 있다. rw = 3.0, rl = 2.0 인 경우와 rw = −7.0, rl = −8.0 인 경우의 예측은 똑같이 σ(1) = 0.7311 이다. 따라서 데이터가 아무리 많아도 보상의 절대 수준은 결정되지 않는다.
27장에서 역강화학습의 해가 유일하지 않았던 것과 정확히 같은 구조다. 27장에서는 상태마다 임의의 함수 Φ(s) 를 더하는 보상 성형이 최적정책을 바꾸지 않았고, 여기서는 전역 상수 c 가 선호 확률을 바꾸지 않는다. 관측이 상대적인 양(정책의 순서, 비교의 승패)인 한, 보상의 절대 수준은 관측 밖에 있다.
보상모델의 손실과 그 기울기
선호쌍 데이터 𝒟 = {(x, yw, yl)} 에 대해 (28.1) 의 음의 로그우도를 최소화한다.
기울기를 구해 보면 이 손실이 무엇을 하는지 한눈에 보인다. Δ = rw − rl 로 줄여 쓴다.
| Δ = rw − rl | σ(Δ) = 예측 승률 | 1 − σ(Δ) = 기울기 크기 | −log σ(Δ) = 손실 | 해석 |
|---|---|---|---|---|
| −2.0 | 0.119203 | 0.880797 | 2.126928 | 순서를 거꾸로 맞혔다 — 세게 고친다 |
| 0.0 | 0.500000 | 0.500000 | 0.693147 | 판단 보류 상태. 손실 ln 2 |
| +1.0 | 0.731059 | 0.268941 | 0.313262 | 맞지만 아직 밀어 줄 여지 |
| +3.0 | 0.952574 | 0.047426 | 0.048587 | 거의 끝났다 |
| +5.0 | 0.993307 | 0.006693 | 0.006715 | 사실상 학습이 멈춘다 |
마지막 줄이 중요하다. Δ 가 커지면 기울기가 지수적으로 죽으므로, 손실은 보상을 무한히 벌리지 않는다. 쉬운 쌍은 일찍 포화되고, 애매한 쌍 — 사람도 반쯤 갈린 쌍 — 이 학습의 남은 기울기를 차지한다. 레이블 잡음이 있는 쌍은 영원히 큰 기울기를 내므로, 실무에서 선호 데이터의 품질이 보상모델 품질을 직접 결정하는 이유가 여기 있다.
3단 파이프라인
RLHF 는 단계가 셋이다. 각 단계가 쓰는 데이터와 목적이 서로 다르다는 점을 분명히 구분해야 한다.
| 단계 | 데이터 | 손실 / 목적 | 산출물 | 이 시리즈의 어디 |
|---|---|---|---|---|
| 1. SFT | 사람이 쓴 (x, y) 시범 응답 | 토큰 교차엔트로피 −Σ log π(yt|x,y<t) | πSFT → 이것이 πref 이자 초기화 | 27장 행동복제와 같다 |
| 2. RM | 같은 x 의 응답 쌍 + 사람의 선호 | BT 손실 (28.2) | rφ(x,y) 스칼라 보상 | 이 장의 손계산 절 |
| 3. PPO | 프롬프트 x 만 (응답은 모델이 생성) | 𝔼[rφ] − β·KL(π‖πref) | 정렬된 정책 πθ | 20장 PPO 를 그대로 |
3단계가 레이블 없는 프롬프트만 먹는다는 점이 이 구조의 경제성이다. 그 대가가 29장의 주제인 보상 해킹이다 — 대리인을 너무 믿으면 대리인만 만족시킨다.
3단계의 목적함수 — 보상만 올리면 안 되는 이유
3단계에서 최대화하는 것은 보상의 기댓값 하나가 아니다. 기준정책에서 멀어진 정도를 빼 준 값이다.
보상만 올리면 될 것 같은데 왜 두 번째 항을 붙이는가. 이유가 둘이고, 둘 다 실패 사례에서 나왔다.
KL 항이 있는 첫 번째 이유 — 보상모델은 좁은 곳에서만 믿을 만하다
rφ 는 사람이 아니라 사람의 대리인이고, 학습 데이터는 πref 근처에서 뽑은 응답 쌍이다. 정책이 그 영역을 벗어나면 보상모델은 외삽을 하게 되고, 외삽 구간에서 나온 높은 점수는 근거가 없다. 26장 오프라인 RL 에서 본 분포 이탈과 완전히 같은 병이다. 거기서는 Q 함수가 본 적 없는 행동을 과대평가했고, 여기서는 보상모델이 본 적 없는 응답을 과대평가한다. 치료법도 같다 — 데이터가 있는 곳 근처에 머물게 한다.
그래서 KL 항은 정규화가 아니라 대리인의 유효 범위를 지정하는 장치다. β 를 키운다는 것은 "보상모델을 덜 믿겠다"는 선언이다.
두 번째 이유 — SFT 가 쌓아 둔 것을 지킨다
πSFT 에는 보상모델이 채점하지 않는 성질 — 문법, 사실성, 어휘의 다양성 — 이 많이 들어 있다. 채점되지 않는 성질은 최적화 과정에서 거리낌 없이 희생된다. 극단은 모드 붕괴(mode collapse)다. 보상모델이 가장 좋아하는 문장 하나를 찾아내면 정책은 프롬프트와 무관하게 그 문장만 뱉는다.
KL 항은 이것을 직접 막는다. 한 응답에 확률을 몰수록 KL 이 커지고, 완전히 결정적이 되면 −log πref(y) 로 뛴다. 응답 하나의 확률이 10−30 수준인 언어모델에서 이 값은 수십 nats 이므로 β 가 작아도 붕괴는 비싸다.
19장의 TRPO 와 식의 모양이 같으니 헷갈리기 쉬운데, 기준이 다르다. TRPO 와 20장 PPO 의 KL 은 πold — 직전 갱신의 정책 — 에 대한 것이고, 매 갱신마다 기준이 따라 움직인다. 그것은 한 걸음의 크기를 재는 자다. 반면 (28.3) 의 KL 은 처음부터 끝까지 고정된 πref 를 본다. 이것은 걸음 크기가 아니라 출발점에서 총 얼마나 멀어졌는지를 재는 자다. RLHF 를 PPO 로 돌리면 두 KL 이 동시에 작동한다 — 클리핑이 한 걸음을 잡고, β 가 전체 이동거리를 잡는다.
언어 생성을 MDP 로 적기
3장에서 MDP 는 (𝒮, 𝒜, P, R, γ) 다섯 개였다. 응답 생성을 그 틀에 끼워 넣으면 이렇게 된다.
| MDP 요소 | 언어 생성에서 | 비고 |
|---|---|---|
| 상태 st | (x, y1, …, yt−1) — 프롬프트 + 지금까지 생성한 토큰열 | 상태공간이 |V|t 로 폭발한다. 표는 불가능 |
| 행동 at | 다음 토큰 yt ∈ V | 행동 개수 = 어휘 크기. 보통 104~105 |
| 전이 P | st+1 = st ⊕ yt — 이어붙이기. 확률이 없다 | 결정적. 환경 잡음이 0 이므로 잡음은 전부 정책에서 나온다 |
| 보상 R | t < T 이면 0, t = T 에서 rφ(x,y) 한 번 | 가장 희소한 형태의 보상. 신용할당이 이 장의 문제 |
| γ | 보통 1 | 길이가 유한하므로 감가하지 않아도 발산하지 않는다 |
실제 구현에서는 KL 항을 목적에 따로 두지 않고 토큰별 보상에 녹여 넣는다. KL 은 토큰마다 분해되기 때문에 이것이 가능하다.
(28.4) 를 모든 t 에 대해 더하고 πθ 로 기댓값을 취하면 정확히 (28.3) 이 된다 — 앞 항의 합의 기댓값이 −β·KL 이기 때문이다. 즉 두 식은 같은 것을 다르게 적은 것이고, (28.4) 쪽이 PPO 구현에 바로 들어간다.
그런데 뒤 항의 모양을 다시 보라. 수백 토큰을 생성하고 마지막에 스칼라 하나를 받는다. 1장에서 강화학습의 세 난점 중 첫 번째로 꼽았던 신용할당(credit assignment) 문제의 가장 순수한 형태다. 응답이 좋았다면 어느 토큰 덕분인가. 300개 토큰 중 세 번째 문단의 한 단어 선택이 결정적이었을 수도 있는데, 우리가 받은 것은 전체에 대한 점수 하나다. 6장 몬테카를로와 구조가 같고, 18장 GAE 의 λ 가 그 배분을 조절한다. 손계산 절의 마지막 계산이 이것을 숫자로 보여 준다.
손으로 풀기: 선호 13개에서 점수 세 개를 꺼낸다
1. 브래들리–테리 최대우도
응답이 셋뿐인 장난감을 만든다. 같은 프롬프트에 대한 응답 A, B, C 를 사람들이 13번 비교했고 결과는 아래와 같다. 이 숫자만 가지고 세 응답의 보상 rA, rB, rC 를 추정한다.
| 비교 | 앞이 이김 | 뒤가 이김 | 합 | 관측 승률 |
|---|---|---|---|---|
| A vs B | 3 | 1 | 4 | 0.7500 |
| A vs C | 2 | 1 | 3 | 0.6667 |
| B vs C | 4 | 2 | 6 | 0.6667 |
| 승수 합계 — A: 3+2 = 5 · B: 1+4 = 5 · C: 1+2 = 3 (합 13) | ||||
음의 로그우도는 (28.2) 를 이 데이터에 그대로 적은 것이다. nij 를 "i 가 j 를 이긴 횟수"라 쓴다.
1차 조건을 세운다. 앞서 본 d log σ(Δ)/dΔ = 1 − σ(Δ) = σ(−Δ) 만 쓰면 된다.
이 두 식은 닫힌 꼴로 풀리지 않는다. 뉴턴법으로 풀면 아래 값이 나온다. 손으로는 검산만 하면 된다.
| 응답 | r (추정) | er | 실제 승수 | 기대 승수 |
|---|---|---|---|---|
| A | 1.198002 | 3.313490 | 5 | 5.000000 |
| B | 0.472247 | 1.603593 | 5 | 5.000000 |
| C | 0.000000 (고정) | 1.000000 | 3 | 3.000000 |
검산 — 1차 조건 두 줄
rA − rB = 1.198002 − 0.472247 = 0.725755 이고 σ(0.725755) = 0.673873, σ(1.198002) = 0.768169 다.
A 의 식: 4 × 0.673873 + 3 × 0.768169 = 2.695492 + 2.304508 = 5.000000 ✓
B 의 식: σ(−0.725755) = 0.326127, σ(0.472247) = 0.615915 이므로 4 × 0.326127 + 6 × 0.615915 = 1.304508 + 3.695492 = 5.000000 ✓
C 의 식(자동으로 맞아야 한다): 3 × 0.231831 + 6 × 0.384085 = 0.695492 + 2.304508 = 3.000000 ✓
최소 NLL 은 ℒ* = 8.146215 다. 비교 13번에 대해 응답당 평균 8.146215 / 13 = 0.626632 nats — ln 2 = 0.693147 보다 조금 낮다. 동전 던지기보다 약간 나은 설명력이라는 뜻이고, 데이터가 13개뿐이니 당연한 결과다.
게이지를 고정하지 않으면 어떻게 되나
앞 절의 주장을 숫자로 확인한다. 세 보상을 통째로 옮겨 보면 NLL 이 소수점 열 자리까지 같다.
ℒ(3.698002, 2.972247, 2.500000) = 8.1462145665 ← 전부 +2.5
ℒ(-5.801998, -6.527753, -7.000000) = 8.1462145665 ← 전부 −7.0
완전히 같은 값이다. 최적화기 입장에서 (1,1,1) 방향은 곡률이 정확히 0 인 평평한 골짜기이고, 헤시안이 특이행렬이라 뉴턴법이 죽는다. 그래서 실무 보상모델 코드에는 예외 없이 게이지 고정 장치가 들어 있다 — 배치 평균을 빼거나, λ‖r‖² 를 더하거나, 기준 응답을 0 으로 못박는다. 이 장의 코드는 10−6(Σr)² 라는 아주 약한 항을 썼다. 평평한 방향만 잡고 나머지 최적해는 건드리지 않게 하려는 것이다.
2. 모형이 맞힌 것과 못 맞힌 것
추정한 r 로 승률을 다시 예측하고 관측 빈도와 비교한다.
| 쌍 | Δ = ri − rj | 모형 σ(Δ) | 관측 빈도 | 모형 기대승수 | 실제 승수 |
|---|---|---|---|---|---|
| A ≻ B | 0.725755 | 0.673873 | 3/4 = 0.750000 | 2.695492 | 3 |
| A ≻ C | 1.198002 | 0.768169 | 2/3 = 0.666667 | 2.304508 | 2 |
| B ≻ C | 0.472247 | 0.615915 | 4/6 = 0.666667 | 3.695492 | 4 |
세 쌍 모두 어긋난다. 그런데 각 응답의 총 승수는 정확히 맞는다(위 표의 기대 승수 합계: A 2.695492+2.304508 = 5, B 1.304508+3.695492 = 5, C 0.695492+2.304508 = 3). 이것이 1차 조건이 말하던 바다.
왜 쌍별로는 못 맞히는가 — 자유도 세기
관측된 쌍별 빈도는 세 개인데, 게이지를 고정한 모형의 자유 파라미터는 두 개다. 셋을 둘로 설명하려니 하나가 남는다. BT 가 강제하는 것은 이행성이다 — ΔAB + ΔBC = ΔAC 가 자동으로 성립한다. 실제로 0.725755 + 0.472247 = 1.198002 로 정확히 맞는다.
관측 빈도는 이 제약을 만족할 이유가 없다. 관측대로면 σ−1(0.75) + σ−1(2/3) = 1.098612 + 0.693147 = 1.791759 인데 σ−1(2/3) = 0.693147 이므로 어긋난다. 최대우도는 이 어긋남을 비교 횟수로 가중해 절충한 지점이다. B vs C 가 6번으로 가장 많이 비교됐으므로 그쪽 빈도에 가장 크게 끌려간다.
실무에서 비이행적 선호(A≻B, B≻C, C≻A)가 데이터에 섞여 들어오면 BT 는 그것을 표현할 수 없고, 세 응답의 점수를 비슷하게 만들어 "잘 모르겠다"고 답한다. 사람의 선호가 실제로 비이행적인 영역 — 취향이 갈리는 창작물 같은 것 — 에서 보상모델이 흐려지는 이유다.
3. KL 이 얼마나 큰 수인가
β 를 고르려면 KL 이 어느 정도 크기의 수인지 감이 있어야 한다. 어휘가 셋뿐인 장난감으로 재 본다. πref = (0.5, 0.3, 0.2) 로 두고 KL(π‖πref) = Σy π(y) log(π(y)/πref(y)) 를 정확히 계산한다(단위는 nats).
| π | KL(π‖πref) | 해석 |
|---|---|---|
| (0.5, 0.3, 0.2) | 0.000000 | 기준 그대로 |
| (0.7, 0.2, 0.1) | 0.085123 | 눈에 띄게 바뀌었는데도 0.1 이 안 된다 |
| (0.9, 0.08, 0.02) | 0.377216 | 거의 한쪽으로 몰았을 때 |
| (0.98, 0.01, 0.01) | 0.595516 | |
| (1, 0, 0) | 0.693147 | 결정적. = ln(1/0.5) |
| (0, 0, 1) | 1.609438 | 이 문제의 최대 KL. = ln(1/0.2) |
마지막 두 줄이 계산의 뼈대다. 정책이 y 하나에 확률 1 을 주면 KL = 1·log(1/πref(y)) = −log πref(y) 이므로, KL 의 최댓값은 기준정책이 가장 낮게 보던 선택지의 놀라움이다. 어휘가 셋이면 최대 1.61 nats 밖에 안 된다.
역산 — 보상 1.0 을 얻으려면 KL 을 얼마까지 써도 되나
(28.3) 의 목적은 𝔼[r] − β·KL 이다. 보상이 1.0 올랐을 때 목적이 손해를 보지 않으려면 β·KL ≤ 1.0, 즉 KL ≤ 1.0/β 여야 한다.
β = 0.1 → KL ≤ 10.0 nats · β = 0.02 → KL ≤ 50.0 nats.
그런데 이 장난감에서 가능한 KL 의 최댓값이 1.609438 이다. 두 경우 모두 한계에 한참 못 미친다 — 즉 어휘 3개짜리 문제에서 β = 0.02 나 0.1 은 사실상 아무것도 막지 않는다. 정책은 보상이 가장 높은 토큰에 전부 몰아도 이득이다.
실제 언어모델에서 이 수치가 의미를 갖는 이유는 규모가 다르기 때문이다. KL 을 재는 대상이 토큰 하나가 아니라 응답 전체(수백 토큰의 합)이고, 어휘가 104 이상이라 토큰 하나를 못박는 데 드는 KL 도 훨씬 크다. 응답 수준 KL 이 수십 nats 에 이르므로 β 를 0.01~0.1 사이에 둔다. 여기서 얻을 교훈은 숫자 자체가 아니라 β 의 의미는 KL 을 무엇에 대해 재느냐에 전적으로 의존한다는 점이다. 토큰당 평균 KL 에 곱하는지 응답 전체 KL 에 곱하는지만 바뀌어도 같은 β 가 수백 배 다르게 작동한다.
4. KL 정규화된 최적 정책 — 이 장에서 가장 중요한 식
(28.3) 에서 π 를 자유롭게 고를 수 있다면, 즉 신경망의 표현력 제약을 무시한다면, 최적해가 닫힌 꼴로 나온다. 프롬프트 x 를 하나 고정하고 유도한다.
최적값도 깔끔하게 나온다. (28.5) 를 뒤집으면 r(y) = β log(π*(y)/πref(y)) + β log Z 이고, 이것을 π* 로 평균 내면 𝔼π*[r] = β·KL(π*‖πref) + β log Z 이므로
숫자로 확인
πref = (0.5, 0.3, 0.2), r = (1.0, 0.0, −0.5) 로 두고 β = 0.1 과 β = 1 을 계산한다. 비정규화 가중치 πref(y)er(y)/β 를 먼저 구하면 된다.
β = 0.1 — 지수가 10배로 증폭된다
r/β = (10, 0, −5) 이므로 가중치는
0.5·e10 = 0.5 × 22026.465795 = 11013.232897 · 0.3·e0 = 0.300000 · 0.2·e−5 = 0.2 × 0.00673795 = 0.001348
Z = 11013.534245. 나누면 π* = (0.99997264, 0.00002724, 0.00000012).
확인: 𝔼[r] = 0.999973, KL = 0.692846, 목적 = 0.999973 − 0.1 × 0.692846 = 0.930688. 그리고 β log Z = 0.1 × 9.306880 = 0.930688 — 일치한다. ✓
β = 1 — 기준정책의 모양이 상당히 남는다
r/β = (1, 0, −0.5) 이므로 가중치는
0.5·e1 = 1.359141 · 0.3 · 0.2·e−0.5 = 0.2 × 0.606531 = 0.121306
Z = 1.780447. 나누면 π* = (0.763371, 0.168497, 0.068132).
확인: 𝔼[r] = 0.763371 − 0.5 × 0.068132 = 0.729305, KL = 0.152441, 목적 = 0.729305 − 0.152441 = 0.576864. 그리고 log Z = log 1.780447 = 0.576864. ✓
| β | π*(y1) | π*(y2) | π*(y3) | 𝔼[r] | KL | J* = β log Z |
|---|---|---|---|---|---|---|
| 0.1 | 0.999973 | 0.000027 | <10−6 | 0.999973 | 0.692846 | 0.930688 |
| 0.3 | 0.976468 | 0.020901 | 0.002632 | 0.975152 | 0.586506 | 0.799200 |
| 0.5 | 0.908170 | 0.073744 | 0.018086 | 0.899127 | 0.395076 | 0.701589 |
| 1.0 | 0.763371 | 0.168497 | 0.068132 | 0.729304 | 0.152440 | 0.576864 |
| 5.0 | 0.559420 | 0.274809 | 0.165771 | 0.476534 | 0.007599 | 0.438538 |
| 100 | 0.502999 | 0.298797 | 0.198204 | 0.403897 | 0.000019 | 0.401949 |
β = 0.1 줄을 보라. KL 이 0.692846 으로 결정적 정책의 한계 0.693147 에 거의 닿았다. 위 KL 역산에서 예고한 그대로다 — 어휘 셋짜리 문제에서 β = 0.1 은 붕괴를 막지 못한다. 반대로 β = 5 에서는 KL 이 0.0076 밖에 안 되고 𝔼[r] 도 0.4765 에 그친다 — 보상을 거의 포기한 것이다.
29장 예고 — 이 식을 뒤집으면 보상모델이 사라진다
(28.5) 를 r 에 대해 풀면 r(x,y) = β log(π*(y|x)/πref(y|x)) + β log Z(x) 다. 이제 이 r 을 BT 손실 (28.2) 의 rw − rl 에 넣어 본다. 두 응답이 같은 프롬프트 x 에서 나왔으므로 β log Z(x) 가 똑같이 들어가 깨끗이 소거된다.
오른쪽에 보상모델이 없다. 정책과 기준정책만 있다. 이것을 −log σ(·) 에 넣으면 선호 데이터로 정책을 직접 학습하는 손실이 되고, 그것이 29장의 DPO 다. 2단계(RM)와 3단계(PPO)가 한 단계로 접힌다. 계산하기 어려운 Z(x) 가 사라지는 이 한 줄이 DPO 의 전부라고 해도 과하지 않다.
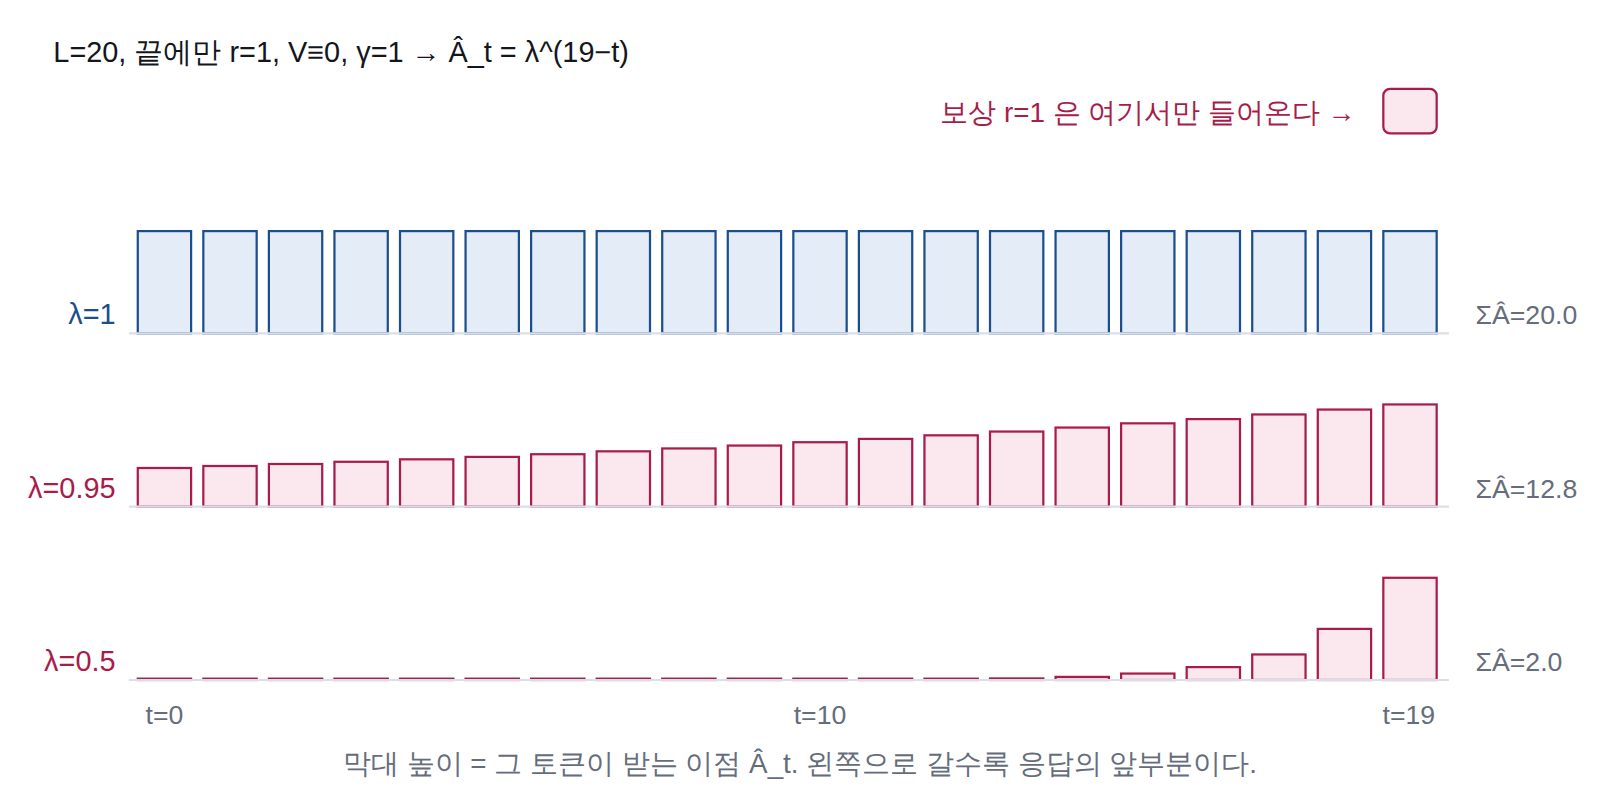
5. 마지막 토큰의 보상을 스무 개 토큰에 나누기
길이 L = 20 의 응답을 만들었고, 보상은 마지막에 rφ = 1.0 한 번만 들어온다. 가치함수가 아직 아무것도 배우지 못해 V ≡ 0 이고 γ = 1 이라 하자. TD 오차는
18장의 GAE 는 Ât = Σk≥0 (γλ)k δt+k 다. δ 가 마지막 하나뿐이므로 합이 항 하나로 줄어든다.
| λ | Â0 (첫 토큰) | Â10 | Â18 | Â19 (마지막) | Σt Ât |
|---|---|---|---|---|---|
| 1.00 | 1.000000 | 1.000000 | 1.000000 | 1.000000 | 20.0000 |
| 0.95 | 0.377354 | 0.630249 | 0.950000 | 1.000000 | 12.8303 |
| 0.90 | 0.135085 | 0.387420 | 0.900000 | 1.000000 | 8.7842 |
| 0.50 | 0.000002 | 0.001953 | 0.500000 | 1.000000 | 2.0000 |
첫 줄이 λ=1 이다. 스무 개 토큰 전부가 똑같이 +1 의 이점을 받는다. 응답이 좋았다는 이유로 첫 토큰의 선택도, 마지막 토큰의 선택도 똑같이 강화된다. 이것은 6장 몬테카를로와 정확히 같고, 편향이 없는 대신 어느 토큰이 실제로 기여했는지 구분하지 못한다. 잡음이 많은 토큰까지 같이 밀려 올라가므로 분산이 크다.
λ 를 내리면 크레딧이 뒤쪽으로 쏠린다. λ = 0.95 에서 첫 토큰은 마지막 토큰의 37.7% 만 받고, λ = 0.5 에서는 0.0002% — 사실상 아무 신호도 못 받는다. 여기서 V ≡ 0 이므로 이 감쇠는 순수한 편향이다. V 가 잘 학습되면 앞쪽 토큰의 크레딧을 V 가 대신 전달해 주어 편향이 줄지만, 학습 초기에는 이 표가 실제 상황에 가깝다.
길이가 길어지면 이 문제가 심각해진다
λ = 0.95 는 게임 환경에서 표준처럼 쓰이는 값이다. 길이 20 에서는 첫 토큰이 37.7% 를 받으니 괜찮다. 그런데 응답 길이가 200 이면 0.95199 = 3.69×10⁻⁵ 다. 앞 문단 전체가 학습 신호를 못 받는다.
그래서 RLHF 구현에서는 γ = 1 과 함께 λ 를 1 에 가깝게 두거나 아예 λ = 1 로 두는 선택이 흔하다. 대신 늘어난 분산은 (28.4) 의 밀집 KL 항과 가치함수, 그리고 배치 크기로 감당한다. 29장에서 볼 GRPO 는 여기서 한 발 더 나가 가치함수를 아예 없애고 같은 프롬프트에 대한 여러 응답의 보상 평균을 기저선으로 쓴다 — 16장에서 본 기저선 아이디어를 응답 그룹에 적용한 것이다.
코드: 손계산을 재현하고, 작은 언어모델에 붙여 본다
세 조각이다. (a) 브래들리–테리 최대우도를 경사하강으로 풀어 앞 절의 표를 재현하고, (b) KL 정규화 최적해를 닫힌식과 수치최적화 양쪽으로 구해 일치를 확인하고, (c) 문자 네 개짜리 장난감 언어모델에 선호 학습을 통째로 돌린다. 전부 시드를 고정했고 CPU 2코어에서 2분 남짓 걸린다.
import numpy as np, torch
torch.manual_seed(0); np.random.seed(0)
torch.set_num_threads(2)
D = [(0,1,3),(1,0,1),(0,2,2),(2,0,1),(1,2,4),(2,1,2)]   # (이긴쪽, 진쪽, 횟수)
r = torch.zeros(3, requires_grad=True)
opt = torch.optim.Adam([r], lr=0.05)
for it in range(6000):
    opt.zero_grad()
    loss = sum(-n*torch.nn.functional.logsigmoid(r[w]-r[l]) for w,l,n in D)
    loss = loss + 1e-6*(r.sum())**2              # 상수 이동 자유도만 고정(게이지)
    loss.backward(); opt.step()
rr = (r - r[2]).detach().numpy()                 # r_C = 0 으로 평행이동
print("(a) BT MLE  r_A=%.6f r_B=%.6f r_C=%.6f   NLL=%.6f"
      % (*rr, sum(-n*np.log(1/(1+np.exp(-(rr[w]-rr[l])))) for w,l,n in D)))
for i,j in [(0,1),(0,2),(1,2)]:
    nij = next(n for w,l,n in D if (w,l)==(i,j))
    nji = next(n for w,l,n in D if (w,l)==(j,i))
    print("    P(%s>%s) 모형 %.4f   관측 %d/%d = %.4f"
% ("ABC"[i],"ABC"[j], 1/(1+np.exp(-(rr[i]-rr[j]))), nij, nij+nji, nij/(nij+nji)))P(A>B) 모형 0.6740 관측 3/4 = 0.7500
P(A>C) 모형 0.7682 관측 2/3 = 0.6667
P(B>C) 모형 0.6158 관측 4/6 = 0.6667
손계산 절의 뉴턴해 (1.198002, 0.472247) 와 소수 셋째 자리까지 같다. 차이는 게이지 항 10−6(Σr)² 이 해를 아주 미세하게 끌어당긴 탓이고, NLL 은 8.146214 로 최소값 8.146215 와 사실상 구분되지 않는다. 게이지 항을 빼면 r 이 (1,1,1) 방향으로 정처 없이 떠다니지만 r - r[2] 로 평행이동한 결과는 같다 — 직접 확인해 볼 만하다.
pref = torch.tensor([0.5,0.3,0.2]); rv = torch.tensor([1.0,0.0,-0.5])
print("\n(b) pi* = softmax(log pi_ref + r/beta)")
for beta in [0.1, 0.3, 1.0]:
    closed = torch.softmax(torch.log(pref) + rv/beta, 0)      # 식 (28.5)
    z = torch.zeros(3, requires_grad=True); o = torch.optim.Adam([z], lr=0.05)
    for _ in range(20000):                                    # 목적을 직접 최대화
        o.zero_grad(); p = torch.softmax(z,0)
        J = (p*rv).sum() - beta*(p*(torch.log(p)-torch.log(pref))).sum()
        (-J).backward(); o.step()
    p = torch.softmax(z,0).detach()
    print("  beta=%-4s 닫힌식 %s  경사 %s  |차| %.2e  beta*lnZ=%.6f"
          % (beta, np.array2string(closed.numpy(), precision=6),
             np.array2string(p.numpy(), precision=6),
             (closed-p).abs().max().item(),
beta*torch.logsumexp(torch.log(pref)+rv/beta,0).item()))beta=0.1 닫힌식 [9.999726e-01 2.723922e-05 1.223576e-07] 경사 [9.999726e-01 2.724351e-05 1.698816e-07] |차| 4.75e-08 beta*lnZ=0.930688
beta=0.3 닫힌식 [0.976468 0.020901 0.002632] 경사 [0.976468 0.020901 0.002632] |차| 3.73e-09 beta*lnZ=0.799200
beta=1.0 닫힌식 [0.763371 0.168497 0.068132] 경사 [0.763371 0.168497 0.068132] |차| 0.00e+00 beta*lnZ=0.576865
세 β 모두 앞 절의 표와 일치하고, 닫힌식과 수치최적화의 차이는 10−8 이하다. 그리고 β log Z 가 최적 목적값과 같다는 것도 확인된다(0.930688, 0.799200, 0.576865).
둘째 줄의 코드가 (28.5) 의 실무 형태다 — π* = softmax(log πref + r/β). 로그확률에 보상을 β 로 나누어 더하고 다시 정규화하는 한 줄이다. 이 형태는 제어된 디코딩(controlled decoding)에서 그대로 쓰이고, 21장 SAC 의 π ∝ exp(Q/α) 와도 같은 구조다. 그때 πref 자리에 균등분포를 넣으면 두 식이 문자 그대로 같아진다.
V, T = 4, 4                                     # 어휘 abcd, 길이 4
def sample(logits, n):                          # bigram 정책: 상태=직전 문자(BOS=4)
    s = torch.full((n,), V, dtype=torch.long); out, lp = [], 0.0
    for _ in range(T):
        d = torch.distributions.Categorical(logits=logits[s])
        a = d.sample(); lp = lp + d.log_prob(a); out.append(a); s = a
    return torch.stack(out,1), lp
ref = torch.randn(V+1, V)*0.8                   # pi_ref: 고정된 무작위 기준모델
def truth(x): return (x==3).float().sum(1)      # 사람의 잠재 기준 = 'd' 개수
x1,_ = sample(ref, 4000); x2,_ = sample(ref, 4000)      # pi_ref 로 응답 쌍 생성
m = truth(x1) != truth(x2)                              # 동점 쌍은 버린다
w = torch.where(truth(x1[m])>truth(x2[m]), 1, 0)        # 사람의 선호 레이블
win = torch.where(w[:,None].bool(), x1[m], x2[m]); los = torch.where(w[:,None].bool(), x2[m], x1[m])
ntr = int(0.8*len(win))
RM = torch.nn.Sequential(torch.nn.Linear(V*T,16), torch.nn.Tanh(), torch.nn.Linear(16,1))
oh = lambda x: torch.nn.functional.one_hot(x, V).float().flatten(1)
orm = torch.optim.Adam(RM.parameters(), lr=0.01)
for _ in range(600):                                    # 2단계: BT 손실로 RM 학습
    orm.zero_grad()
    l = -torch.nn.functional.logsigmoid(RM(oh(win[:ntr]))-RM(oh(los[:ntr]))).mean()
    l.backward(); orm.step()
for beta in [0.05, 0.5, 3.0]:                           # 3단계: 정책경사 + KL 페널티
    pol = ref.clone().requires_grad_(True); op = torch.optim.Adam([pol], lr=0.05)
    for _ in range(400):
        op.zero_grad(); x, lp = sample(pol, 256)
        with torch.no_grad(): rew = RM(oh(x)).squeeze(1)
        kl = ((torch.softmax(pol,1)*(torch.log_softmax(pol,1)-torch.log_softmax(ref,1))).sum(1)).mean()
        adv = rew - rew.mean()                          # 16장 기저선
(-(adv.detach()*lp).mean() + beta*kl*T).backward(); op.step()beta=0.05 'd' 개수 pi_ref 0.906 -> pi 3.974 전부 d 비율 0.000 -> 0.978 평균KL/토큰 1.3092
beta=0.5 'd' 개수 pi_ref 0.913 -> pi 3.643 전부 d 비율 0.000 -> 0.656 평균KL/토큰 0.9288
beta=3.0 'd' 개수 pi_ref 0.900 -> pi 1.981 전부 d 비율 0.000 -> 0.005 평균KL/토큰 0.3085
읽을 것이 넷이다.
(c) 의 결과에서 읽을 것
1. 보상모델이 선호를 복원했다. 사람의 진짜 기준은 "문자 d 가 몇 개인가"인데, 보상모델은 그 기준을 한 번도 보지 못했다. 1983개의 승패 레이블만 봤다. 그런데 보류한 쌍에서 정확도 1.000 이다. 1비트짜리 비교를 충분히 모으면 실수값 기준이 복원된다는 첫 절의 주장이 여기서 확인된다.
2. 보상의 절대 수준은 여전히 의미가 없다. r 의 범위 [−8.75, 11.18] 에는 아무 의미가 없고, 시드를 바꾸면 통째로 옮겨 간다. 그래서 3단계에서 adv = rew − rew.mean() 로 배치 평균을 빼고 쓴다.
3. β 가 정확히 예상대로 작동한다. 기준정책에서 d 의 개수는 평균 0.9 개였다(무작위라면 4 × 0.25 = 1.0 근처가 맞다). β=0.05 면 3.974 까지 올라가고 응답의 97.8% 가 dddd 가 된다 — 모드 붕괴다. β=0.5 면 3.643, β=3.0 이면 1.981 로 기준정책에 훨씬 가깝게 머문다.
4. 붕괴가 KL 로 그대로 드러난다. 토큰당 평균 KL 이 1.3092 → 0.9288 → 0.3085 로 β 에 따라 단조롭게 줄었다. β=0.05 의 1.31 nats 는 어휘가 4개일 때 가능한 최대치 log 4 = 1.386 에 육박한다. KL 을 로그로 찍어 두면 붕괴를 사후가 아니라 학습 중에 잡을 수 있다는 것이 여기서 얻을 실무 교훈이다.
이 장난감에서 β=0.05 의 결과는 사실 "성공"이다 — 사람의 기준이 진짜로 d 의 개수였으니, dddd 를 내놓는 정책이 옳다. 실제 RLHF 에서 이 상황이 재앙인 이유는 보상모델이 사람의 기준과 다르기 때문이다. 보상모델의 최댓값은 사람이 원하던 것이 아니라 보상모델의 허점인 경우가 많다. 29장이 그 이야기다.
시각화: 파이프라인·시그모이드·끌림·크레딧
도해 1 에서 이미 이 장의 출발점 — 절대평가를 버리고 쌍 비교를 택하는 이유 — 을 보았다. 여기서는 나머지 네 그림으로 파이프라인 전체와 세 개의 핵심 곡선을 정리한다.
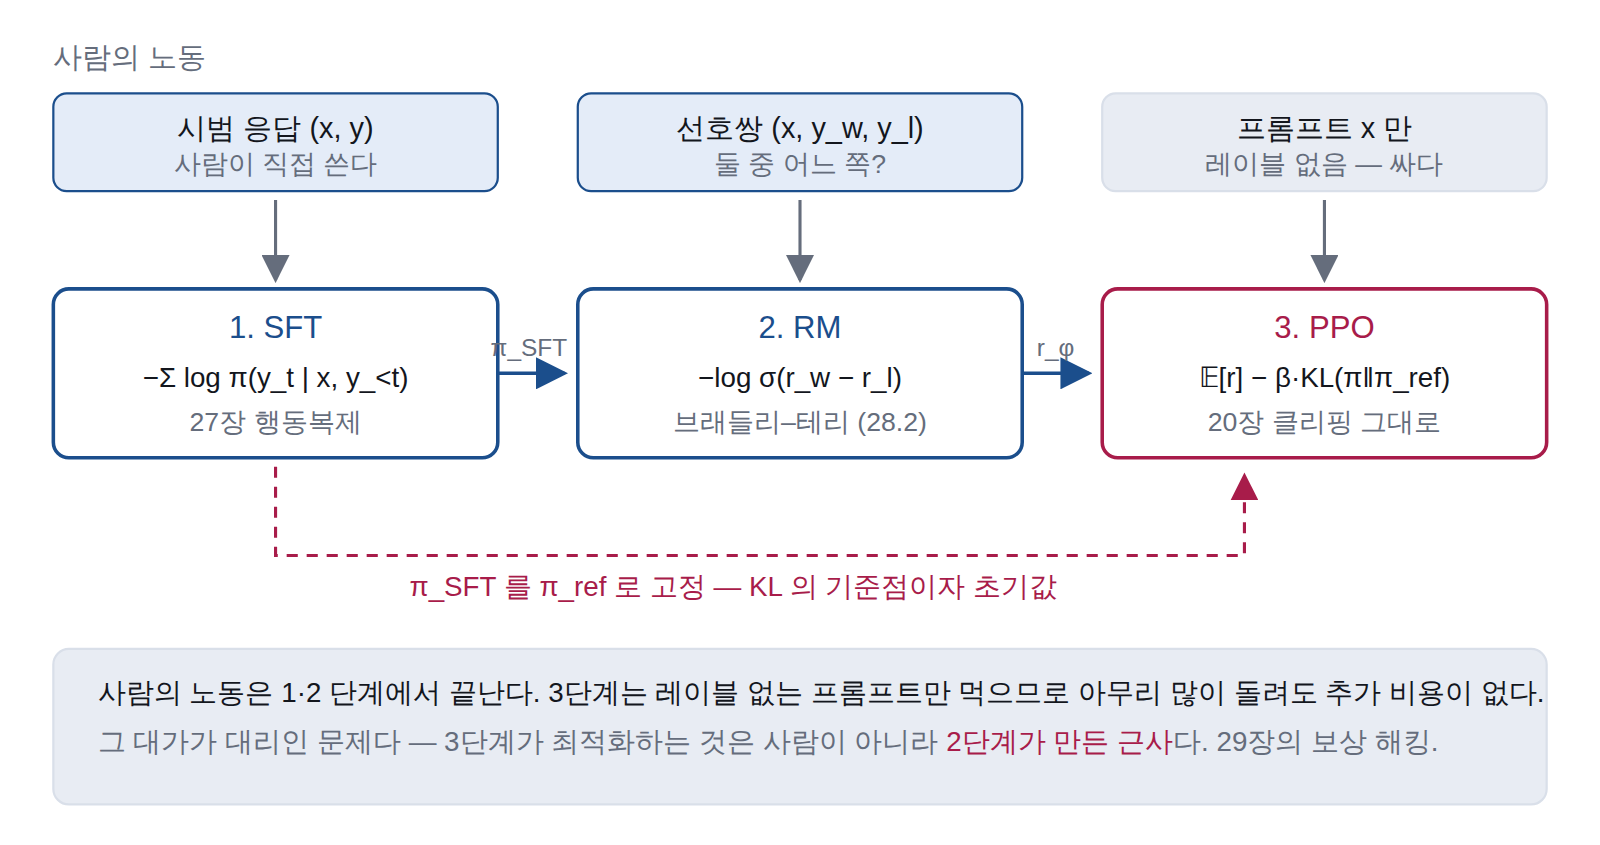
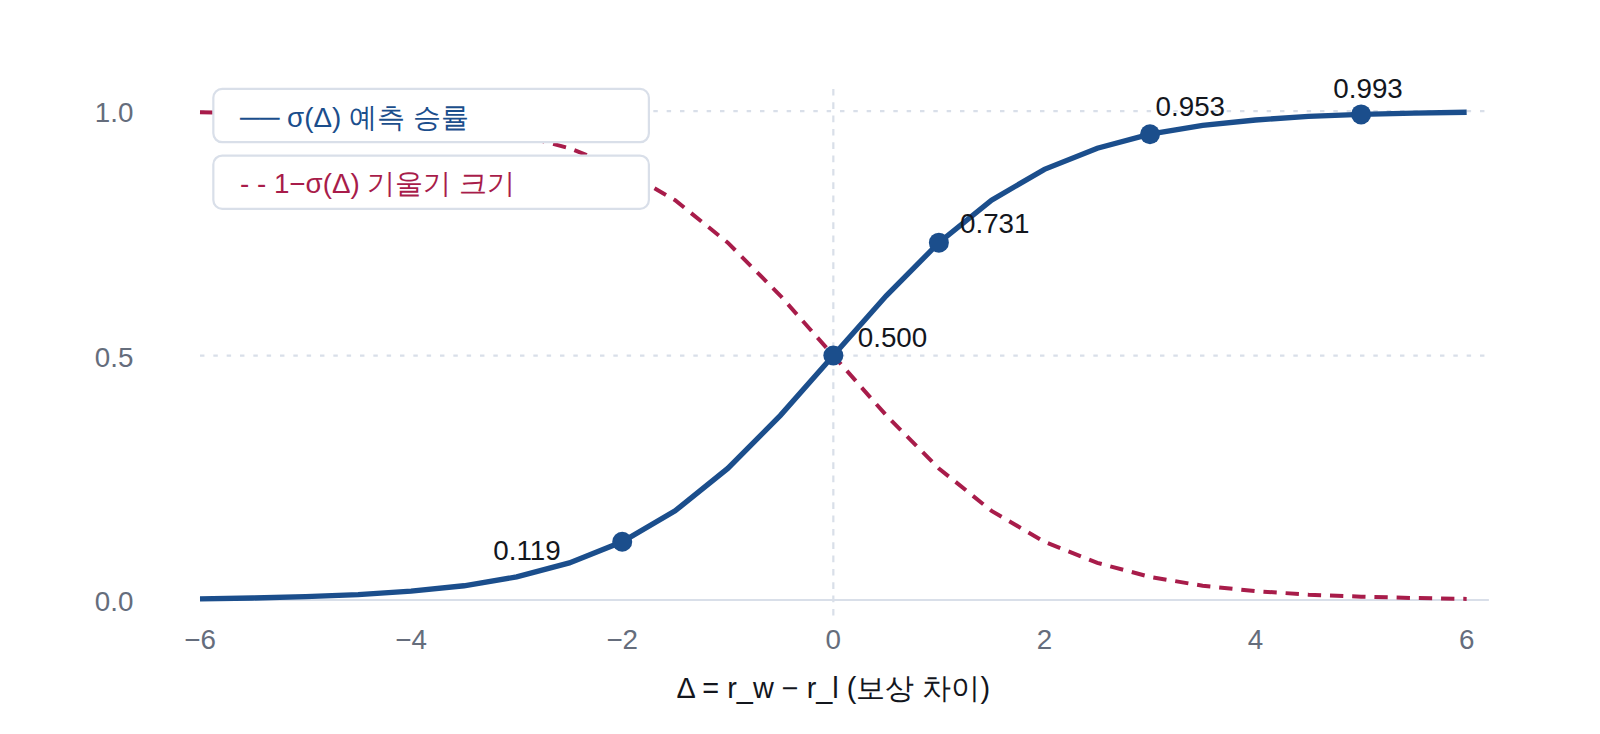
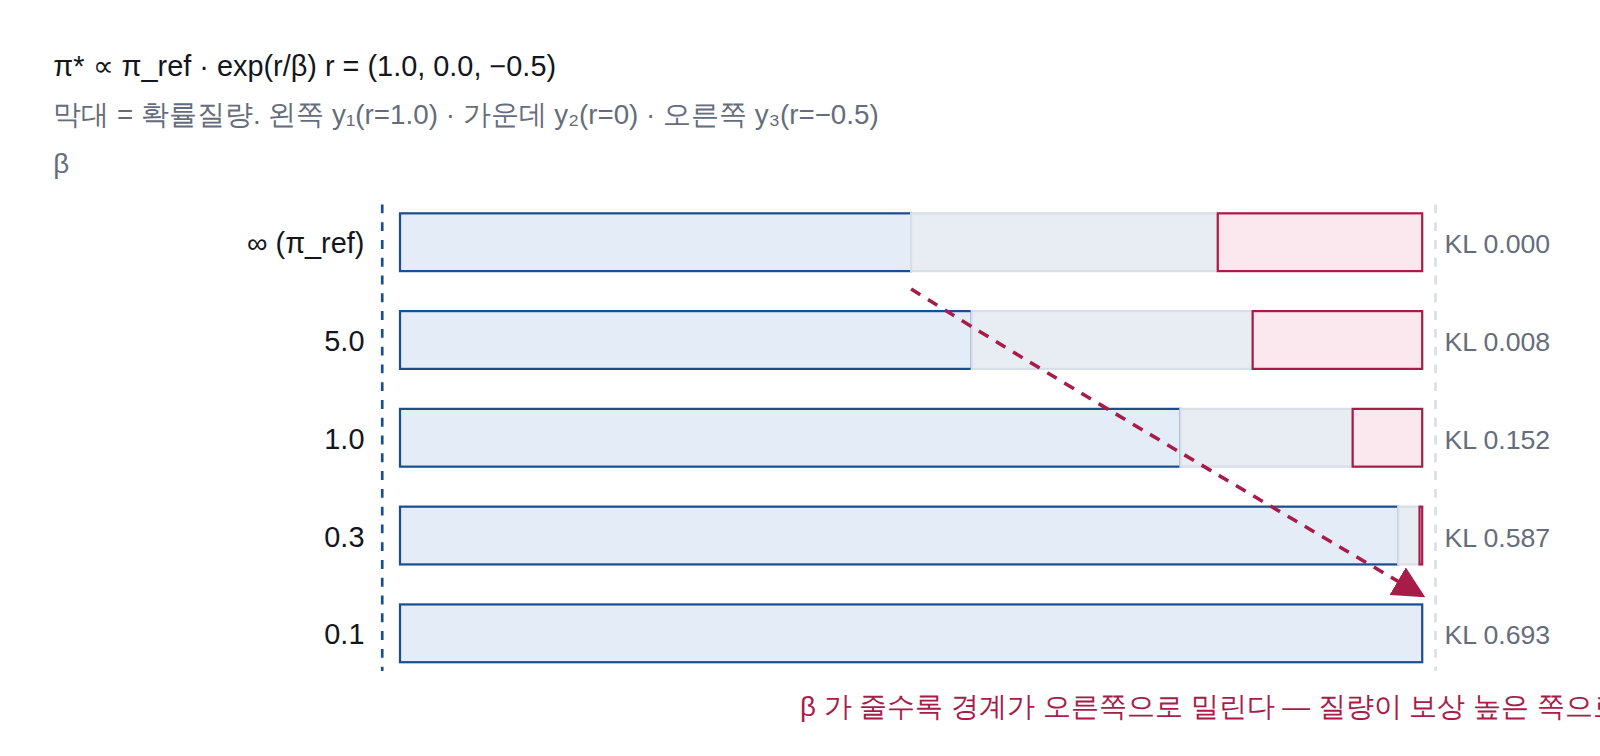
이 장이 남긴 두 개의 실 끝
첫째, 보상모델은 대리인이다. 3단계는 사람이 아니라 2단계가 만든 근사를 최적화하고, 그 근사가 정확한 영역은 πref 근처뿐이다. KL 항이 그 영역을 지키며, 방어가 뚫릴 때 일어나는 일이 보상 해킹이다. 둘째, 식 (28.5) 는 파이프라인을 접을 수 있다고 말한다. 최적 정책이 보상으로 닫힌 꼴이면 거꾸로 보상을 정책으로 적을 수 있고, 그러면 보상모델이라는 중간 산물이 필요 없어진다. 29장의 DPO 가 그 길을 간다.
여기서 인용할 만한 실증은 InstructGPT 논문(Ouyang 외, 2022)이 보고한 사람 평가 결과다 — 그 논문은 13억 파라미터 InstructGPT 의 출력이 1750억 파라미터 GPT-3 의 출력보다 사람 평가자에게 더 선호되었다고 보고했다. 파라미터 수를 백 배 이상 줄이고도 선호도가 높았다는 것이 RLHF 가 주목받은 직접적 계기다. 이 시리즈에서는 그 규모의 실험을 재현하지 않으며, 위 문장은 원논문의 보고값을 인용한 것이다. 우리가 직접 확인한 것은 앞의 코드 장난감 — 선호 레이블만으로 보이지 않던 기준이 복원된다는 사실 — 까지다.
이것만 기억하자
- 브래들리–테리는 보상의 차이만 식별한다. σ(rw−rl) 에 절대 수준이 들어갈 자리가 없으므로, 게이지를 고정하지 않으면 해가 직선 전체다. 그래서 보상모델의 출력값 자체는 해석하지 않는다.
- 1차 조건은 "실제 승수 = 기대 승수" 한 줄이다. 세 응답 13번 비교에서 rC=0 으로 고정하면 rA=1.198002, rB=0.472247 이고, 쌍별 승률은 못 맞히지만 응답별 총 승수는 정확히 맞는다.
- KL 정규화 목적의 최적해는 π* ∝ πref·exp(r/β) 이고 최적값은 β log Z 다. β=1 이면 (0.763371, 0.168497, 0.068132), β=0.1 이면 (0.999973, 0.000027, ≈0) 로 사실상 결정적이 된다. 이 식을 뒤집는 것이 29장 DPO 다.
흔한 오해
- "보상모델 점수가 5.0 이면 3.0 짜리보다 확실히 낫다" — 같은 보상모델·같은 프롬프트 안에서만 그렇다. 모델을 다시 학습시키면 출력 범위가 통째로 옮겨 가고, 프롬프트가 다르면 비교 자체가 의미 없다. 비교 가능한 것은 같은 x 에 대한 두 응답의 차이뿐이다.
- "KL 페널티는 과적합을 막는 정규화다" — 목적이 다르다. 이것은 보상모델의 유효 범위를 지정하는 장치다. 26장 오프라인 RL 의 분포 이탈 대책과 같은 계열이고, 겸해서 모드 붕괴를 막는다. β 를 키운다는 것은 "대리인을 덜 믿겠다"는 뜻이지 "덜 학습하겠다"는 뜻이 아니다.
- "RLHF 의 KL 은 PPO 의 KL 과 같은 것이다" — 기준이 다르다. PPO·TRPO 의 KL 은 πold 를 보며 매 갱신마다 기준이 따라 움직이는 걸음 크기의 자다. RLHF 의 KL 은 고정된 πref 를 보는 총 이동거리의 자다. 실제 구현에서는 둘이 동시에 작동한다.
- "λ=0.95 면 신용할당은 해결된다" — 길이에 달렸다. L=20 에서 첫 토큰은 0.377 을 받지만 L=200 에서는 3.69×10⁻⁵ 다. 응답 앞부분이 학습에서 사실상 배제된다. 긴 응답을 다룰 때 λ 를 1 에 가깝게 두는 구현이 많은 이유가 이것이다.
'강화학습' 카테고리의 다른 글
| [강화학습 30] 무엇을 이겼다고 말할 수 있나 (완결) (0) | 2026.09.15 |
|---|---|
| [강화학습 29] RLHF ② DPO·GRPO, 그리고 보상 해킹 (0) | 2026.09.15 |
| [강화학습 27] 모방학습과 역강화학습 (0) | 2026.09.15 |
| [강화학습 26] 오프라인 RL — 환경 없이 로그만 있을 때 (0) | 2026.09.15 |
| [강화학습 25] MCTS와 AlphaZero — 탐색이 정책을 가르친다 (0) | 2026.09.15 |
댓글