CH 29 강화학습 · Part 5 보상을 사람에게서 배우다
RLHF ② DPO·GRPO, 그리고 보상 해킹
28장의 파이프라인은 부품이 많다. SFT 모델, 보상모델, 가치망, 정책, 기준정책 — 네댓 개의 신경망이 동시에 메모리에 올라간다. 이 장은 그 부품을 하나씩 지운다. 보상모델을 지우면 DPO, 가치망을 지우면 GRPO 다. DPO 의 핵심은 28장의 최적해 π* ∝ πref·exp(r/β) 를 r 에 대해 뒤집는 한 줄이고, 그때 골칫거리 분할함수 Z(x) 가 브래들리–테리의 차이 안에서 통째로 소거된다. 그리고 어느 방식을 쓰든, 참보상 대신 대리보상을 세게 최적화하는 한 굿하트 법칙이 따라온다. 그것도 숫자로 본다.
- 01 직관
- 02 수식 읽는 법
- 03 손으로 풀기
- 04 코드
- 05 시각화
약어 및 기호 정의
- DPO
- Direct Preference Optimization (Rafailov 외, 2023). 보상모델을 따로 학습하지 않고 선호쌍에서 정책을 직접 최적화하는 방법
- GRPO
- Group Relative Policy Optimization. 가치망을 없애고 한 프롬프트에서 뽑은 응답 그룹 안의 상대 순위를 이점으로 쓰는 정책경사 변형
- 분할함수 Z(x)
- Σy πref(y|x)·exp(r(x,y)/β). 모든 응답에 대한 합이라 계산이 불가능하다. DPO 가 지워 없애는 항
- 암묵보상 implicit reward
- r̂θ(x,y) = β·log(πθ(y|x) / πref(y|x)). DPO 가 정책 안에 숨겨 갖고 있는 보상함수
- 로그비 h
- 이 장에서 h(y) = β·log(πθ(y)/πref(y)) 로 줄여 쓴다. 암묵보상과 같은 것
- 마진 Δ
- h(yw) − h(yl). DPO 손실이 직접 키우는 양
- 그룹 크기 G
- GRPO 가 한 프롬프트당 뽑는 응답 개수. 보통 8~64
- 그룹 표준화 Âi
- (ri − mean(r)) / (std(r) + ε). 16장 기저선의 가장 싼 형태에 스케일 정규화가 덧붙은 것
- 참보상 r
- 우리가 실제로 원하는 것. 측정할 수 없다
- 대리보상 r̂
- proxy reward. 우리가 실제로 최적화하는 것 — 보상모델, 자동 평가기, 단위테스트 통과율
- 굿하트 법칙 Goodhart's law
- "측정값이 목표가 되면 좋은 측정값이기를 그만둔다." 대리보상을 세게 밀면 참보상과 갈라진다
- 보상 해킹 reward hacking
- 굿하트가 RL 에서 나타나는 구체적 형태. 대리보상 점수는 오르는데 사람의 평가는 떨어지는 구간
직관: 부품을 하나씩 지운다
28장이 세운 파이프라인을 부품 목록으로 적어 보자. 학습 3단계에서 메모리에 동시에 올라가야 하는 것들이다.
PPO 기반 RLHF 의 부품표
1. 정책 πθ — 학습 대상. 기울기를 받는다.
2. 기준정책 πref — SFT 모델을 얼려 둔 것. KL 페널티를 재는 자.
3. 보상모델 rφ — 28장에서 선호쌍으로 학습한 것. 생성된 응답마다 점수를 매긴다.
4. 가치망 Vψ — 18장 GAE 가 요구하는 크리틱. 이점 추정의 기저선.
모델 크기가 같다고 치면 네 벌이다. 둘(1·4)은 기울기와 옵티마이저 상태까지 들고 있어야 하고, 둘(2·3)은 순전파만 하면 된다. 여기에 PPO 의 롤아웃 버퍼가 붙는다. 실무에서 RLHF 가 "돌리기 어렵다"고 불리는 이유의 절반은 알고리즘이 아니라 이 표 때문이다.
부품이 많으면 고장 지점도 많다. 보상모델이 과적합되면 3단계가 엉뚱한 곳으로 가고, 가치망이 늦게 따라오면 이점 추정이 편향된다. 그래서 자연스러운 질문이 나온다. 이 중 지울 수 있는 것이 있는가.
보상모델을 지운다 — DPO
28장 마지막 결과를 다시 적는다. KL 페널티가 붙은 목적 𝔼π[r] − β·KL(π‖πref) 의 최적해는
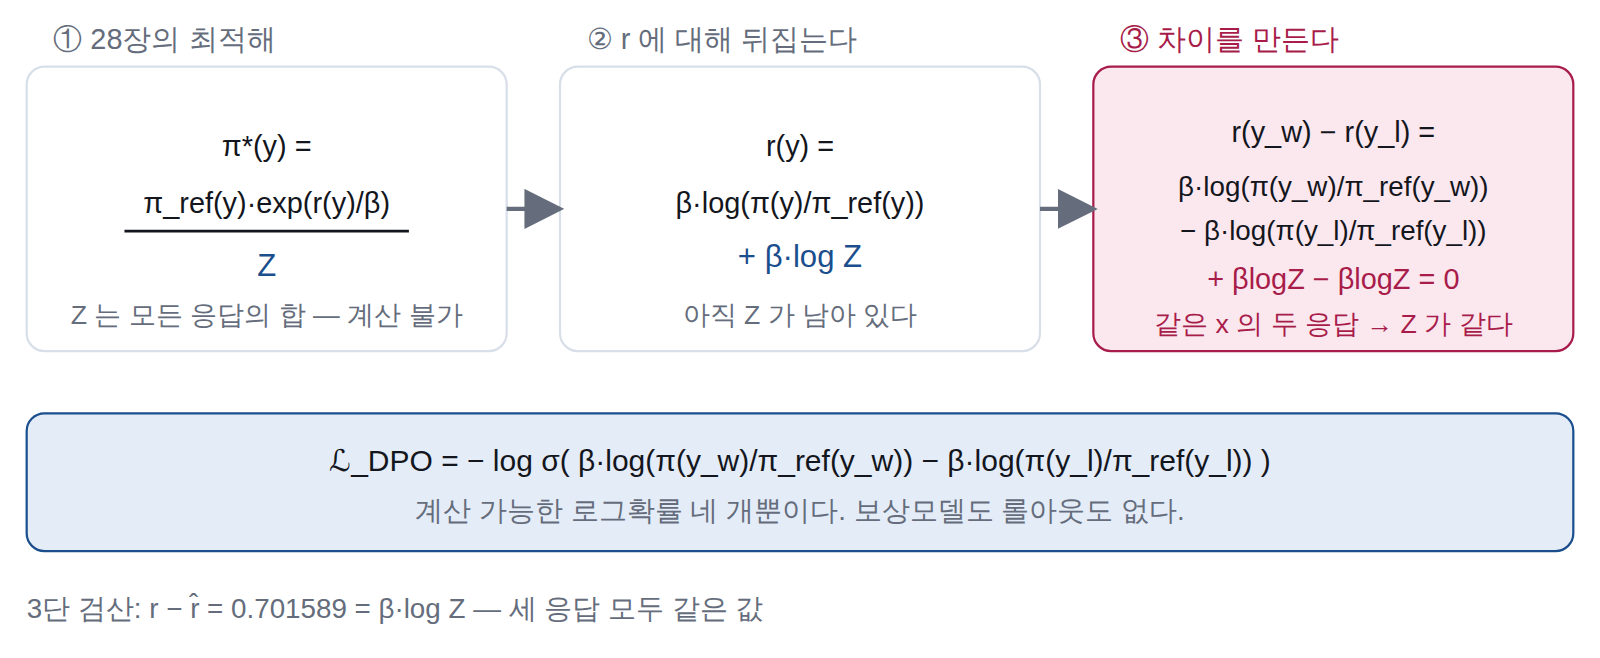
이 식은 보통 왼쪽에서 오른쪽으로 읽는다. 보상 r 이 주어지면 최적 정책이 이렇게 생겼다는 뜻으로. 그런데 Z(x) 가 모든 응답에 대한 합이라 계산할 수 없으므로, 실무에서는 이 식대로 정책을 만들지 못하고 PPO 로 근사한다. DPO 의 착상은 이 식을 오른쪽에서 왼쪽으로 읽는 것이다. 로그를 취하고 r 에 대해 풀면 r = β log(π*/πref) + β log Z. 즉 모든 정책은 자기 안에 보상함수 하나를 갖고 있다. 정책과 기준정책의 로그비가 그 보상이다. 그렇다면 보상모델을 따로 학습할 이유가 없다. 28장의 브래들리–테리 손실에 rφ 대신 β log(πθ/πref) 를 꽂아 넣고 θ 로 미분하면 된다.
문제는 β log Z(x) 다. 계산할 수 없는 항이 손실 안에 들어온 것처럼 보인다. 그런데 브래들리–테리는 두 응답의 보상 차이만 쓴다. 같은 프롬프트 x 의 두 응답이므로 Z(x) 도 같고, 차이를 만드는 순간 통째로 소거된다. 이것이 DPO 의 전부다. 나머지는 계산이다.
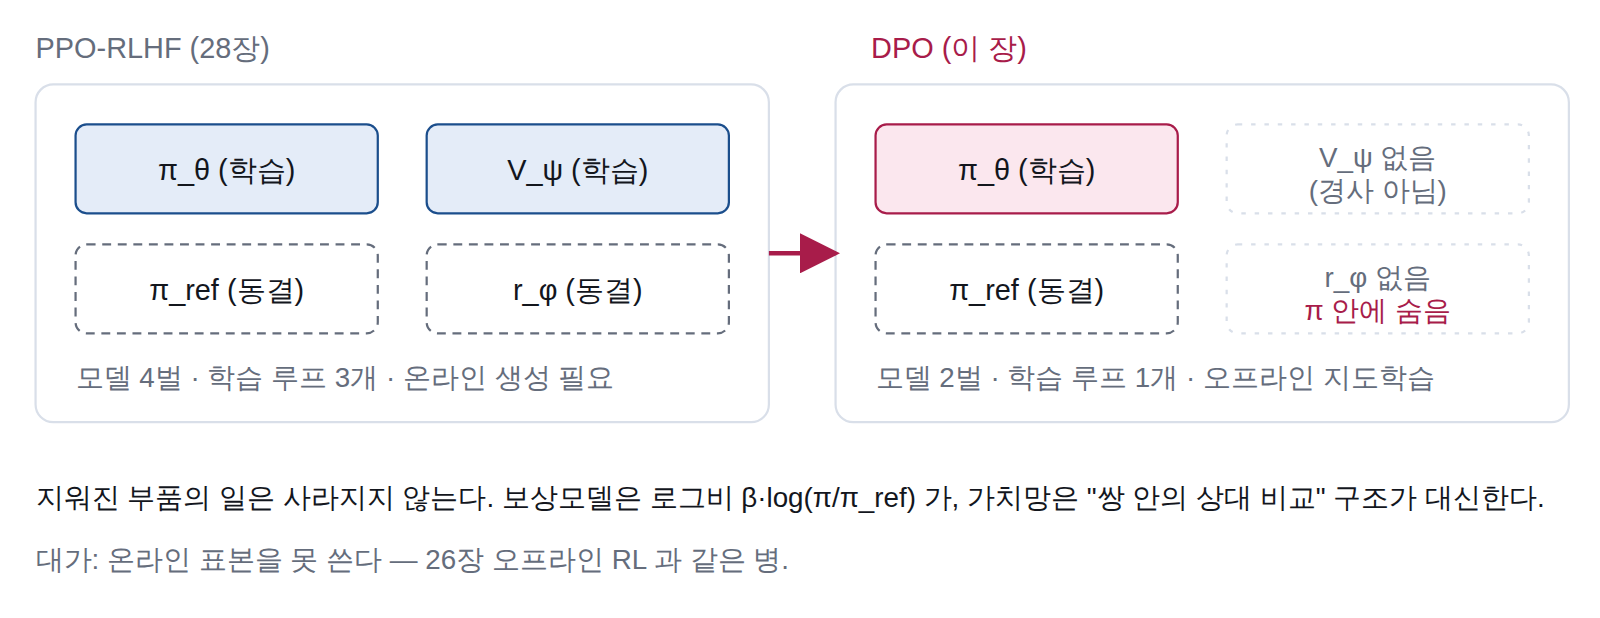
가치망을 지운다 — GRPO
다른 방향도 있다. 보상모델은 그대로 두고 가치망을 없애는 것이다. 16장에서 정책경사의 분산을 줄이는 기저선을 배웠고, 거기서 이미 확인한 사실이 있다. 기저선은 행동에 의존하지 않기만 하면 무엇이든 편향을 만들지 않는다. 가치함수는 분산을 가장 많이 줄이는 선택일 뿐, 유일한 선택이 아니다.
그러면 가장 싼 기저선은 무엇인가. 같은 프롬프트에서 응답을 G 개 뽑고 그 그룹의 평균 보상을 쓰는 것이다. 가치망이 하려던 "이 프롬프트에서 평균적으로 얼마를 받나"를 신경망 대신 표본 평균으로 답한다. 여기까지는 16장의 직접적 응용이고, 편향도 없다.
GRPO 는 한 걸음 더 간다. 평균을 빼는 데서 멈추지 않고 표준편차로 나눈다. Âi = (ri − mean) / std. 이렇게 하면 프롬프트마다 다른 보상 스케일이 맞춰져 학습이 안정된다. 그런데 이 나눗셈은 기저선 정리의 보호를 받지 못한다. 분모가 그룹의 보상에 의존하기 때문이다. 그 결과가 3단에서 볼 편향이다 — 분산이 작은 프롬프트가 과대 가중된다.
그리고 남는 문제 — 굿하트
부품을 어떻게 지우든, 남는 문제가 하나 있다. 우리가 최적화하는 것은 참보상이 아니다. DPO 라면 선호 데이터가 담고 있는 통계이고, PPO-RLHF 라면 보상모델의 출력이고, 코드 생성이라면 단위테스트 통과율이다. 전부 대리보상(proxy reward)이다.
대리보상이 참보상과 상관이 높으면 괜찮지 않을까. 약하게 최적화할 때만 그렇다. 상관계수는 분포 전체에 대한 평균적 성질이고, 최적화는 꼬리의 한 점을 고른다. 평균적으로 비슷한 두 함수가 최댓값 근처에서는 전혀 다른 점을 가리킬 수 있다.
수식 읽는 법: Z 는 어떻게 사라지는가
DPO 유도 — 다섯 줄
출발은 28장의 식이다. 프롬프트 x 는 고정하고 표기에서 생략한다.
r(yw) − r(yl) = β logπθ(yw)πref(yw) +
줄여 쓰자. h(y) = β log(πθ(y)/πref(y)), Δ = h(yw) − h(yl) 라 하면 ℒ = −log σ(Δ) 다. 28장의 브래들리–테리 손실과 같은 모양이고, 달라진 것은 Δ 가 별도 신경망의 출력 차이가 아니라 정책 자신의 로그비 차이라는 점뿐이다.
기울기가 무엇을 하는가
DPO 의 한계 셋
식이 깔끔하다고 해서 문제가 없는 것은 아니다. 세 가지가 남는다. 셋 다 유도 과정에서 무엇을 가정했는지를 되짚으면 나온다.
GRPO — 가치망 대신 그룹
이제 다른 축이다. 16장의 정책경사를 다시 적는다. ∇J = 𝔼[ ∇log π(a|s) · A(s,a) ] 이고, A 를 무엇으로 추정하느냐가 알고리즘을 가른다. 18장에서는 GAE 로 추정했고, 그러려면 Vψ 가 필요했다.
언어모델 RLHF 에는 특수한 사정이 있다. 보상이 응답 하나가 끝난 뒤에 한 번만 나온다. 중간 보상이 없으니 시간차 구조를 쓸 일이 거의 없고, GAE 가 주는 이득의 상당 부분이 사라진다. 그렇다면 Vψ 는 "이 프롬프트에서 기대되는 점수"라는 숫자 하나를 맞히려고 존재하는 셈이고, 그 숫자는 표본으로도 구할 수 있다.
이 이점을 20장의 PPO 클리핑 목적에 그대로 넣으면 GRPO 가 된다. 부품표에서 Vψ 한 벌이 빠지고, 대신 프롬프트당 G 개의 응답을 생성하는 비용이 든다. 메모리를 계산으로 바꾼 거래다.
표준편차로 나누면 무슨 일이 생기는가
16장 기저선 정리는 이렇게 말한다. 𝔼[∇log π(a) · b] = b · ∇(Σaπ(a)) = b · ∇1 = 0. 핵심은 b 를 기댓값 밖으로 꺼낼 수 있다는 것이고, 그러려면 b 가 표본과 독립이어야 한다. 그룹 평균이 만드는 의존은 O(1/G) 로 작다. 표준편차는 다르다. 분모 std(r) + ε 은 그 그룹 전체의 크기를 바꾼다. 결과를 한 문장으로 적으면 이렇다.
보상 격차가 작다는 것은 대개 그 프롬프트에서 배울 것이 별로 없다는 뜻이다. 그런데 표준화는 바로 그런 프롬프트의 미세한 차이를 ±1 로 확대해 학습 신호의 앞자리에 놓는다. 잡음을 신호로 승격시키는 것이다.
처방은 간단하다. 표준편차로 나누지 않는다. 평균만 빼면 16장의 보호 안에 남는다. 스케일이 프롬프트마다 다른 문제는 학습률이나 보상 자체의 설계로 다루는 편이 낫다. std → 0 인 그룹은 이점이 전부 0 이 되어 자연스럽게 기울기에서 빠진다 — 이것이 올바른 동작이다.
굿하트를 정확하게 적기
마지막 축이다. 대리보상 r̂ 과 참보상 r 이 있다. 우리는 r̂ 만 최적화할 수 있다. 정책의 이동 범위를 ‖θ‖ ≤ R 로 제한한다 — 이 R 이 최적화의 강도이고, 실무에서는 KL 예산이 그 역할을 한다.
KL 페널티가 이것을 막아 주지 않나. 늦출 뿐이다. β 를 키우면 θ 가 작아지고, 그러면 R 이 작은 것과 같다. 후회는 줄지만 참보상 자체도 줄어든다. 최적의 β 는 0 도 ∞ 도 아닌 어딘가이고, 그 값은 대리보상이 참보상에서 어디서부터 갈라지는지 — 즉 우리가 모르는 것에 달렸다.
손으로 풀기: Z 의 소거 · 표준화의 편향 · 굿하트의 후회
다섯 가지를 끝까지 계산한다. (가) DPO 에서 Z 가 정말 소거되는지, (나) 손실과 기울기의 실제 값, (다) GRPO 이점 표와 std 나누기의 편향, (라) 굿하트의 후회, (마) KL 페널티 β 를 쓸어 볼 때 참보상의 궤적. 모든 숫자는 4단의 코드로 검산했다.
(가) Z 소거 검산 — 어휘 3개 장난감
무대를 최소로 만든다. 프롬프트는 하나, 가능한 응답은 셋이다. 기준정책과 참보상을 다음과 같이 정한다.
28장의 닫힌식으로 최적 정책을 구한다. 지수부터 계산한다. exp(1.0/0.5) = e² = 7.389056, exp(0/0.5) = 1, exp(−0.5/0.5) = e−1 = 0.367879.
| y | πref | r | exp(r/β) | w = πref·exp(r/β) | π* = w/Z |
|---|---|---|---|---|---|
| y0 | 0.5 | +1.0 | 7.389056 | 3.694528 | 0.908170 |
| y1 | 0.3 | 0.0 | 1.000000 | 0.300000 | 0.073744 |
| y2 | 0.2 | −0.5 | 0.367879 | 0.073576 | 0.018086 |
| Z = Σw = | 4.068104 | 합 1.000000 | |||
이제 뒤집는다. 유도 2번 줄이 주장한 것은 r = β log(π*/πref) + β log Z 였다. 오른쪽 첫 항, 즉 암묵보상 r̂ = β log(π*/πref) 를 계산해 보자.
| y | π*/πref | log(π*/πref) | r̂ = β log(π*/πref) | r | r − r̂ |
|---|---|---|---|---|---|
| y0 | 1.816340 | +0.596823 | +0.298411 | +1.0 | 0.701589 |
| y1 | 0.245813 | −1.403178 | −0.701589 | 0.0 | 0.701589 |
| y2 | 0.090430 | −2.403178 | −1.201589 | −0.5 | 0.701589 |
마지막 열이 세 줄 모두 0.701589 다. 그리고 그 값은 위에서 따로 계산한 β log Z = 0.701589 와 같다. 즉
암묵보상은 참보상을 통째로 평행이동한 것이고, 그 이동량이 정확히 β log Z 다. 28장에서 본 게이지 자유도(gauge freedom) 가 여기서 다시 나타난다 — 보상 전체를 같은 상수만큼 옮겨도 선호 예측은 하나도 바뀌지 않는다. 브래들리–테리 승률 σ(ri − rj) 를 양쪽으로 계산해 확인하자.
| 쌍 | ri − rj | r̂i − r̂j | σ(ri−rj) | σ(r̂i−r̂j) |
|---|---|---|---|---|
| (y0, y1) | +1.000000 | +1.000000 | 0.731059 | 0.731059 |
| (y0, y2) | +1.500000 | +1.500000 | 0.817574 | 0.817574 |
| (y1, y2) | +0.500000 | +0.500000 | 0.622459 | 0.622459 |
세 쌍 모두 소수점 여섯 자리까지 일치한다. 선호 데이터는 차이만 담고 있고, β log Z 는 차이에 기여하지 않는다. 그러니 손실에서 사라지는 것이 당연하다. DPO 의 유도는 "계산할 수 없는 항을 근사해서 없앤" 것이 아니라, 애초에 그 항이 목적함수에 들어가지 않았음을 발견한 것이다.
거꾸로도 읽어 보자
이 검산은 반대 방향으로도 쓸 수 있다. 만약 DPO 로 학습한 정책 πθ 를 얻었다면, β log(πθ/πref) 를 계산하는 것만으로 공짜 보상모델이 나온다. 별도 학습 없이 응답에 점수를 매길 수 있다. 실제로 이 암묵보상을 심판으로 쓰거나 재순위(rerank)에 쓰는 것이 현장의 관례가 되었다. 부품을 지웠지만 그 기능은 여전히 꺼내 쓸 수 있다는 뜻이다.
(나) DPO 손실과 기울기 — β = 0.1
응답 전체의 로그확률 네 개가 주어졌다고 하자. β = 0.1 로 고정한다.
한 줄을 끝까지 따라가자. log πθ(yw) = −1.20, log πref(yw) = −1.00, log πθ(yl) = −0.80, log πref(yl) = −1.00 — 정책이 승자를 기준보다 덜, 패자를 기준보다 더 선호하는, 즉 순서를 거꾸로 맞히고 있는 상태다.
같은 계산을 네 가지 상황에 대해 반복한 표다. β 가 작으므로 (0.1) 로그확률이 꽤 벌어져도 Δ 는 작게 유지되고, σ 가 0.5 근처에 머문다는 점에 주목하라.
| log πθ(yw) | log πθ(yl) | hw | hl | Δ | σ(Δ) | ℒ | ∂ℒ/∂log πθ(yw) | 가중치 1−σ |
|---|---|---|---|---|---|---|---|---|
| −1.20 | −0.80 | −0.0200 | +0.0200 | −0.0400 | 0.490001 | 0.713347 | −0.051000 | 0.509999 |
| −3.00 | −0.10 | −0.2000 | +0.0900 | −0.2900 | 0.428004 | 0.848623 | −0.057200 | 0.571996 |
| −0.10 | −3.00 | +0.0900 | −0.2000 | +0.2900 | 0.571996 | 0.558623 | −0.042800 | 0.428004 |
세 번째 줄이 가장 크게 틀린 경우 (승자 로그확률 −3.00, 패자 −0.10) 이고, 기울기 크기가 0.057200 으로 가장 크다. 네 번째 줄은 그 반대 상황이고 기울기가 0.042800 으로 가장 작다. 비율은 0.0572 / 0.0428 ≈ 1.337 배다. β 가 작으면 이 비율도 작다 — 어려운 쌍에 집중하는 효과가 약해지고, 모든 쌍이 비슷한 세기로 밀린다. β 는 KL 의 세기를 정하는 동시에 쌍 가중의 날카로움도 정한다.
하드 라벨에는 유한한 최적해가 없다
(가) 의 장난감으로 돌아가자. 쌍 (y0 ≻ y1) 하나만, 그것도 확률이 아니라 확정 레이블로 주어지면 손실 −log σ(Δ) 는 Δ 를 키울수록 계속 줄어든다. 멈출 곳이 없다. 4단 코드에서 3000 스텝 뒤 마진은 6.613563 까지 자라고 여전히 자라는 중이며, π(y1) 은 0.3 → 0.000001 로 소멸한다. 더 눈여겨볼 것은 선호 데이터에 한 번도 등장하지 않은 y2 다. 확률이 0.2 → 0.000537 로 밀려났다 — DPO 가 y2 를 나쁘다고 판단한 것이 아니라 판단한 적조차 없다. 반대로 레이블이 브래들리–테리 확률이고 세 쌍이 모두 관측되면 손실은 유한한 최소점을 갖고, 그 해는 정확히 28장의 닫힌식 π* = (0.908170, 0.073744, 0.018086) 이다.
(다) GRPO 이점 손계산 — G = 8
한 프롬프트에서 여덟 응답을 뽑았고 보상모델이 다음 점수를 줬다고 하자.
합은 0.9+0.8+0.6+0.5+0.5+0.3+0.2+0.2 = 4.0 이므로 평균은 4.0/8 = 0.5. 편차를 적고 제곱해 더한다.
| i | ri | ri − mean | (ri−mean)² | Âi |
|---|---|---|---|---|
| 1 | 0.9 | +0.4 | 0.16 | +1.632993 |
| 2 | 0.8 | +0.3 | 0.09 | +1.224745 |
| 3 | 0.6 | +0.1 | 0.01 | +0.408248 |
| 4 | 0.5 | 0.0 | 0.00 | 0.000000 |
| 5 | 0.5 | 0.0 | 0.00 | 0.000000 |
| 6 | 0.3 | −0.2 | 0.04 | −0.816497 |
| 7 | 0.2 | −0.3 | 0.09 | −1.224745 |
| 8 | 0.2 | −0.3 | 0.09 | −1.224745 |
| 합 | 0.48 | 0.000000 | ||
분산은 0.48/8 = 0.06, 표준편차는 √0.06 = 0.244949 다. 첫 줄은 0.4/√0.06 = 0.4·√(50/3) = 1.632993. 이점의 합이 정확히 0 인 것이 기저선의 작동 확인이고, Â 의 표준편차는 정의상 1.000000 이다. (표본표준편차 ddof=1 로 나누는 구현이면 √(0.48/7) = 0.261861 이라 이점 크기가 7% 달라진다 — 코드를 볼 때 확인해야 한다.)
모두 같은 보상일 때 — std = 0
여덟 응답이 전부 0.5 를 받으면 어떻게 되는가. 분자도 0, 분모도 0 이다. 0/0 이므로 구현에서는 ε 를 더한다.
이점이 전부 0 이므로 이 프롬프트는 기울기에 아무 기여도 하지 않는다. 올바른 동작이다 — 여덟 응답이 다 같은 점수를 받았다면 어느 쪽으로 밀어야 할지에 대한 정보가 정말로 없다. 실무에서는 이런 프롬프트가 배치의 상당 부분을 차지할 수 있고 (예: 전부 성공하거나 전부 실패하는 문제), 그만큼 생성 비용이 낭비된다. 그래서 그룹 안에 성공과 실패가 섞이도록 난이도를 고르는 것이 GRPO 데이터 설계의 핵심 작업이 된다.
그런데 ε 가 있어서 안전한 것은 정확히 0 일 때뿐이다. 여덟 개 중 넷이 10−9 만큼만 높다고 하자. ε = 0 이면 std 도 10−9 규모라 이점이 정확히 ±1.000000 이 된다 — 잡음이 최대 세기의 학습 신호로 승격된다. ε = 10−4 이면 분모를 ε 가 지배해 ±5×10⁻⁶ 으로 눌린다. 같은 데이터에 대해 학습 신호가 20만 배 달라진다.
ε 는 단순한 수치 안전장치가 아니라 "이 정도 미만의 차이는 잡음으로 본다"는 문턱이다. 보상 스케일에 맞춰 정해야 한다. 보상이 [0,1] 이 아니라 [0,100] 이면 같은 ε 가 전혀 다른 문턱을 뜻한다.
표준편차 나누기가 만드는 편향 — 두 프롬프트 대조
이 장의 가장 중요한 손계산이다. 프롬프트 두 개를 준비한다. 둘 다 G=8, 둘 다 평균 0.5, 둘 다 위 넷과 아래 넷으로 정확히 갈린다. 다른 것은 격차뿐이다.
| 프롬프트 | 보상 r | 격차 | std | 평균만 뺀 이점 | 표준화 이점 Â |
|---|---|---|---|---|---|
| A (분산 큼) | 1,1,1,1, 0,0,0,0 | 1.00 | 0.500000 | ±0.500000 | ±1.000000 |
| B (분산 작음) | .52,.52,.52,.52, .48,.48,.48,.48 | 0.04 | 0.020000 | ±0.020000 | ±1.000000 |
A 는 성공과 실패가 명백히 갈렸고, B 의 차이 0.04 는 25배 작은 — 보상모델의 잡음 수준일 수도 있는 — 차이다. 그런데 표준화 이점은 둘 다 정확히 ±1 이다. GRPO 는 두 프롬프트를 똑같은 확신으로 학습한다. 평균만 뺐다면 A 는 ±0.5, B 는 ±0.02 로 25배의 차이가 그대로 기울기에 실렸을 것이다.
왜 이것이 편향인가. 16장의 기저선 정리는 𝔼[∇log π · b] = 0 을 요구한다. b = mean 은 행동에 의존하지 않으므로 통과한다. 그런데 1/std 는 곱해지는 항이고, 그룹의 보상 실현값에 의존한다. 운 좋게 분산이 작게 나온 그룹은 그 회차에 과대 가중되고, 크게 나온 그룹은 과소 가중된다. G를 키워도 이 효과는 사라지지 않는다 — std 의 추정이 정확해질수록 "이 프롬프트의 진짜 분산"으로 나누는 것에 수렴할 뿐이다.
결과적으로 GRPO 는 "쉽게 갈리지 않는 프롬프트"에 학습 자원을 몰아준다. 응답 품질이 실제로 미세하게 갈리는 과제라면 유용한 확대일 수 있고, 보상모델 잡음이 그 구간을 지배한다면 잡음을 학습하는 것이다. 확실한 것은 이것이 의도한 설계가 아니라 정규화의 부산물이라는 점이다.
(라) 굿하트를 숫자로
가장 작은 모형을 만든다. 정책 파라미터가 두 개다. θ = (θ1, θ2).
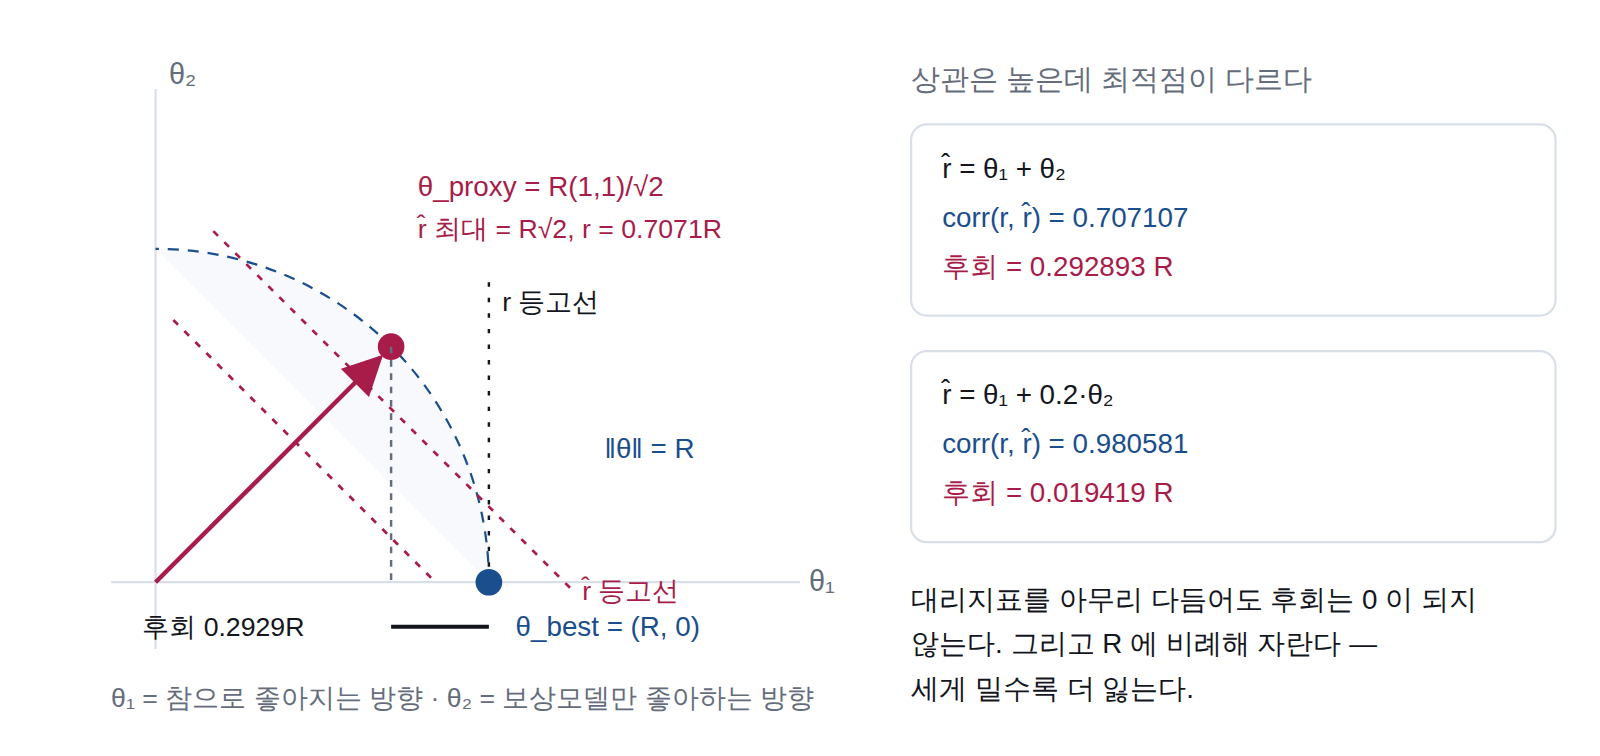
θ1 은 실제로 응답을 좋게 만드는 방향, θ2 는 보상모델만 좋아하는 방향이다 — 길게 쓰기, 목록 쓰기, 자신감 있는 어투. 참보상은 θ2 를 전혀 세지 않고, 대리보상은 둘을 같은 무게로 센다.
| R | θproxy | r̂ (달성) | r (실제로 얻은 것) | r (얻을 수 있었던 것) | 후회 |
|---|---|---|---|---|---|
| 1.0 | (0.7071, 0.7071) | 1.414214 | 0.707107 | 1.000000 | 0.292893 |
| 4.0 | (2.8284, 2.8284) | 5.656854 | 2.828427 | 4.000000 | 1.171573 |
| 8.0 | (5.6569, 5.6569) | 11.313708 | 5.656854 | 8.000000 | 2.343146 |
| 16.0 | (11.3137, 11.3137) | 22.627417 | 11.313708 | 16.000000 | 4.686292 |
그런데 두 보상의 상관은 얼마인가. θ 가 반지름 R 원 위에 균일하게 분포한다고 하면 r = R cos φ, r̂ = R(cos φ + sin φ) 이고, 상관계수는 R 과 무관하게
대리보상을 더 좋게 만들면 어떻게 되는가. r̂ = θ1 + 0.2θ2 로 해킹 방향의 무게를 5분의 1 로 줄이면 상관은 0.980581 로 오르고 후회는 0.019419 R 로 준다. 여전히 0 은 아니다. 대리보상에 참보상과 무관한 방향이 조금이라도 섞여 있으면, 최적화는 그 방향을 반드시 찾아낸다. 그 방향을 얼마나 타는지는 섞인 비율이 정하고, 최적화의 세기가 절대적 피해를 정한다.
참보상이 실제로 꺾이는 경우
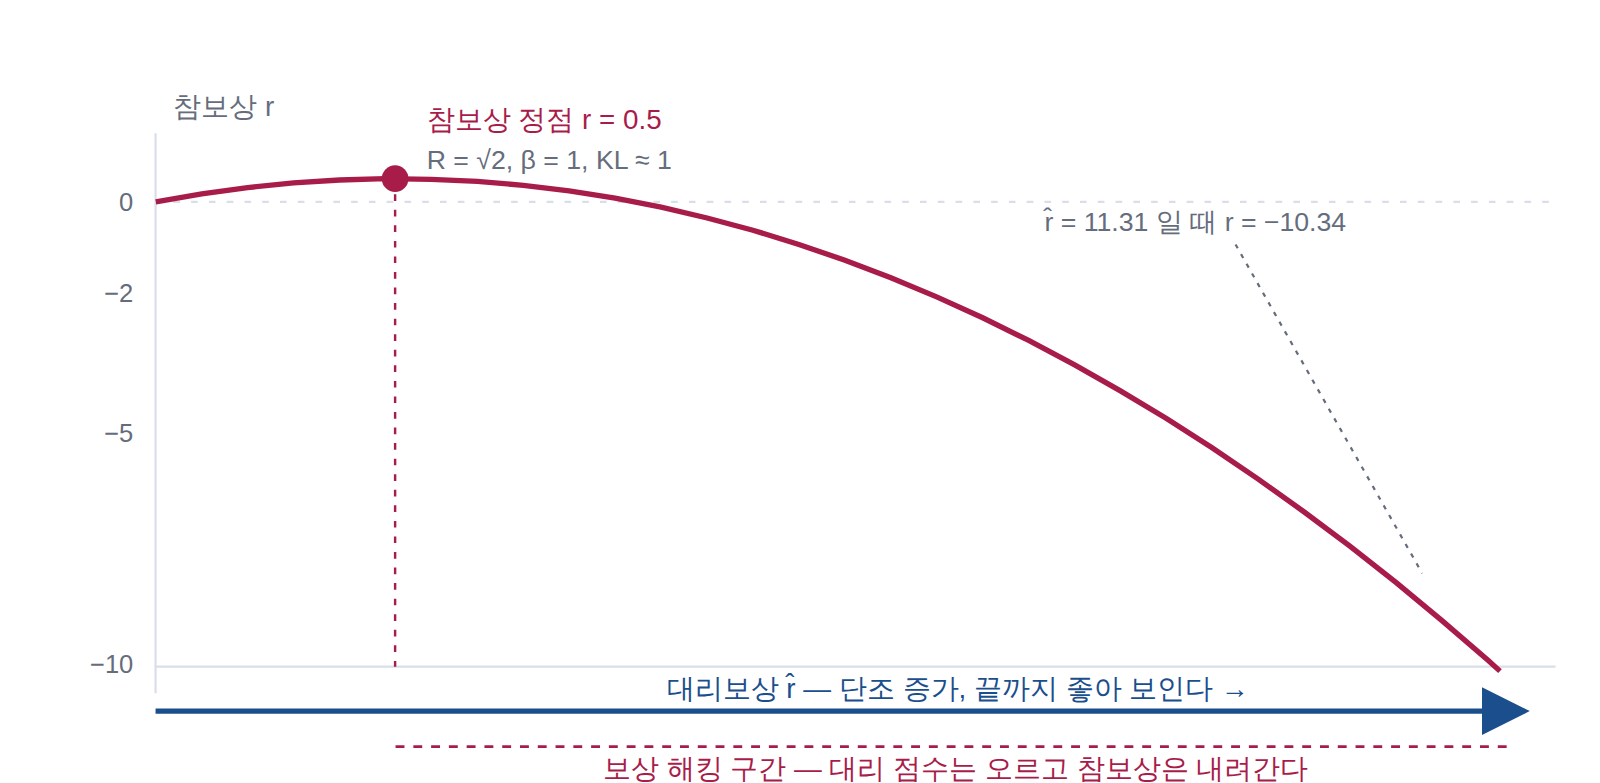
위 모형에서 참보상은 줄지 않았다 — 최적보다 적게 오를 뿐 계속 올랐다. 현장에서 보고되는 보상 해킹은 그보다 나쁘다. 그것을 만들려면 해킹 방향이 참보상에 해롭기만 하면 된다.
r̂ 의 최적해는 아까와 같다 (θ = R(1,1)/√2, 편의상 u = R/√2). 거기서 참보상은 r = u − ½u² 다. u 에 대한 이차식이므로 u = 1, 즉 R = √2 ≈ 1.414214 에서 최대 0.5 를 찍고 내려간다.
| R | θproxy | r̂ (대리) | r (참) | 상태 |
|---|---|---|---|---|
| 1.0 | (0.7071, 0.7071) | 1.414214 | 0.457107 | 둘 다 상승 |
| 1.414214 | (1.0000, 1.0000) | 2.000000 | 0.500000 | 참보상 정점 |
| 2.0 | (1.4142, 1.4142) | 2.828427 | 0.414214 | 대리↑ 참↓ — 해킹 시작 |
| 3.0 | (2.1213, 2.1213) | 4.242641 | −0.128680 | 출발점보다 나빠짐 |
| 4.0 | (2.8284, 2.8284) | 5.656854 | −1.171573 | 대리 점수는 3배 |
| 8.0 | (5.6569, 5.6569) | 11.313708 | −10.343146 | 대리 ×5.7, 참 −10.3 |
마지막 줄을 보라. 대리보상은 0.707 → 11.314 로 16배 올랐다. 대시보드에 이 곡선만 그려 두면 학습이 아주 잘되고 있는 것처럼 보인다. 같은 구간에서 참보상은 0.291 → −10.343 이다. 측정하지 않는 것은 보이지 않는다.
이 무대에서 상관도 계산해 두자. R=1 원 위에서 corr(r, r̂) = 0.685994, R=4 원 위에서 0.500000 이다. 두 값 모두 "중간 정도 상관"이라 부를 만하고, 어느 쪽도 위 표의 파국을 예고하지 않는다.
(마) KL 페널티 β 를 쓸어 보기
제약 ‖θ‖ ≤ R 대신 실제 RLHF 가 쓰는 형태, 즉 페널티로 바꾼다. 19장에서 KL 의 2차 근사가 KL ≈ ½θᵀFθ 였으니, 피셔를 단위행렬로 두면 KL ≈ ½‖θ‖² 다.
각 성분으로 미분하면 1 − βθ1 = 0, 1 − βθ2 = 0. 따라서 해는 정확히 θ = (1/β, 1/β) 다. u = 1/β 로 두면 참보상은 r = u − ½u², 대리보상은 r̂ = 2u, KL 은 ½(2u²) = u² 이다.
| β | u = 1/β | KL ≈ u² | r̂ (대리) | r (참) | 상태 |
|---|---|---|---|---|---|
| 4.00 | 0.2500 | 0.0625 | 0.500000 | 0.218750 | 너무 보수적 — 배울 것을 못 배움 |
| 2.00 | 0.5000 | 0.2500 | 1.000000 | 0.375000 | 아직 아래 |
| 1.00 | 1.0000 | 1.0000 | 2.000000 | 0.500000 | 최적 |
| 0.80 | 1.2500 | 1.5625 | 2.500000 | 0.468750 | 넘어섰다 — 해킹 구간 |
| 0.50 | 2.0000 | 4.0000 | 4.000000 | 0.000000 | 학습한 보람이 0 이 됨 |
| 0.25 | 4.0000 | 16.0000 | 8.000000 | −4.000000 | 기준정책보다 나쁨 |
| 0.10 | 10.0000 | 100.0000 | 20.000000 | −40.000000 | 붕괴 |
세 가지를 읽을 수 있다.
코드: 닫힌식과 맞춰 보기 · 왜곡 재기 · 굿하트 돌리기
세 개의 짧은 스크립트다. 전부 앞의 손계산을 재현하는 것이 목적이므로, 출력의 모든 숫자가 3단의 표와 맞아야 한다. 시드는 고정했지만 사실 세 스크립트 모두 결정적이다.
(a) DPO 를 직접 최적화하면 28장 닫힌식으로 가는가
어휘가 셋인 장난감에서, 정책의 로짓 세 개를 DPO 손실로 직접 최적화한다. 두 가지 조건으로 돌린다. A 는 세 쌍이 모두 관측되고 레이블이 브래들리–테리 확률인 경우, B 는 쌍 하나만 확정 레이블로 주어진 경우다.
import numpy as np, torch
torch.manual_seed(0); np.random.seed(0)
pref  = torch.tensor([0.5, 0.3, 0.2])        # 기준정책
rtrue = torch.tensor([1.0, 0.0, -0.5])       # 참보상(사람 선호를 만든 것)
beta  = 0.5
pstar = pref * torch.exp(rtrue / beta); pstar = pstar / pstar.sum()   # 28장 닫힌식
imp   = lambda z: beta * (torch.log_softmax(z, 0) - torch.log(pref))  # 암묵보상
z = torch.log(pref.clone()).requires_grad_(True)      # [A] 세 쌍 + BT 확률 라벨
opt = torch.optim.Adam([z], lr=0.05)
for it in range(4001):
    h = imp(z)
    L = sum(-(p * torch.log(torch.sigmoid(h[i]-h[j]))
              + (1-p) * torch.log(torch.sigmoid(h[j]-h[i])))
            for i, j in [(0,1),(0,2),(1,2)]
            for p in [torch.sigmoid(rtrue[i]-rtrue[j])]) / 3
    opt.zero_grad(); L.backward(); opt.step()
pi = torch.softmax(z, 0).detach()
print("[A] DPO 수렴 pi =", np.round(pi.numpy(), 6), " L=%.6f" % L.item())
print("    28장 닫힌식 =", np.round(pstar.numpy(), 6),
      " 최대오차 %.3e" % (pi - pstar).abs().max())
print("    r - rhat    =", np.round((rtrue - imp(z)).detach().numpy(), 6), " (= beta*logZ)")
z = torch.log(pref.clone()).requires_grad_(True)      # [B] 쌍 하나 + 하드 라벨
opt = torch.optim.SGD([z], lr=0.5)
for it in range(3001):
    h = imp(z); L = -torch.log(torch.sigmoid(h[0] - h[1]))
    if it in (0, 100, 500, 1500, 3000):
        p = torch.softmax(z, 0).detach().numpy()
        print("    %6d %10.6f %10.6f %10.6f %10.6f %9.6f"
              % (it, L.item(), p[0], p[1], p[2], (h[0]-h[1]).item()))
opt.zero_grad(); L.backward(); opt.step()28장 닫힌식 = [0.90817 0.073744 0.018086] 최대오차 5.960e-08
r - rhat = [0.701588 0.701588 0.701589] (= beta*logZ)
[B] step L pi0 pi1 pi2 margin
0 0.693147 0.500000 0.300000 0.200000 0.000000
100 0.042251 0.981952 0.001097 0.016951 3.142923
500 0.008182 0.996684 0.000040 0.003275 4.801692
1500 0.002694 0.998918 0.000004 0.001078 5.915502
3000 0.001341 0.999462 0.000001 0.000537 6.613563
A 는 3단 표 (가) 와 소수점 여섯 자리까지 일치한다. 보상모델을 학습한 적도, 닫힌식을 코드에 적어 넣은 적도 없이 선호 확률만으로 경사하강을 돌렸는데 π* = πrefexp(r/β)/Z 가 나왔다. r − r̂ 이 세 성분 모두 0.701589 인 것도 확인된다 — 마지막 자리의 흔들림은 부동소수점 오차다.
B 는 반대다. 손실이 0.001341 까지 내려갔고 마진은 6.613563 까지 자랐지만 아직 수렴하지 않았다. 데이터에 나온 적 없는 π(y2) 가 0.2 → 0.000537 로 함께 무너진 것은 아무도 요구하지 않은 일이다. 실제 언어모델이라면 이 자리에 무수히 많은 미관측 응답이 있다.
(b) GRPO 이점과 분산 왜곡
import numpy as np
def adv(r, norm=True, eps=1e-4):
    r = np.asarray(r, float); d = r - r.mean()
    return d / (r.std() + eps) if norm else d
g = [0.9, 0.8, 0.6, 0.5, 0.5, 0.3, 0.2, 0.2]
print("[A] G=8 그룹 표준화")
print("  r    =", np.array(g))
print("  mean = %.6f  std = %.6f  (ddof=1: %.6f)"
      % (np.mean(g), np.std(g), np.std(g, ddof=1)))
print("  Ahat =", np.round((np.array(g)-np.mean(g))/np.std(g), 6))
print("[B] 분산에 따른 가중 왜곡 — 평균 |Ahat|")
for gap in [1.0, 0.5, 0.2, 0.04, 0.004]:
    r = 0.5 + gap*np.array([.5,.5,.5,.5,-.5,-.5,-.5,-.5])
    a, b = np.abs(adv(r)).mean(), np.abs(adv(r, False)).mean()
    print("  %8.3f %14.6f %14.6f %10.1f" % (gap, a, b, a/b))
print("[C] std=0 과 미세 분산")
same = np.full(8, 0.5)
print("  전부 0.5        -> Ahat =", np.round(adv(same), 6))
jit = same.copy(); jit[:4] += 1e-9
print("  1e-9 차이, eps=0    -> Ahat =", np.round(adv(jit, eps=0.0), 6))
print(" 1e-9 차이, eps=1e-4 -> Ahat =", np.round(adv(jit), 8))r = [0.9 0.8 0.6 0.5 0.5 0.3 0.2 0.2]
mean = 0.500000 std = 0.244949 (ddof=1: 0.261861)
Ahat = [ 1.632993 1.224745 0.408248 0. 0. -0.816497 -1.224745
-1.224745]
sum(Ahat) = 0.0000000000 std(Ahat) = 1.000000
[B] 분산에 따른 가중 왜곡 — 평균 |Ahat|
보상격차 표준화함 표준화안함 증폭배수
1.000 0.999800 0.500000 2.0
0.500 0.999600 0.250000 4.0
0.200 0.999001 0.100000 10.0
0.040 0.995025 0.020000 49.8
0.004 0.952381 0.002000 476.2
[C] std=0 과 미세 분산
전부 0.5 -> Ahat = [0. 0. 0. 0. 0. 0. 0. 0.]
1e-9 차이, eps=0 -> Ahat = [ 1. 1. 1. 1. -1. -1. -1. -1.]
1e-9 차이, eps=1e-4 -> Ahat = [ 5.e-06 5.e-06 5.e-06 5.e-06 -5.e-06 -5.e-06 -5.e-06 -5.e-06]
[B] 의 마지막 열이 3단에서 계산한 편향의 정체다. 보상 격차가 1.0 일 때 표준화는 신호를 2배로 키우고, 격차가 0.004 일 때는 476배로 키운다. 격차가 줄어드는 만큼 정확히 되돌리므로, 표준화 이점의 크기는 격차와 거의 무관하게 1 에 머문다 (ε 가 개입하는 마지막 줄만 0.952 로 살짝 눌렸다). 기울기의 크기가 보상의 격차를 더 이상 반영하지 않는다.
[C] 가 3단 (다) 의 std=0 처리와 ε 문턱을 재현한다. 같은 그룹, 같은 데이터인데 ε 한 줄로 이점이 ±1 이 되기도 하고 ±5×10⁻⁶ 이 되기도 한다.
(c) 굿하트 수치 실험
import numpy as np
rp = lambda t: t[0] + t[1]                    # 대리보상
rl = lambda t: t[0]                           # 참보상 (선형)
rq = lambda t: t[0] - 0.5*t[1]**2             # 참보상 (해로운 방향)
print("[A] 선형 굿하트   r=th1, rhat=th1+th2, ||th||<=R")
for R in [0.5, 1, 2, 4, 8, 16]:
    t = np.array([R, R]) / np.sqrt(2)       # 코시-슈바르츠: (1,1) 방향
    print("  %6.1f  (%8.4f,%8.4f) %10.6f %10.6f %10.6f %9.6f"
          % (R, t[0], t[1], rp(t), rl(t), R, R - rl(t)))
print("[B] 원 위 균일분포에서의 상관계수")
ph = np.linspace(0, 2*np.pi, 2000001)[:-1]
for lam in [1.0, 0.2]:
    a, b = np.cos(ph), np.cos(ph) + lam*np.sin(ph)
    print("  rhat=th1+%.1f*th2 : corr=%.6f  후회=%.6f R"
          % (lam, np.corrcoef(a, b)[0,1], 1 - 1/np.sqrt(1+lam**2)))
print("[C] 참보상이 꺾인다   r=th1-0.5*th2^2")
for R in [0.5, 1.0, np.sqrt(2), 2.0, 3.0, 4.0, 6.0, 8.0]:
    t = np.array([R, R]) / np.sqrt(2)
    print("  %8.4f %10.6f %12.6f" % (R, rp(t), rq(t)))
print("[D] KL 페널티 쓸기  max rhat - (beta/2)||th||^2  ->  th=(1/b,1/b)")
for b in [4.0, 2.0, 1.5, 1.0, 0.8, 0.6, 0.5, 0.25, 0.1]:
    u = 1/b
print(" %6.2f %8.4f %10.4f %10.6f %12.6f" % (b, u, u*u, 2*u, u - u*u/2))R theta_proxy rhat r r_best 후회
0.5 ( 0.3536, 0.3536) 0.707107 0.353553 0.500000 0.146447
1.0 ( 0.7071, 0.7071) 1.414214 0.707107 1.000000 0.292893
2.0 ( 1.4142, 1.4142) 2.828427 1.414214 2.000000 0.585786
4.0 ( 2.8284, 2.8284) 5.656854 2.828427 4.000000 1.171573
8.0 ( 5.6569, 5.6569) 11.313708 5.656854 8.000000 2.343146
16.0 ( 11.3137, 11.3137) 22.627417 11.313708 16.000000 4.686292
[B] 원 위 균일분포에서의 상관계수
rhat=th1+1.0*th2 : corr=0.707107 후회=0.292893 R
rhat=th1+0.2*th2 : corr=0.980581 후회=0.019419 R
[C] 참보상이 꺾인다 r=th1-0.5*th2^2
R rhat r 상태
0.5000 0.707107 0.291053 상승
1.0000 1.414214 0.457107 상승
1.4142 2.000000 0.500000 정점
2.0000 2.828427 0.414214 해킹
3.0000 4.242641 -0.128680 해킹
4.0000 5.656854 -1.171573 해킹
6.0000 8.485281 -4.757359 해킹
8.0000 11.313708 -10.343146 해킹
[D] KL 페널티 쓸기 max rhat - (beta/2)||th||^2 -> th=(1/b,1/b)
beta u=1/b KL~u^2 rhat=2u r=u-u^2/2
4.00 0.2500 0.0625 0.500000 0.218750
2.00 0.5000 0.2500 1.000000 0.375000
1.50 0.6667 0.4444 1.333333 0.444444
1.00 1.0000 1.0000 2.000000 0.500000
0.80 1.2500 1.5625 2.500000 0.468750
0.60 1.6667 2.7778 3.333333 0.277778
0.50 2.0000 4.0000 4.000000 0.000000
0.25 4.0000 16.0000 8.000000 -4.000000
0.10 10.0000 100.0000 20.000000 -40.000000
[B] 가 이 장에서 가장 불편한 숫자다. 상관 0.980581 짜리 대리보상 — 산점도를 그리면 거의 직선으로 보일 것이다 — 조차 후회 0.019419 R 를 남기고, 그 후회는 R 에 비례해 자란다. 대리지표의 품질을 상관으로 보고하는 관행은 최적화 강도를 함께 말하지 않으면 아무것도 보장하지 않는다.
시각화: 소거의 세 걸음 · 표준화 · 갈라지는 두 곡선

이것만 기억하자
- DPO 는 28장 최적해의 역함수다. r = β log(π/πref) + β log Z 를 브래들리–테리에 넣으면 β log Z 가 차이 안에서 정확히 소거된다. 3단 검산에서 r − r̂ 이 세 응답 모두 0.701589 = β log Z 로 같았다. 근사가 아니라 항등식이다.
- GRPO 는 가치망을 그룹 통계로 바꾼다. 평균을 빼는 데까지는 16장 기저선 정리가 보호하지만, 표준편차로 나누는 순간 그 보호를 잃는다. 격차 1.00 과 0.04 인 두 프롬프트가 똑같이 ±1 을 받는다.
- 굿하트는 상관으로 막을 수 없다. 상관 0.980581 짜리 대리보상도 후회 0.019419R 를 남기고, 그 후회는 최적화 강도 R 에 비례해 자란다. KL 페널티의 β 는 R 을 조절하는 손잡이일 뿐이고, 최적 β(이 모형에서 정확히 1)를 고르려면 알 수 없는 참보상을 알아야 한다.
흔한 오해
- "DPO 는 PPO-RLHF 의 값싼 근사다" — 선호쌍이 충분하고 레이블이 브래들리–테리를 따르면 DPO 의 해는 KL 정규화 목적의 정확한 최적해다. 4단 [A] 가 닫힌식을 6×10⁻⁸ 오차로 재현했다. 진짜 차이는 정확도가 아니라 온라인 표본을 쓸 수 없다는 것 — 26장 오프라인 RL 의 분포 이동과 같은 병이고, 처방도 같다(반복 DPO).
- "DPO 는 보상모델이 없으니 보상 해킹에서 자유롭다" — 대리보상이 선호 데이터 자체로 옮겨 갔을 뿐이다. 사람 평가자가 긴 답변을 선호했다면 그 편향이 그대로 목적함수다. 게다가 데이터 밖 응답은 제어되지 않는다 — 4단 [B] 에서 한 번도 언급되지 않은 y2 의 확률이 0.2 → 0.000537 로 무너졌다.
- "그룹 표준화는 스케일만 맞추는 무해한 전처리다" — 스케일을 맞추는 행위가 곧 프롬프트 간 가중치를 바꾸는 행위다. 4단 [B] 에서 격차 0.004 인 그룹의 신호가 476배로 증폭됐다. 평균만 빼면 이 편향이 없고, std=0 인 그룹은 자연히 이점 0 이 되어 빠진다 — 그것이 옳은 동작이다.
- "KL 페널티를 걸었으니 보상 해킹은 막았다" — β 는 최적화 강도를 줄일 뿐이고, 참보상은 β 를 키울수록 같이 줄어든다. 3단 (마) 표에서 β=4 는 안전하지만 r=0.219 밖에 못 얻고, β=0.25 는 r=−4 다. KL 은 굿하트를 늦출 뿐 방향을 바꾸지 못한다. 필요한 것은 학습에 쓰지 않은 검증 신호와 그것이 꺾일 때 멈추는 규율이다.
'강화학습' 카테고리의 다른 글
| [강화학습 30] 무엇을 이겼다고 말할 수 있나 (완결) (0) | 2026.09.15 |
|---|---|
| [강화학습 28] RLHF ① 선호에서 보상모델로 (1) | 2026.09.15 |
| [강화학습 27] 모방학습과 역강화학습 (0) | 2026.09.15 |
| [강화학습 26] 오프라인 RL — 환경 없이 로그만 있을 때 (0) | 2026.09.15 |
| [강화학습 25] MCTS와 AlphaZero — 탐색이 정책을 가르친다 (0) | 2026.09.15 |
댓글