■ 사진 속 조명, 그냥 배경이 아니었다
같은 강아지 사진이라도 해질녘 노을빛 아래서 찍으면 분위기가 확 달라진다. 사람은 조명이 아무리 바뀌어도 "이건 강아지"라는 판단을 흔들림 없이 유지한다. 그런데 요즘 이미지와 텍스트를 함께 이해하는 비전-언어 모델, 즉 VLM(Vision-Language Model)에게 똑같은 질문을 던지면 어떨까. 베이항대학교(Beihang University) 인공지능연구소 연구진이 2025년 발표한 이 논문은 바로 이 지점을 파고든다. 픽셀을 억지로 뒤틀거나 이상한 노이즈를 뿌리는 기존 적대적 공격과 달리, 이번 연구는 오직 "빛의 방향과 세기"만 바꿔서 VLM을 속일 수 있는지를 실험했다. 결과는 놀랍게도 조명 몇 개만 살짝 옮겨도 최신 모델들이 크게 흔들린다는 것이었다. 연구진은 이 공격 기법에 ITA(Illumination Transformation Attack)라는 이름을 붙였고, 이는 조명 변화만으로 VLM의 강건성을 체계적으로 평가한 첫 프레임워크라고 소개된다.
■ 왜 하필 조명인가
기존의 적대적 공격 연구들은 대부분 사람 눈에는 보이지 않는 미세한 픽셀 노이즈를 이미지에 심는 방식이었다. 문제는 이런 노이즈가 인위적이고 부자연스러워서, 실제 카메라로 찍힌 사진에서는 잘 나타나지 않는다는 점이다. 반면 조명은 언제나 존재하는 현실적인 변수다. 실외 촬영, 실내조명, 역광, 그림자 등 우리가 매일 마주치는 환경 자체가 이미 조명 변화의 연속이다. 즉 조명 기반 공격이 성공한다면, 이는 실험실 안의 이론적 위협이 아니라 자율주행차의 카메라, 보안 CCTV, 스마트폰 비전 앱처럼 실제 서비스에서도 벌어질 수 있는 취약점이라는 뜻이 된다. 연구진이 조명을 공격 수단으로 선택한 이유가 바로 여기에 있다.
■ 빛을 조각내고 다시 조립하는 방법
ITA의 핵심 아이디어는 하나의 전역 조명을 여러 개의 작은 점광원으로 쪼개는 것이다. 각 점광원은 위치, 밝기, 그리고 영향을 미치는 반경이라는 세 가지 값으로 표현되고, 가우시안 함수 형태로 퍼져나가며 서로 겹쳐 최종 조명을 만들어낸다. 이렇게 여러 광원을 조합하면 단일 조명보다 훨씬 다양하고 자연스러운 빛 패턴을 만들 수 있다.
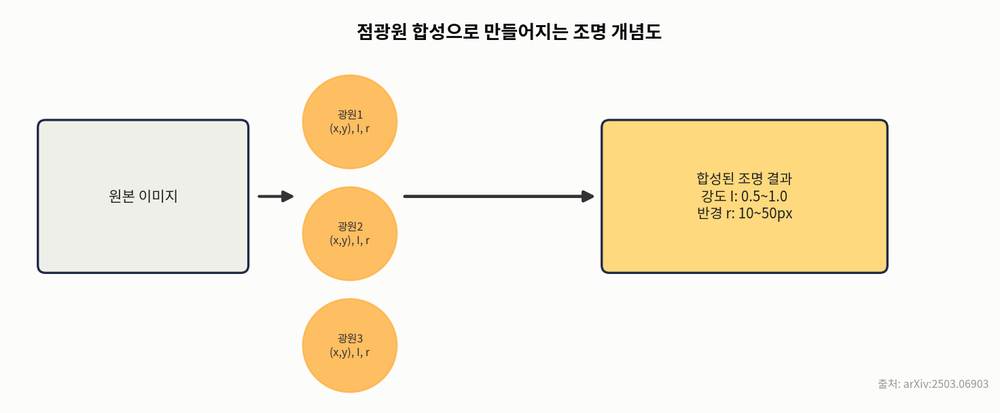
여기서 흥미로운 점은 픽셀을 직접 건드리지 않는다는 것이다. 연구진은 물리 기반 조명 복원 모델인 IC-Light라는 디퓨전 모델의 잠재공간(latent space)에서 조명 파라미터를 조작한다. 이 방식 덕분에 결과물이 물리적으로 그럴듯한 빛 표현을 유지하면서도 공격 목적에 맞게 조정될 수 있다. 다만 디퓨전 모델은 미분이 불가능한 구조라 일반적인 경사하강법을 쓸 수 없기 때문에, 연구진은 CMA-ES라는 경사 없이도 최적화가 가능한 진화 알고리즘을 사용해 조명 파라미터를 반복적으로 개선해나간다. 최적화 과정에는 모델이 정답을 헷갈리게 만드는 목적 함수뿐 아니라, 원본 이미지와의 시각적 유사성을 지키는 LPIPS 기반 제약, 그리고 여러 광원이 한 점으로 몰리지 않도록 하는 다양성 제약까지 함께 반영된다.
■ 실제로 얼마나 흔들렸나
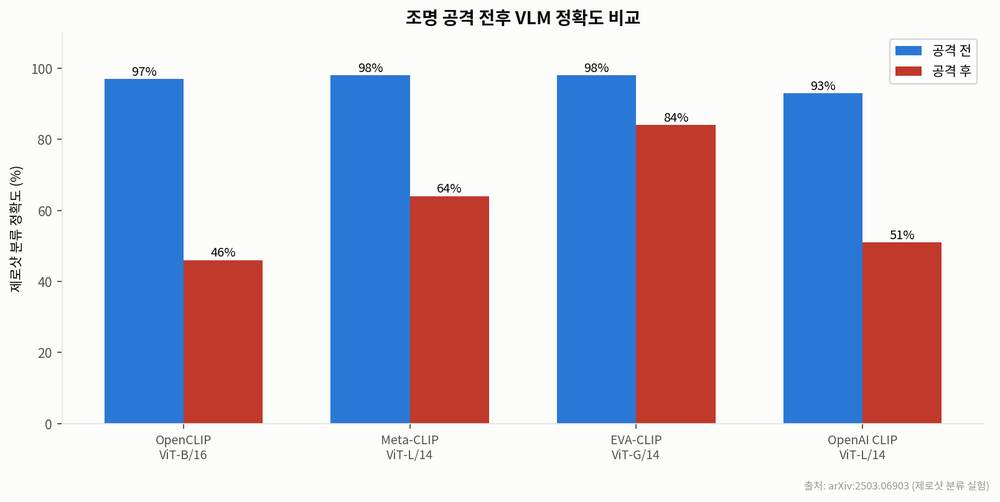
연구진은 COCO 데이터셋에서 30개 카테고리, 300장의 이미지를 골라 다양한 VLM에 ITA 공격을 시도했다. 제로샷 분류 실험에서 OpenCLIP ViT-B/16은 원래 97%였던 정확도가 46%까지 떨어졌고, OpenAI CLIP ViT-L/14도 93%에서 51%로 대폭 하락했다. Meta-CLIP ViT-L/14 역시 98%에서 64%로 낮아졌다. 흥미롭게도 상대적으로 규모가 큰 EVA-CLIP ViT-G/14는 98%에서 84%로 하락 폭이 작아, 모델 크기나 학습 방식에 따라 조명 공격에 대한 저항력이 다르게 나타난다는 점도 확인됐다.
이미지 캡셔닝과 시각 질의응답(VQA) 과제에서도 성능 저하가 뚜렷했다. OpenFlamingo, BLIP-2, LLaVA-1.5, LLaVA-1.6, InstructBLIP 등 널리 쓰이는 모델들 모두에서 캡션 품질과 답변 정확도가 원본 대비 눈에 띄게 낮아졌다. 그럼에도 불구하고 GPT-4를 활용한 자연스러움 평가에서는 조명이 조작된 이미지들이 여전히 그럴듯한 사진으로 인식되었다는 점이 중요하다. 즉 사람 눈에는 그저 "조명이 다른 사진"으로 보이지만, 모델 내부에서는 판단이 완전히 뒤바뀌고 있었다는 뜻이다.
■ 이 연구가 던지는 질문
이 논문이 흥미로운 이유는 공격 기법 자체보다, 그 공격이 지나치게 자연스럽다는 데 있다. 노이즈를 심거나 이미지를 왜곡하는 방식은 탐지가 비교적 쉽지만, 조명 변화는 우리가 매일 마주치는 자연 현상이라 방어하기가 훨씬 까다롭다. 자율주행이나 보안 시스템처럼 실외 조명 환경에 그대로 노출되는 서비스일수록 이런 취약점은 더 치명적일 수 있다. 다만 이번 연구는 분류 모델을 대상으로 만든 적대적 예시를 캡셔닝과 VQA 모델에 전이하는 방식에 의존하고 있어, 각 과제에 특화된 직접 공격까지 다루지는 못했다는 한계도 있다. 그럼에도 조명이라는 지극히 평범한 요소가 최신 VLM의 아킬레스건이 될 수 있음을 실증적으로 보여줬다는 점에서, 앞으로 VLM을 실제 환경에 배포할 때 조명 강건성을 진지하게 고려해야 한다는 신호탄으로 읽힌다.
댓글