■ 왜 지금 '걷기 보조 AI'인가
전 세계에는 약 2억 명에 이르는 시각장애인이 있다고 한다. 이들이 매일 겪는 가장 기본적인 어려움 중 하나가 바로 '걷기'다. 계단, 튀어나온 자전거, 갑자기 나타나는 차량, 공사 구간까지 우리가 무심코 지나치는 거리의 위험 요소들이 이들에게는 매 순간의 판단이 필요한 장애물이다. 지팡이나 안내견이 오랫동안 이 역할을 해왔지만, 물리적 접촉이나 훈련된 동물에 의존하는 방식에는 한계가 뚜렷하다.
그래서 등장한 것이 카메라와 인공지능을 결합한 보행 보조 시스템이다. 최근 비전-언어모델(VLM)이 이미지를 보고 자연어로 설명하는 능력이 크게 발전하면서, "지금 앞에 무엇이 있고 어떻게 해야 하는지"를 실시간 음성으로 알려주는 서비스가 현실적인 대안으로 떠오르고 있다. 이번에 소개할 논문 WalkVLM은 바로 이 지점, 즉 실시간 영상을 이해해서 꼭 필요한 순간에만 간결한 리마인더를 제공하는 모델을 제안한다. ICCV 2025에 발표된 이 연구는 저자 이메일 등을 통해 중국과학원대학교(UCAS) 계열 연구진이 참여한 것으로 파악되며, 정확한 소속 표기는 논문 원문 확인이 필요하다.
■ 기존 연구가 부딪힌 두 가지 벽
이 분야 연구가 생각보다 더디게 발전한 데는 이유가 있다. 첫째, 학습에 쓸 만한 데이터셋이 턱없이 부족했다. 기존 연구들은 각자 자체적으로 만든 질의응답(QA) 데이터셋을 사용했는데, 이 데이터들이 공개되지 않아 후속 연구자들이 재현하거나 비교하기 어려웠다. 둘째, 일반적인 VLM을 그대로 가져다 쓰면 문제가 생긴다. 이런 모델들은 사진 한 장을 보고 장황하고 상세한 설명을 만들어내는 데는 능하지만, 걷고 있는 사람에게는 그런 설명이 오히려 독이 된다. "왼쪽에 나무가 있고 그 뒤로 파란 지붕의 건물이 보이며..." 같은 긴 문장을 듣는 사이에 정작 중요한 위험은 지나쳐 버릴 수 있기 때문이다.
즉 보행 보조 AI에 필요한 것은 정확한 상황 인식뿐 아니라, 언제 말해야 하는지와 얼마나 짧게 말해야 하는지를 함께 판단하는 능력이다. 이것이 이 논문이 정면으로 다룬 문제다.
■ WalkVLM은 무엇이 다른가
연구진은 두 가지 축으로 문제를 풀었다. 하나는 데이터, 다른 하나는 모델 구조다.
먼저 데이터 측면에서 연구진은 Walking Awareness Dataset(WAD)이라는 대규모 벤치마크를 새로 구축했다. 유럽과 아시아 등 다양한 지역에서 촬영한 영상에 사람이 직접 주석을 단 1만 2천 개의 영상-주석 쌍으로 구성되어 있으며, 각 영상에는 날씨, 지역 유형(인도, 횡단보도 등), 위험도, 교통 흐름 등급, 상황 요약, 객체 탐지 라벨까지 폭넓은 메타데이터가 함께 기록되어 있다. 이는 기존에 공개되지 않았던 데이터의 공백을 메우는 동시에, 리마인더 생성 과제와 QA 과제를 모두 학습·평가할 수 있게 설계된 점이 특징이다.
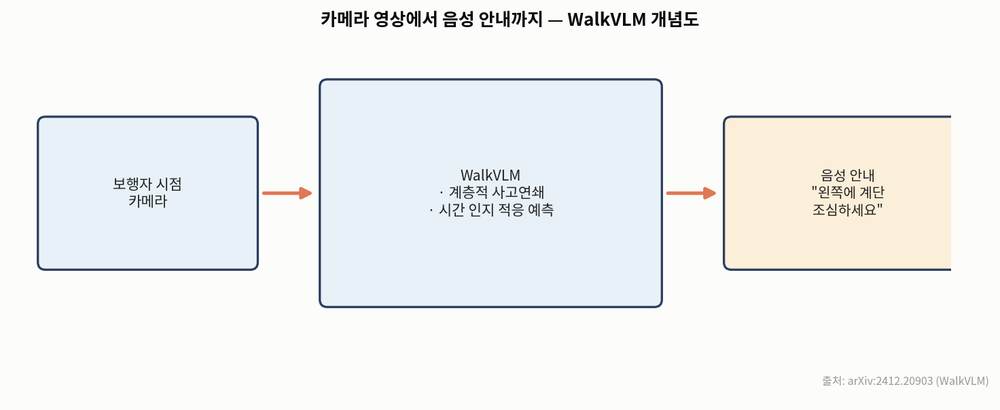
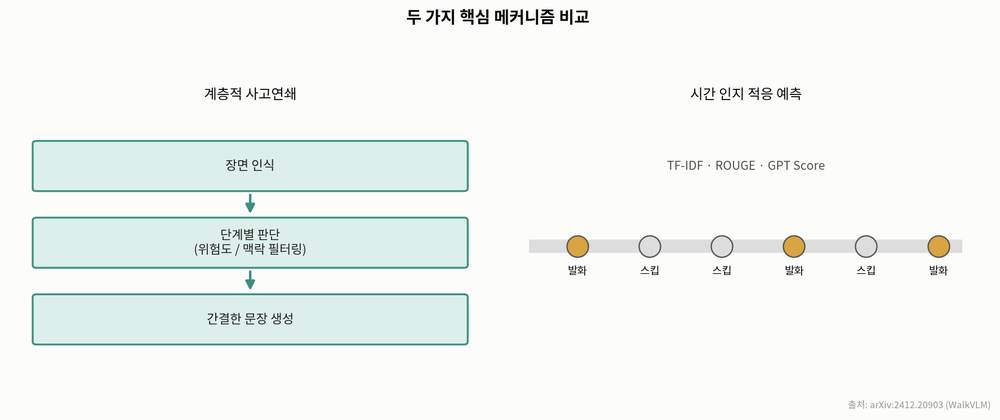
모델 구조 측면에서는 두 가지 핵심 메커니즘이 도입됐다. 첫째는 계층적 사고연쇄(Chain-of-Thought Hierarchical Planning)다. 모델이 곧바로 "이렇게 말하라"고 답을 내놓는 대신, 장면을 단계적으로 이해한 뒤 정말 전달할 가치가 있는 정보만 걸러내어 간결한 문장으로 압축하는 과정을 거친다. 마치 노련한 안내자가 초행길 동행에게 "저기 조심하세요" 한마디만 던지듯, 불필요한 수식어를 걷어내는 방식이다.
둘째는 시간 인지 적응 예측(Temporal-aware Adaptive Prediction)이다. 이것이 특히 흥미로운 부분인데, 실시간 스트리밍 영상에서는 매 프레임마다 안내 문장을 새로 만들 필요가 없다. 이미 알려준 위험 요소를 계속 반복해서 말하면 오히려 사용자에게 소음이 된다. 이 메커니즘은 시간의 흐름에 따라 지금 새로 말할 필요가 있는 순간인지, 아니면 이전 안내로 충분한지를 스스로 판단해서 중복 발화를 줄인다.
■ 실험에서 확인된 것들
연구진은 WalkVLM을 MiniCPM-V2.6을 포함한 여러 비전-언어모델과 비교했다. 평가에는 생성된 문장이 정답 주석과 얼마나 겹치는지를 보는 TF-IDF 점수, ROUGE 지표, 그리고 GPT를 활용해 응답 품질을 채점하는 GPT Score 등 세 가지 방식이 함께 사용됐다. 구체적인 수치는 논문 원문에서 표로 확인할 수 있지만, 공통적으로 확인되는 경향은 WalkVLM이 비교 모델들보다 더 간결하면서도 핵심 정보를 놓치지 않는 안내문을 생성했고, 특히 스트리밍 상황에서 불필요한 반복 발화가 적었다는 점이다.
이는 단순히 "얼마나 정확하게 설명하는가"를 넘어서, "얼마나 사용자 친화적으로 정보를 전달하는가"라는 실용적 기준에서 의미 있는 결과다. 실제 보행 보조 상황에서는 완벽한 서술보다 적절한 타이밍의 짧은 한마디가 훨씬 가치 있기 때문이다.
■ 남은 과제와 이 연구가 가리키는 방향
WalkVLM은 데이터와 모델 양쪽에서 이 분야의 공백을 채운 시도라는 점에서 의미가 크다. 특히 데이터셋과 코드를 공개함으로써 후속 연구자들이 같은 기준으로 성능을 비교할 수 있는 발판을 마련했다는 점은 학술적으로도 실질적으로도 중요하다.
다만 실제 서비스로 이어지기까지는 넘어야 할 산이 남아 있다. 다양한 국가의 도로 환경, 언어, 문화적 맥락에 얼마나 잘 일반화되는지, 저조도나 악천후 같은 극단적 상황에서도 안정적으로 작동하는지, 그리고 무엇보다 실제 시각장애인 사용자들이 현장에서 느끼는 신뢰도와 만족도는 별도의 검증이 필요한 영역이다. 그럼에도 불구하고, AI가 사람의 눈을 완전히 대신하기보다 '적절한 순간에 적절한 한마디를 건네는 동반자'로 설계되어야 한다는 이 논문의 문제의식은, 앞으로 나올 보조기술 연구들이 참고할 만한 좋은 출발점이 될 것이다.
댓글