■ 왜 AI는 아직도 글자를 못 쓸까
이미지 생성 AI에게 "생일 축하해"라는 문구가 적힌 케이크 사진을 그려달라고 하면 어떤 일이 벌어질까요. 열에 아홉은 알파벳처럼 보이는 이상한 기호가 뭉개진 결과물이 나옵니다. Stable Diffusion이나 Flux 같은 최신 확산 모델들도 사람 얼굴이나 풍경은 놀랍도록 잘 그리면서 유독 글자 앞에서는 작아집니다. 왜 그럴까요. 그림을 그리는 것과 글자를 쓰는 것은 근본적으로 다른 작업이기 때문입니다. 그림은 대략적인 형태와 색감만 맞아도 그럴듯해 보이지만, 글자는 획 하나만 삐끗해도 즉시 오타로 인식됩니다. 게다가 폰트를 굵게, 기울임으로, 밑줄로 표현하는 것처럼 단어 하나하나에 세밀한 타이포그래피 제어를 거는 일은 기존 모델들이 아예 학습한 적 없는 영역이었습니다. 2024년 12월 공개되고 ICCV 2025에 채택된 FonTS는 바로 이 문제, 즉 이미지 속 텍스트를 정확하게 그리면서도 단어 단위로 폰트 스타일까지 제어하는 방법을 제안한 논문입니다. 홍콩이공대학교, 싱가포르국립대학교, 저장대학교, 그리고 스타트업 Tiamat AI 소속 연구진이 함께 참여했습니다.
■ 핵심 아이디어: 두 단계로 나눠서 풀기
FonTS의 전략은 단순합니다. 한 번에 모든 것을 해결하려 하지 말고 문제를 둘로 쪼개자는 것입니다. 첫 번째 단계는 텍스트 자체를 정확하고 통제 가능하게 렌더링하는 것, 두 번째 단계는 그렇게 그려진 텍스트에 원하는 스타일을 입히는 것입니다. 이 논문은 최근 이미지 생성의 주류가 된 DiT, 즉 트랜스포머 기반 확산 모델을 기반으로 삼습니다. 마치 건물을 지을 때 뼈대를 먼저 세우고 나서 인테리어를 하는 것과 비슷합니다. 뼈대가 부실하면 아무리 화려한 인테리어를 해도 무너지기 마련이죠. FonTS는 이 순서를 지키는 대신, 각 단계에 딱 필요한 만큼의 학습만 얹어 전체 모델을 처음부터 다시 훈련시키지 않고도 문제를 해결합니다.
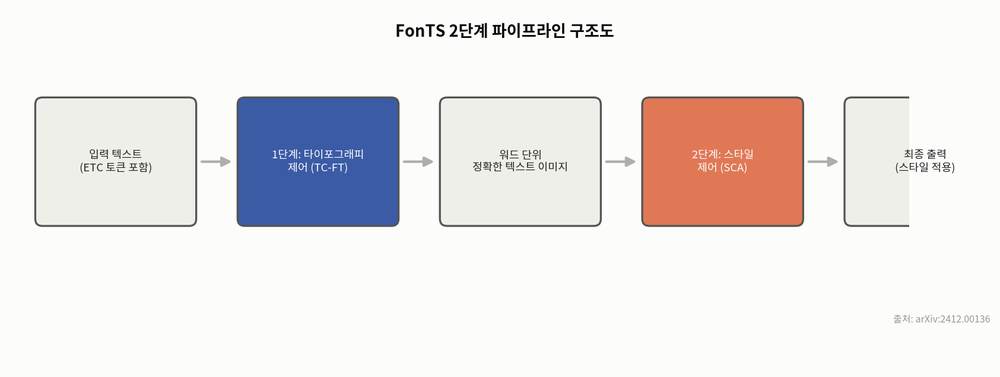
■ 타이포그래피 컨트롤 파인튜닝, 단어마다 태그를 붙이다
첫 단계의 핵심은 TC-FT, 즉 타이포그래피 컨트롤 파인튜닝입니다. 아이디어는 의외로 HTML과 비슷합니다. 웹페이지를 만들 때 굵게 표시하고 싶은 단어를 태그로 감싸듯, FonTS는 텍스트 프롬프트 안에서 굵게, 기울임, 밑줄을 적용하고 싶은 단어를 특수 토큰으로 감쌉니다. 연구진은 이런 데이터를 대량으로 확보하기 위해 실제로 HTML 렌더링을 활용해 단어 단위로 스타일이 지정된 학습 데이터셋을 새로 만들었습니다. 이런 세밀한 데이터셋이 없었다는 점이 지금까지 이 연구가 잘 이뤄지지 않았던 이유이기도 합니다. 더 인상적인 점은 이 모든 것을 학습하기 위해 모델 전체를 다시 훈련시키지 않았다는 것입니다. 텍스트와 이미지가 서로 정보를 주고받는 어텐션 레이어 중 일부만, 전체 파라미터의 극히 일부만 파인튜닝했습니다. 비유하자면 요리사 한 명을 처음부터 다시 가르치는 대신, 이미 숙련된 요리사에게 새로운 플레이팅 기법 하나만 짧게 코칭해주는 셈입니다. 적은 자원으로도 큰 효과를 낼 수 있다는 이 방식은 최근 생성 모델 연구 전반에서 각광받는 파라미터 효율적 학습의 흐름과 맞닿아 있습니다.
■ 스타일을 입히되 내용은 훔치지 않기
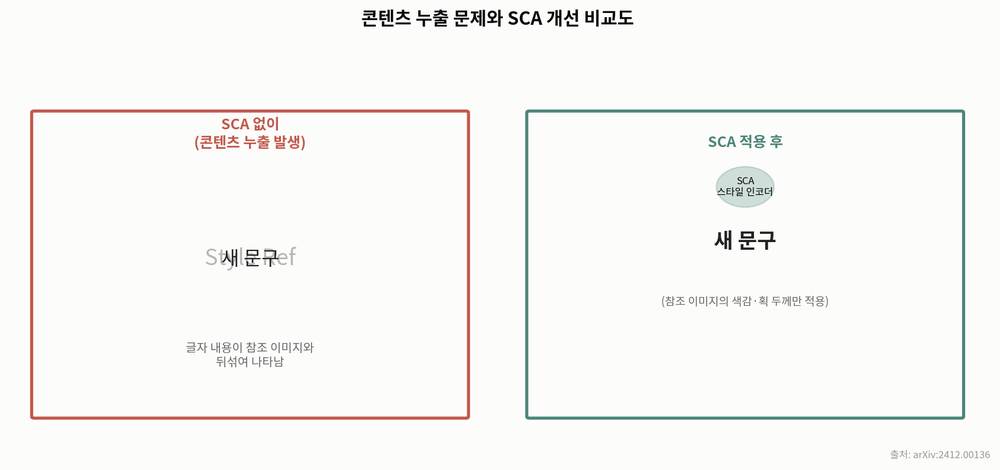
텍스트를 정확히 쓸 수 있게 됐다면, 다음 문제는 스타일입니다. 예를 들어 참고 이미지로 화려한 캘리그래피 스타일을 주고 "행복한 하루"라는 문구를 그 스타일로 그려달라고 하면 어떤 일이 벌어질까요. 많은 기존 모델들은 스타일뿐 아니라 참고 이미지에 적혀 있던 원래 글자 내용까지 슬쩍 따라 그리는 콘텐츠 누출 문제를 겪습니다. 스타일을 배우라고 줬더니 엉뚱한 글자까지 베껴오는 셈이죠. FonTS는 이 문제를 해결하기 위해 스타일 컨트롤 어댑터, SCA를 제안합니다. 핵심은 스타일을 읽어들이는 인코더를 텍스트 내용에 무감각하게 만드는 것입니다. 이미지의 색감, 획의 두께, 장식적 요소 같은 순수한 시각적 스타일만 뽑아내고 그 안에 어떤 글자가 쓰여 있었는지는 최대한 무시하도록 설계했습니다. 학습도 두 단계로 나눠, 먼저 일반적인 미적 이미지로 스타일 감각을 익힌 뒤 실제 예술적 텍스트 이미지로 세밀하게 다듬는 방식을 택했습니다.
■ 실험 결과가 말해주는 것
연구진은 기본적인 텍스트 렌더링, 예술적 텍스트 렌더링, 장면 속 텍스트 렌더링까지 세 가지 상황에서 FonTS를 검증했습니다. 기본 렌더링 실험에서는 문자 인식 정확도와 폰트 일관성 측면에서 기존 확산 기반 모델들과 비교해 경쟁력 있는 성능을 보였고, 특히 장면 속에 텍스트를 자연스럽게 녹여 넣는 실험에서는 최신 대형 모델인 Flux보다 문자 인식 정확도가 크게 앞섰습니다. 예술적 텍스트 렌더링에서 진행한 사용자 평가에서도 스타일 일관성 측면에서 준수한 평가를 받았습니다. 물론 모든 지표에서 압도적인 것은 아니고, 전문 텍스트 렌더링에 특화된 일부 모델에는 문자 정확도 면에서 못 미치는 부분도 있었습니다. 그럼에도 단어 단위 스타일 제어라는, 지금까지 다른 모델들이 시도조차 하지 못했던 기능을 안정적으로 구현했다는 점에서 의미가 큽니다.
■ 의미와 한계
FonTS가 보여주는 방향은 명확합니다. 이미지 생성 모델에 새로운 능력을 추가하고 싶을 때, 반드시 거대한 모델을 처음부터 다시 학습시킬 필요는 없다는 것입니다. 전체 파라미터의 극히 일부만 건드리는 파인튜닝과, 목적에 맞게 설계된 작은 어댑터 하나로도 이전에는 불가능했던 세밀한 제어가 가능해질 수 있습니다. 포스터 디자인, 로고, 광고 이미지처럼 텍스트와 디자인이 함께 어우러져야 하는 실무 영역에서 이런 기술의 쓸모는 상당히 클 것으로 보입니다. 다만 아직 한글을 포함한 비라틴 문자권에 대한 검증은 이뤄지지 않았고, 단어 수가 많아지거나 문장이 길어질수록 정확도가 떨어질 가능성도 남아 있습니다. 데이터셋과 모델을 공개하겠다고 밝힌 만큼, 앞으로 다양한 언어와 디자인 환경에서 이 접근이 얼마나 확장될 수 있을지 지켜볼 필요가 있습니다.
댓글