■ 농업 현장에 AI를 데려가면 무슨 일이 벌어질까
스마트폰 카메라로 작물 잎사귀를 찍으면 병충해를 바로 알려주는 앱, 다들 한 번쯤 상상해봤을 겁니다. 요즘 GPT-4o나 Gemini 같은 비전-언어 모델(VLM)은 이미지를 보고 자연스럽게 설명하는 능력이 놀라울 정도로 좋아졌죠. 그런데 정작 "이 잎에 핀 반점이 무슨 병인지", "이 벌레가 어떤 해충인지", "이 풀이 잡초인지 작물인지"를 물어보면 얼마나 정확할까요? 오사카대학교, 교토대학교, 도쿄공업대학교, 일본산업기술종합연구소(AIST), 옥스퍼드대학교 VGG, OMRON SINIC X 소속 연구진이 이 질문에 정면으로 답하기 위해 내놓은 것이 바로 AgroBench입니다. ICCV 2025에 채택된 이 논문은 농업 도메인에서 VLM의 실력을 제대로 측정할 벤치마크가 없다는 문제의식에서 출발합니다.
■ 전문 농학자가 직접 검수한 벤치마크
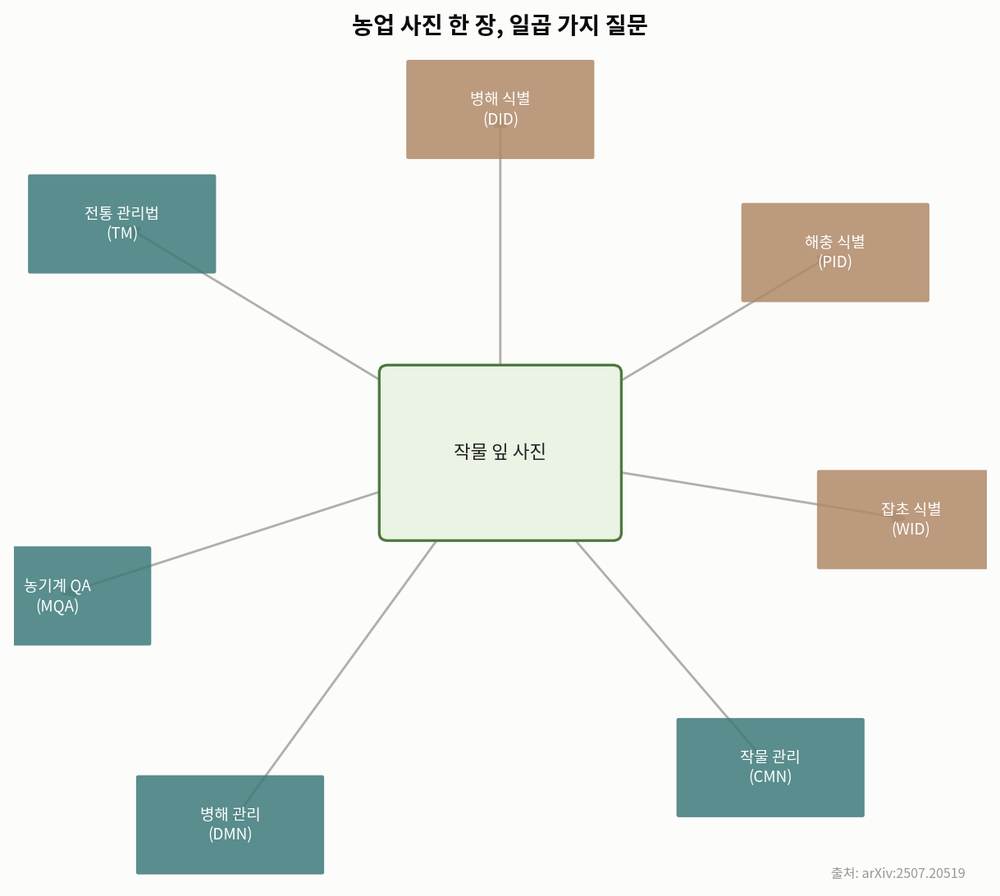
AgroBench가 특별한 이유는 데이터의 '품질'에 있습니다. 연구진은 3,745장의 고화질 농업 이미지에 대해 총 4,342개의 질의응답 쌍을 만들었는데, 이 라벨들은 실제 농학 전문가의 검수를 거쳤습니다. 인터넷에서 대충 긁어모은 이미지에 크라우드소싱으로 라벨을 붙이는 기존 방식과는 결이 다릅니다. 다루는 범위도 상당히 넓어서 682종의 병해, 134종의 해충, 108종의 잡초, 203종의 작물 카테고리를 아우릅니다. 이 방대한 데이터를 가지고 연구진은 질문 유형을 일곱 가지 태스크로 나눴습니다. 병해 식별(DID), 해충 식별(PID), 잡초 식별(WID), 작물 관리(CMN), 병해 관리(DMN), 농기계 사용 질의응답(MQA), 전통 관리법(TM)입니다. 단순히 "이게 뭐야?"를 넘어 "이 병에는 어떻게 대처해야 해?"까지 묻는다는 점에서, 실제 농부가 궁금해할 법한 질문들을 그대로 시험대에 올린 셈입니다.
■ 잡초 앞에서 무너지는 최신 AI 모델들
연구진은 GPT-4o, GPT-4o mini, Gemini 1.5-Pro, Gemini 1.5-Flash 같은 폐쇄형 모델과 LLaVA, QwenVLM, CogVLM, EMU2Chat 등 다양한 크기의 오픈소스 모델을 모두 테스트했습니다. 전체 평균만 보면 그럴듯합니다. GPT-4o가 73.45%로 1위, Gemini 1.5-Pro가 72.24%로 근소하게 뒤를 이었고, 오픈소스 중에서는 QwenVLM-72B가 70.66%로 선전했습니다. 무작위로 답을 찍었을 때의 기대 정확도가 19.03%인 것을 감안하면 꽤 준수해 보입니다.
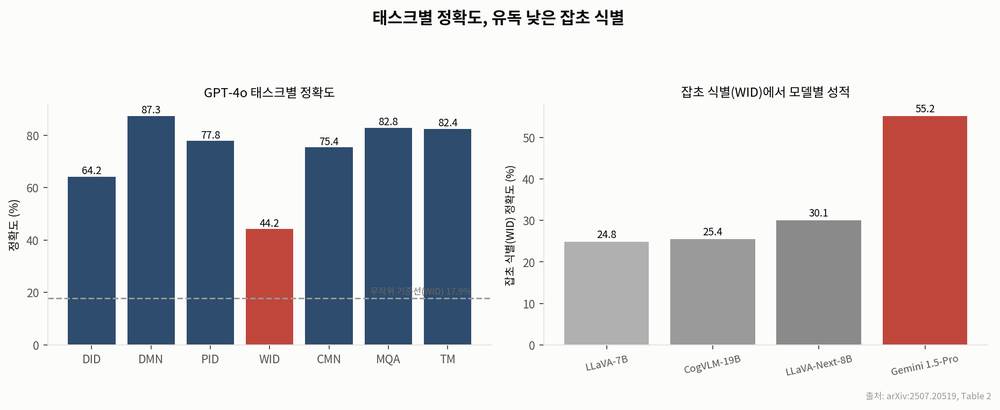
문제는 태스크를 쪼개서 보는 순간 드러납니다. 잡초 식별(WID) 항목에서 성적이 뚝 떨어지는 겁니다. 이 태스크의 무작위 정답률은 17.90%인데, LLaVA-7B는 24.79%, CogVLM-19B는 25.45%, LLaVA-Next-8B는 30.05%에 그쳐 사실상 '찍는 수준'과 큰 차이가 없었습니다. 가장 뛰어난 성능을 보인 Gemini 1.5-Pro조차 55.17%로, 다른 태스크에서 보여준 압도적인 성능과는 거리가 멀었습니다. 참고로 GPT-4o의 태스크별 성적을 보면 병해 관리(DMN) 87.35%, 농기계 QA(MQA) 82.84%처럼 텍스트·상식 기반 질문에는 강했지만, 잡초 식별에서는 44.17%로 다른 태스크 대비 눈에 띄게 낮았습니다.
■ 왜 유독 잡초에서 약할까
사람이 봐도 잡초와 작물 새싹을 구분하는 건 쉬운 일이 아닙니다. 어린 시기의 식물은 잎 모양이나 색깔이 비슷비슷하고, 지역과 계절에 따라 같은 잡초라도 생김새가 조금씩 달라집니다. 병해나 해충은 특징적인 반점, 구멍, 벌레의 형태 같은 '눈에 띄는 단서'가 있는 반면, 잡초는 미묘한 잎맥 패턴이나 줄기 각도처럼 훨씬 섬세한 시각적 차이에 의존해야 합니다. VLM들은 인터넷에서 흔히 접할 수 있는 유명한 질병 사진이나 해충 이미지에는 이미 많이 노출됐을 가능성이 높지만, 지역 특화된 잡초 이미지와 이름은 학습 데이터에서 훨씬 드물었을 것이라는 추정이 가능합니다. 실제로 연구진이 진행한 사람 대상 검증 실험에서도, 사람 참가자들이 특정 태스크(MQA)에서 모델 평균을 크게 앞질렀다는 결과가 나와, 아직 AI가 사람의 현장 경험을 따라잡지 못한 영역이 분명히 존재함을 보여줍니다.
■ 그래서 우리는 무엇을 배워야 할까
AgroBench가 주는 메시지는 명확합니다. 범용 VLM이 아무리 똑똑해 보여도, 특정 산업 도메인의 세밀한 분류 작업에서는 여전히 큰 구멍이 있다는 것입니다. 특히 농업처럼 지역성과 전문성이 강하게 작용하는 분야에서는, 일반 벤치마크 점수만 보고 "이 모델이면 현장에 바로 쓸 수 있겠다"고 판단하는 것이 위험할 수 있습니다. 앞으로 농업용 AI를 개발하려는 연구자나 기업이라면 잡초처럼 시각적으로 미묘한 카테고리를 별도로 강화 학습하거나, 지역별 잡초 데이터셋을 추가로 확보하는 전략이 필요해 보입니다. 동시에 이 논문은 벤치마크 설계 자체의 모범 사례이기도 합니다. 전문가 검수를 거친 데이터, 실생활 밀착형 질문, 세분화된 태스크 구성은 앞으로 다른 산업 도메인 벤치마크를 만들 때도 참고할 만한 틀을 제시합니다. AI가 진짜로 밭에서 쓸모 있으려면, 화려한 데모 영상보다 이런 꼼꼼한 벤치마크가 먼저 필요하다는 사실을 AgroBench는 조용히, 그러나 분명하게 보여줍니다.
댓글