들어가며: 수학 증명에도 "자동완성"이 있다면
수학 정리를 컴퓨터로 검증하는 "정리증명기(theorem prover)"라는 분야가 있습니다. 그중 Lean은 최근 몇 년간 수학자와 AI 연구자 모두에게 가장 주목받는 도구입니다. 거대한 수학 라이브러리 Mathlib을 기반으로, 사람이 작성한 증명을 한 줄 한 줄 컴퓨터가 논리적으로 검증해줍니다. 문제는 이 과정이 너무 느리고 지루하다는 점입니다. "이 명제는 자명하다"고 사람 눈에는 뻔히 보이는 한두 줄짜리 증명 공백도, Lean 안에서는 수십 개의 보조정리(lemma) 중 정확히 어떤 것을 어떤 순서로 꺼내 써야 하는지 일일이 지정해야 합니다.
이런 지루한 틈새를 자동으로 메워주는 도구를 수학 자동화 커뮤니티에서는 "해머(hammer)"라고 부릅니다. Isabelle이나 HOL 같은 다른 정리증명기에는 이미 성숙한 해머 도구들이 있었지만, Lean에는 이를 받쳐줄 핵심 부품, 즉 "지금 이 증명 상황에서 어떤 보조정리를 써야 할지 추천해주는" 전제 선택(premise selection) 모델이 마땅치 않았습니다. ICLR 2026에 발표된 논문 "Premise Selection for a Lean Hammer"(arXiv:2506.07477)는 바로 이 빈틈을 채워, Lean을 위한 최초의 엔드투엔드 범용 해머인 LeanHammer를 완성한 연구입니다(출처: arXiv:2506.07477).
핵심 아이디어: "지금 필요한 보조정리"를 신경망이 추천한다
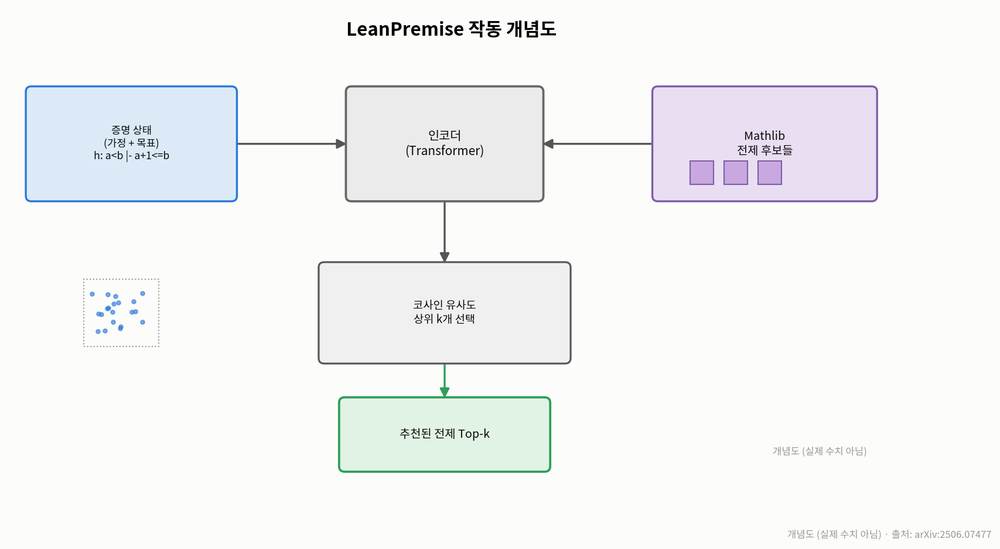
논문이 제안하는 핵심 모델의 이름은 LeanPremise입니다. 쉽게 말하면, 지금 풀고 있는 증명 상태(이미 알고 있는 가정과 증명해야 할 목표)를 입력으로 받아서, Mathlib에 쌓여 있는 수십만 개의 기존 정리와 정의 중 "지금 당장 도움이 될 만한" 것들을 순위를 매겨 추천해주는 검색 엔진입니다(출처: arXiv:2506.07477).
구조적으로는 인코더 전용 트랜스포머(encoder-only transformer)를 사용해 증명 상태와 각 전제(보조정리)를 각각 벡터로 임베딩한 뒤, 두 벡터의 코사인 유사도가 높은 순서로 상위 k개를 뽑는 방식입니다(출처: arXiv:2506.07477). 논문은 크기가 다른 세 가지 버전을 학습시켰는데, 가장 작은 모델은 MiniLM-L6(약 2300만 파라미터), 중간은 MiniLM-L12(약 3300만 파라미터), 가장 큰 모델은 DistilRoBERTa 기반(약 8200만 파라미터)입니다(출처: arXiv:2506.07477). 실제 서비스 시에는 FAISS라는 고속 벡터 검색 라이브러리를 이용해 CPU에서도 약 1초 내외로 추천을 끝낼 수 있다고 합니다(출처: arXiv:2506.07477).
학습 방식에서 눈여겨볼 부분은 "마스크된 대조 손실(masked contrastive loss)"입니다. 보통 대조 학습(contrastive learning)에서는 배치 안에서 정답이 아닌 것들을 모두 "오답(negative)"으로 취급하는데, 수학 전제처럼 서로 의미가 겹치는 보조정리가 많은 상황에서는 이 방식이 진짜 쓸모 있는 전제를 억울하게 오답 취급해버리는 문제가 생깁니다. 논문은 배치 내에서 실제로 정답에 해당하는 전제들을 마스킹 처리해 이런 "잘못된 벌점"을 방지하는 손실 함수를 설계했습니다(출처: arXiv:2506.07477).
LeanPremise 혼자가 아니다: LeanHammer 파이프라인
전제를 잘 추천하는 것만으로는 증명이 끝나지 않습니다. 추천된 전제들을 가지고 실제로 "증명을 완성"해야 하죠. 이를 위해 LeanHammer는 세 단계로 구성된 파이프라인을 돌립니다(출처: arXiv:2506.07477).
첫째, Aesop이라는 기존 Lean 증명 탐색 도구를 먼저 돌려봅니다. 이때 LeanPremise가 추천한 전제들을 Aesop이 시도해볼 규칙으로 추가해줍니다. 둘째, 여기서 못 풀면 Lean-auto라는 번역기를 이용해 Lean의 복잡한 "종속 타입 이론(dependent type theory)" 문제를 더 단순한 고계 논리(higher-order logic) 형태로 바꾼 뒤, Zipperposition이라는 외부 자동정리증명기(ATP)에 넘겨 증명을 시도합니다. 셋째, Zipperposition이 증명을 찾으면 그 결과를 Duper라는 도구를 이용해 다시 Lean이 받아들일 수 있는 정식 증명으로 재구성합니다(출처: arXiv:2506.07477). 비유하자면, LeanPremise는 "어떤 도구를 공구함에서 꺼낼지" 추천하는 역할이고, 나머지 파이프라인은 그 도구를 실제로 사용해서 작업을 완성하는 조립 라인인 셈입니다.
학습 데이터를 다시 만들다: "해머에 맞는" 데이터 추출
이 논문에서 또 하나 중요한 기여는 모델 구조 자체보다 학습 데이터를 어떻게 뽑아냈는가에 있습니다. 기존의 Lean 전제 선택 연구들은 보통 "다음 전술(tactic)을 예측"하는 방식의 학습 데이터를 재활용했는데, 이는 해머의 작동 방식과는 다소 결이 다릅니다. 해머는 증명이 끝난 시점에 실제로 어떤 전제가 쓰였는지, 그리고 명시적으로 호출되지 않았더라도 simp나 rw 같은 전술 내부에서 암묵적으로 활용된 정의/보조정리까지 포함해서 학습해야 더 실전에 가깝습니다(출처: arXiv:2506.07477). 이를 위해 저자들은 Mathlib에서 약 20만 6000개의 증명으로부터 약 47만 개의 증명 상태를 추출했고, 최종적으로 약 26만 5000개의 전제 후보와 약 580만 개의 (상태, 전제) 학습 쌍을 구축했습니다(출처: arXiv:2506.07477).
성능은 얼마나 좋아졌나: 숫자로 보는 결과
논문의 핵심 실험은 Mathlib에서 추출한 테스트셋 500개 정리를 대상으로 진행되었습니다. 비교 대상은 기존 기호 기반 전제 선택기인 MePo, 역시 기호 기반인 랜덤 포레스트, 그리고 신경망 기반이지만 해머용으로 설계되지 않았던 ReProver였습니다(출처: arXiv:2506.07477).
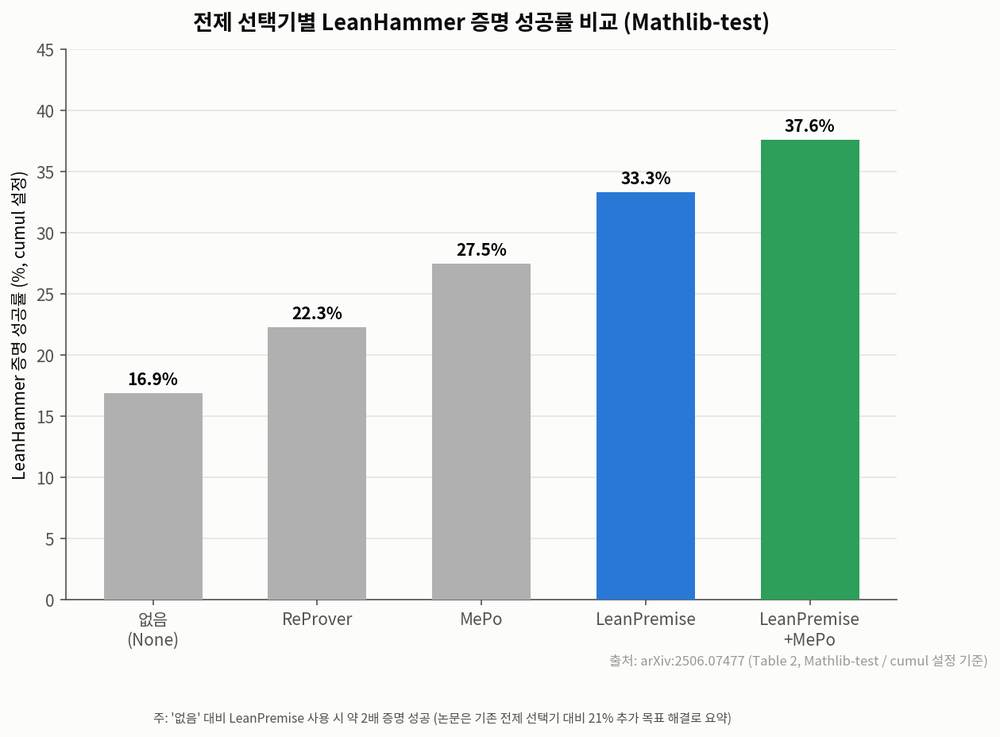
결과를 보면, 가장 큰 LeanPremise 모델은 상위 32개 전제 안에 정답 전제가 포함될 확률(Recall@32)에서 72.7%를 기록해, MePo의 42.1%, ReProver의 38.7%를 크게 앞섰습니다(출처: arXiv:2506.07477). 실제 증명 성공률로 보면, 모든 파이프라인 단계를 누적 적용한 설정에서 LeanHammer는 33.3%의 목표를 해결했는데, 이는 전제 선택을 아예 쓰지 않았을 때(16.9%)의 약 두 배에 해당합니다(출처: arXiv:2506.07477). 논문이 전체 요약에서 강조하는 "기존 전제 선택기 대비 21% 더 많은 목표 해결"이라는 수치는 이런 비교들을 종합한 대표 수치로 제시된 것입니다(출처: arXiv:2506.07477).
더 흥미로운 부분은 Mathlib 바깥의 낯선 수학 영역, 즉 miniCTX-v2라는 벤치마크(Carleson, ConNF, FLT, HepLean 등 서로 다른 전문 수학 분야 모음)에서도 성능이 크게 꺾이지 않았다는 점입니다. 정답 전제를 모두 알려줬을 때의 증명률을 100%로 놓고 비교하면, LeanPremise는 Mathlib 테스트셋에서는 정답 대비 약 73.5%, 완전히 새로운 miniCTX-v2 영역에서는 약 79.4% 수준의 상대 성능을 유지했습니다(출처: arXiv:2506.07477). 훈련 때 보지 못한 라이브러리나 사용자 정의 보조정리가 등장해도 품질이 떨어지지 않는 것은, LeanPremise가 매번 전제 집합을 새로 임베딩해 동적으로 대응하도록 설계됐기 때문입니다(출처: arXiv:2506.07477).
왜 아직 모든 증명을 풀지는 못할까: 한계와 실패 분석
논문은 스스로의 한계도 투명하게 분석합니다. 정답 전제를 알려준 상황에서도 실패하는 사례를 분해해보면, 약 21.7%는 Lean의 종속 타입 이론 특유의 표현을 고계 논리로 번역하는 Lean-auto 단계에서부터 막히고, 약 43.6%는 Zipperposition이 필요한 증명을 끝내 찾지 못하는 경우였습니다(산술 연산이나 귀납법처럼 외부 ATP가 원래 서투른 영역). 증명은 찾았지만 Lean 형식으로 재구성하는 데 실패하는 경우도 약 1.6% 존재했습니다(출처: arXiv:2506.07477). 저자들은 "LeanHammer는 본질적으로 한두 줄짜리 작은 증명 공백을 메우기 위한 도구이며, 귀납법이나 복잡한 산술 추론이 필요한 증명, 혹은 여덟 개 이상의 전제가 동시에 필요한 증명은 설계상 범위 밖"이라고 분명히 밝히고 있습니다(출처: arXiv:2506.07477).
정리하며
"Premise Selection for a Lean Hammer"는 화려한 신규 아키텍처보다는, 실제로 쓰이는 도구를 완성하기 위해 무엇이 빠져 있었는지를 정확히 짚어내고 메운 실용적인 연구입니다. 증명 상태와 전제를 함께 임베딩하는 아이디어 자체는 새롭지 않지만, 해머라는 최종 사용 목적에 맞춰 학습 데이터 추출 방식과 손실 함수를 다시 설계하고, 이를 번역-외부증명-재구성이라는 기존 파이프라인에 실제로 연결해 Lean 최초의 엔드투엔드 범용 해머를 완성했다는 점에서 의미가 큽니다(출처: arXiv:2506.07477). 수학 정리증명 자동화가 아직 완전한 "증명 기계"는 아니지만, 사람이 일일이 채워야 했던 지루한 한두 줄의 틈을 AI가 대신 메워준다는 것만으로도, 형식 수학을 연구하는 사람들의 하루하루는 꽤 달라질 것입니다.
댓글