들어가며: "커널 하나 짜는 데 한 달"이라는 현실
대규모 언어모델을 학습하거나 서빙해본 엔지니어라면 누구나 한 번쯤 겪는 문제가 있습니다. 모델 구조는 수식으로 보면 단순한데, 그걸 GPU에서 빠르게 돌아가게 만드는 "커널(kernel)" 코드는 전혀 단순하지 않다는 것입니다. 타일을 DRAM에서 SRAM으로 옮기고, 그 위에서 연산을 수행하는 패턴 자체는 명확하지만, 스레드 바인딩, 메모리 레이아웃, 텐서코어 활용, 파이프라이닝 같은 하드웨어 디테일까지 손으로 최적화하려면 전문가도 몇 주씩 매달려야 합니다(출처: arXiv:2504.17577).
ICLR 2026에 Oral로 선정된 논문 "TileLang: A Composable Tiled Programming Model for AI Systems"(arXiv:2504.17577)은 이 간극을 메우려는 시도입니다. 흥미롭게도 이 논문은 카메라레디 과정에서 제목이 "TileLang: Bridge Programmability and Performance in Modern Neural Kernels"에서 현재 제목으로 바뀌었는데, 다루는 내용과 저자진은 동일합니다. 참고로 이번 포스트를 끝으로 ICLR 2026 논문 시리즈의 전반부(#321~#330) 정리가 마무리됩니다.
핵심 아이디어: "무엇을 계산할지"와 "어떻게 빠르게 돌릴지"를 분리한다
TileLang이 제안하는 핵심은 간단합니다. 커널 작성을 데이터플로우(dataflow)와 스케줄링(scheduling)이라는 두 개의 축으로 완전히 분리하는 것입니다(출처: arXiv:2504.17577). 개발자는 "어떤 타일을 어디서 가져와 어떤 연산을 수행하는지"만 고수준 파이썬 문법으로 기술하면 되고, 스레드 바인딩(thread binding), 메모리 레이아웃(layout), 텐서코어 활용(tensorize), 파이프라이닝(pipeline) 같은 저수준 최적화는 컴파일러가 담당하는 "커스터마이징 어노테이션과 프리미티브" 집합으로 분리해 처리합니다(출처: arXiv:2504.17577).
실제 코드 수준에서는 T.copy, T.gemm, T.reduce, T.atomic 같은 타일 단위 연산자로 데이터플로우를 기술하고, T.alloc_shared나 T.alloc_fragment 같은 프리미티브로 공유 메모리·레지스터 파일 같은 하드웨어 메모리 공간을 명시적으로 할당합니다(출처: arXiv:2504.17577). 즉 CUDA를 밑바닥부터 짜는 것과 Triton·PyTorch처럼 완전히 고수준으로 추상화된 것 사이의 "중간 지점"을 노리는 설계입니다.

레이아웃 추론과 자동 파이프라이닝: 전문가의 손길을 컴파일러로
TileLang이 단순한 DSL 문법 이상의 가치를 가지는 지점은 "레이아웃 추론 패스(Layout Inference Pass)"입니다. 이 패스는 버퍼 연산을 GPU 스레드에 매핑하는 과정을 자동으로 처리하면서도, 전문가가 원할 경우 명시적으로 스레드를 제어할 수 있는 여지를 남겨둡니다(출처: arXiv:2504.17577). 또한 뱅크 충돌(bank conflict)을 줄이기 위한 "레이아웃 스위즐링(Layout Swizzling)"과 레지스터 파일을 스레드 간에 분할하는 "프래그먼트 레이아웃(Fragment Layout)"도 지원합니다(출처: arXiv:2504.17577).
텐서코어 활용(tensorization) 측면에서는 세 가지 경로를 제공합니다. C++ 소스를 직접 주입하는 T.import_source, PTX를 직접 방출하는 T.ptx, 그리고 NVIDIA CUTLASS나 AMD Composable Kernel 같은 "타일 라이브러리"를 연동하는 방식입니다. 커널 설정에 따라 컴파일러가 이 중 최적의 구현을 자동으로 선택합니다(출처: arXiv:2504.17577). 파이프라이닝 역시 T.Pipelined라는 프리미티브로 연산 블록 간 의존성을 자동 분석해, 메모리 전송과 연산을 자동으로 오버랩시키는 소프트웨어 파이프라인 추론 메커니즘을 갖추고 있습니다(출처: arXiv:2504.17577). 컴파일러 자체는 파서, IR 빌더, 최적화, 코드 생성으로 이어지는 5단계 파이프라인이며 TVM 인프라 위에서 동작하고, LLVM IR·CUDA C/C++·HIP C/C++ 세 가지 백엔드로 코드를 생성합니다(출처: arXiv:2504.17577).
성능 평가: NVIDIA와 AMD 양쪽에서 검증하다
저자들은 NVIDIA H100(80GB), A100(80GB), RTX 4090과 AMD Instinct MI300X(192GB)까지 서로 다른 아키텍처의 디바이스에서 TileLang을 검증했습니다(출처: arXiv:2504.17577). 벤치마크 대상 커널은 GEMM(행렬곱), 멀티헤드 어텐션(MHA)/FlashAttention, 선형 어텐션(Mamba-2 계열의 chunk-scan/chunk-state), 멀티헤드 잠재 어텐션(MLA), 그리고 INT4·INT2·NF4 포맷의 weight-only 역양자화(dequantization) 커널입니다(출처: arXiv:2504.17577).
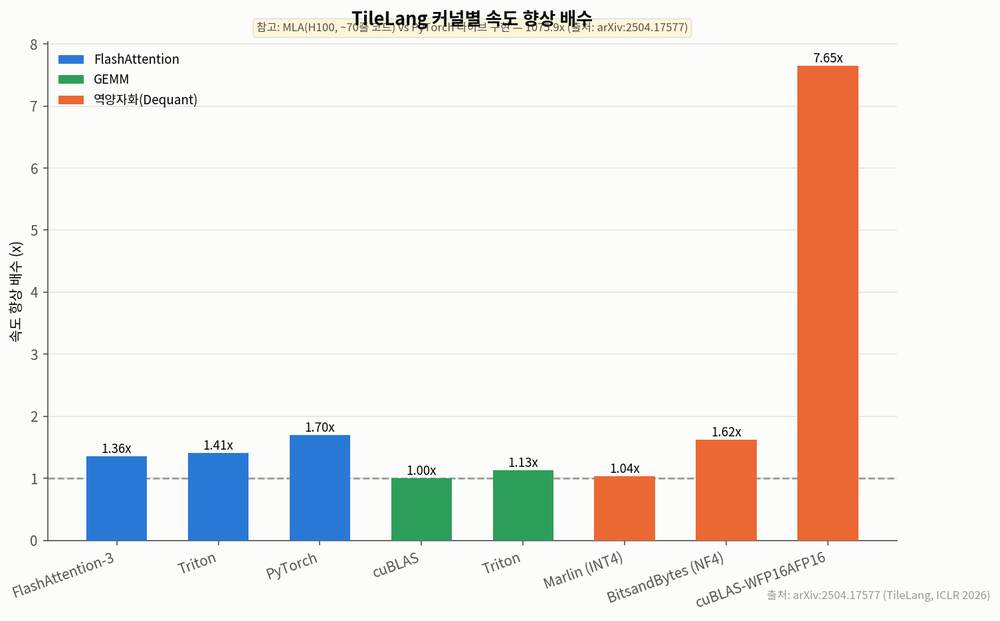
구체적인 수치를 보면, FlashAttention 커널에서 TileLang은 FlashAttention-3, Triton, PyTorch 대비 각각 1.36배, 1.41배, 1.70배의 속도 향상을 보였습니다(출처: arXiv:2504.17577). 선형 어텐션에서는 Triton 대비 chunk-scan·chunk-state 함수에서 평균 1.77배와 2.10배 빨랐습니다(출처: arXiv:2504.17577). GEMM의 경우 H100에서 cuBLAS 대비 1.00배(동등한 수준), Triton 대비 1.13배의 성능을 기록했습니다(출처: arXiv:2504.17577). 역양자화 커널에서는 INT4 포맷 기준 전문 커널인 Marlin 대비 1.04배, NF4 포맷에서는 BitsandBytes 대비 1.62배였고, cuBLAS의 WFP16AFP16 조합과 비교했을 때는 최대 7.65배의 속도 향상이 보고되었습니다(출처: arXiv:2504.17577).
가장 눈에 띄는 수치는 MLA(Multi-Head Latent Attention) 커널입니다. H100에서 약 70줄의 파이썬 코드만으로 작성한 TileLang 구현이 PyTorch 대비 1075.9배의 속도 향상을 달성했다고 보고되었습니다(출처: arXiv:2504.17577). 다만 이 비교 대상인 PyTorch 구현이 전용 최적화가 거의 없는 나이브(naive) 버전일 가능성이 높다는 점은 감안해서 봐야 합니다.
왜 이 논문이 주목받는가: Oral 선정의 의미
TileLang이 ICLR 2026에서 Oral로 선정된 것은, 단순히 빠른 커널 하나를 만든 게 아니라 "커널 성능 최적화의 전문성"을 컴파일러 인프라로 체계화했다는 점이 평가받았기 때문으로 보입니다. 기존의 도메인 특화 컴파일러들이 사용성과 표현력 사이에서 타협점을 찾지 못했던 것과 달리(출처: arXiv:2504.17577), TileLang은 통합된 블록-스레드(block-and-thread) 패러다임과 투명한 스케줄링 능력으로 두 마리 토끼를 잡으려 한다는 점이 핵심 기여로 제시됩니다(출처: arXiv:2504.17577).
실용적 관점에서도 의미가 큽니다. GEMM, FlashAttention, Mamba-2, MLA, 저비트 역양자화까지 최신 LLM 아키텍처에서 실제로 쓰이는 핵심 연산 전반을 커버하면서, NVIDIA와 AMD 양쪽 생태계에서 동시에 검증했다는 점은 특정 벤더에 종속되지 않는 범용 커널 프로그래밍 모델로서의 실용성을 뒷받침합니다.
한계와 전망
다만 논문이 공개한 정보만으로는 몇 가지 유보할 지점도 있습니다. 비교 기준이 된 베이스라인 구현(특히 MLA의 PyTorch 버전)의 최적화 수준이 공정하게 맞춰졌는지는 추가 검증이 필요하며, 데이터플로우와 스케줄링을 분리하는 추상화가 완전히 새로운 커널 유형(예: 희소 연산, 그래프 기반 연산)에도 동일하게 잘 적용될지는 더 지켜봐야 할 부분입니다. 또한 레이아웃 추론이 자동으로 "충분히 좋은" 결과를 내지 못하는 극단적 케이스에서 전문가가 개입해야 하는 비용이 얼마나 되는지도 논문만으로는 가늠하기 어렵습니다.
그럼에도 TileLang은 "커널 작성자가 알고리즘에 집중하고, 컴파일러가 하드웨어를 책임진다"는 방향성을 상당히 설득력 있는 수치로 뒷받침한 사례입니다. AI 시스템 최적화가 점점 더 많은 연구자와 엔지니어에게 요구되는 지금, 이런 생산성 도구의 발전은 모델 연구와 시스템 최적화 사이의 장벽을 낮추는 데 실질적으로 기여할 것으로 보입니다.
마치며: ICLR 2026 전반부 시리즈를 마무리하며
TileLang은 "표현력"과 "성능"이라는, 지금까지 AI 커널 프로그래밍에서 양립하기 어려웠던 두 가치를 데이터플로우-스케줄링 분리라는 단순하지만 강력한 아이디어로 동시에 잡으려 한 시도였습니다. 이것으로 ICLR 2026 논문 리뷰 시리즈의 전반부(#321~#330) 10편이 모두 마무리되었습니다. 다음 편부터는 후반부 논문들을 이어서 다루겠습니다.
댓글